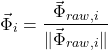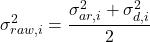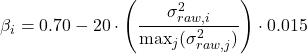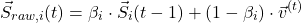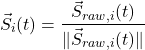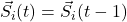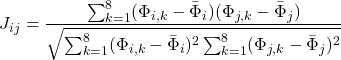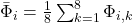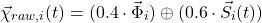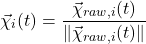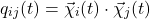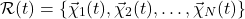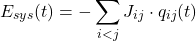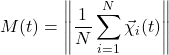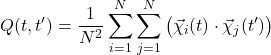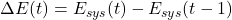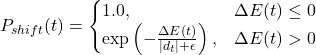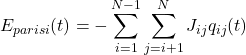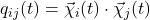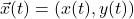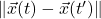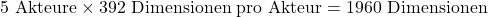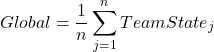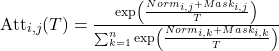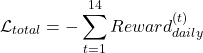Collective Mind Theorie V: Parisi’s Ordnungsparameter revisited: Dilts-Glas Organisation

Kurzfassung: Parisi’s Ordnungsparameter eröffnet eine neue Perspektive auf die Dynamik von Teams und Organisationen. Die Collective Mind Theory überträgt dafür Konzepte aus der Physik der Spin-Gläser auf soziale Beziehungsnetzwerke. Wie in einem Spin-Glas können widersprüchliche Interessen und Persönlichkeiten zu ‚frustrierten‘ Konfliktmustern führen. Der aus vorherigen Blog-Beiträgen bekannte Markus-Lanz-Diskurs dient als Fallbeispiel mit 100 analysierten Gesprächs-Turns. Eine Parisi-inspirierte Overlap-Matrix (Ordnungsparameter) macht sichtbar, wie stark sich Systemzustände im Zeitverlauf ähneln. Besonders interessant ist die erkennbare Trennung verschiedener Diskursregime. In vorherigen Blog-Beiträgen wurde bei einem Turn eine starke Diskurs-Disruption identifiziert, die mit einem Wechsel der Systemstruktur zusammenfällt. Der anschließende Übergang vom Regime ‚Identitätskampf‘ zum Regime ‚Sachdebatte‘ erscheint als besonders dynamischer Phasenwechsel. Ein hierarchisches Energie-Clustering ordnet die Turns dabei überraschend klar den zuvor definierten Regimen zu. Die Energielandschaft beschreibt Konfliktmuster als stabile ‚Täler‘ und Übergänge als energetisch anspruchsvolle Passagen. Das Regime ‚Agenda-Setting‘ erscheint dabei nicht als entspannter Zustand, sondern als dauerhaft aufmerksamer und energieintensiver Zustand. Für Führungskräfte ergibt sich daraus eine provokante These: Transformation braucht einen gezielt harten Impuls (Disruption), um einen Übergang einzuleiten. 
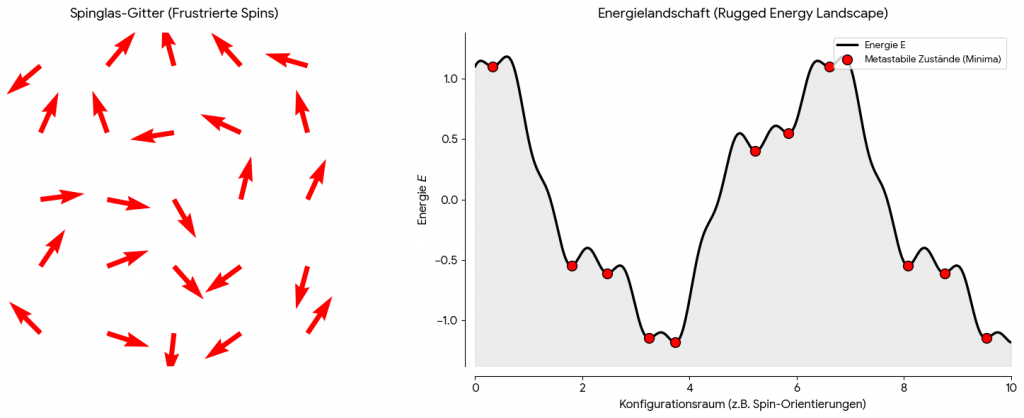
Ein Spin-Glas, siehe obige Abbildung – links, beschreibt ein Material, in dem atomare Magnete (Spins) durch unvereinbare geometrische und magnetische Kräfte in einen unlösbaren Konflikt geraten. Spin-Gläser wurden in magnetischen Metalllegierungen entdeckt.

Das physikalische Schlüsselwort für dieses Phänomen lautet Frustration. Wenn Spin A sich an Spin B ausrichten will, B an C, aber C sich gezwungenermaßen gegen A stellt, gibt es keine perfekte Lösung. Das System kann sich nicht in einem einzigen globalen Gleichgewicht entspannen. Stattdessen friert es in einer hochkomplexen, zerklüfteten Energielandschaft (siehe obige Abbildung – rechts, eine sehr vereinfachte Darstellung) ein. Diese Energielandschaft ist ein hochdimensionales Gebirge voller tiefer Täler und hoher Barrieren. Für die mathematische Entschlüsselung dieser verborgenen Ordnung, dem sogenannten Replica Symmetry Breaking (RSB), erhielt der Physiker Giorgio Parisi 2021 den Physik-Nobelpreis [1]. Erstmals habe ich im Blog-Beitrag ‚Metabetrachtungen: Zur Schnittmenge von diesjährigem Physik-Nobelpreis, Künstlicher Intelligenz und Collective Mind‘ vom Oktober 2021 auf die Bedeutung der Spin-Gläser für KI-Systeme und die Collective Mind Theorie (CMT) hingewiesen. Gerade als ich diesen Beitrag schreibe, hat das Quanta Magazin den Beitrag ‚The strange physics that gave birth to AI‘ herausgebracht, in dem die enorme Bedeutung des ‚Toy Models‘ Spin-Glas für das Design und Verstehen von KI-Systemen skizziert wird. – Im Jahre 2024 erhielten John Hopfield und Geoffrey Hinton den Physik-Nobelpreis für ihre Grundlagenforschung zu künstlichen neuronalen Netzwerken. Die Erkenntnisse zu Spin-Gläsern spielten hierbei eine wichtige Rolle.

In der CMT werden Spins durch Dilts Pyramiden ersetzt. Deshalb spreche ich auch im Titel dieses Blog-Beitrages von Dilts-Glas Organisation. Die Dilts Pyramide ist ein Modell für die Persönlichkeit eines Menschen oder die Kultur einer Organisation. Im verwendeten mathematischen Formalismus wird die Dilts Pyramide als hochdimensionaler Vektor umgesetzt (siehe Anhang 1). Damit ergibt sich ein unmittelbarer Bezug von Dilts-Glas zu Spin-Glas. – Ich nehme zentrale Erkenntnisse dieses Zusammenhangs hier vorweg:
  • Soziale Frustration: Ein menschlicher Diskursraum ist niemals konfliktfrei. Unterschiedliche kognitive Strukturen (u.a. Big Five) , v-Memes und Sympathien zwingen Teams unweigerlich in komplexe Kompromisse. Niemand bekommt genau das, was er will; das Netzwerk steht permanent unter Spannung.
  • Attraktoren statt Harmonie: Wenn ein Diskurs in ein toxisches Regime ‚Identitätskampf‘ abrutscht, ist das kein kommunikativer Betriebsunfall. Es ist ein physikalisch extrem stabiles Energietal im sozialen Dilts-Glas. Das System hat sich in einem lokalen Minimum verhakt, aus dem es aus eigener Kraft kaum entkommen kann.
  • Transformation durch Disruption: Ein Dilts-Glas verändert seine starre Struktur nicht durch sanftes Zureden. Um ein Team aus einem dysfunktionalen Tal in ein agiles Lösungs-Plateau (das Regime ‚Agenda-Setting‘) zu heben, muss das System buchstäblich erhitzt werden. Es erfordert Disruption und Kausale Kraft, um den Diskurs über die topologische Barriere in ein neues, funktionales Regime zu treiben.
  • Organisationen bewegen sich durch die hochdimensionale Energielandschaft eines Dilts-Glases. Die Topografie der Energielandschaft bestimmt wie ein Team oder eine Organisation sich verhält und damit auch wie diese zu führen sind.
Ich werde im Folgenden die Theorie von Parisi auf ein Team bzw. eine Gruppe von Personen anwenden und verwende wieder, wie in den vorherigen Blog-Beiträgen, die Daten der Markus Lanz TV-Sendung. 

Die bisherigen CMT Ergebnisse sind in vorherigen vier Blog-Beiträgen enthalten:

  • ‚Collective Mind Theory IV: Luhmann & Lacan revisited: Makro-Dynamik bestimmt Mikro-Dynamik?‘ vom August 2026,
  • ‚Gehirn, KI und Collective Mind: Intelligenz basiert, unabhängig vom Substrat, auf den gleichen kollektiven Prinzipien‘ vom Juli 2026,
  • ‚Hybrid Collective Intelligence: Collective Mind Leadership. Theorie der Emergenz‘ vom Juli 2026,
  • ‚Attention Collective Mind III: KI-Assistenz für die Markus Lanz TV-Sendungam 30.04.2024‘ vom Juni 2026

Wir werden sehen, dass die Ergebnisses des aktuellen Blog-Beitrages die vorherigen Ergebnisse teilweise benutzen und ergänzen. Gleichzeitig werden diese auf eine fundamentalere Basis gestellt und die aktuellen Erkenntnisse liefern völlig neue Einsichten. Ich verzichte wieder im Hauptteil des Blog-Beitrages auf die zugrundeliegende, sehr anspruchsvolle Mathematik und verweise auf die Anhänge 1-5.

Die Grundidee von Parisi beruht auf der Beobachtung, dass das gleiche Spin-Glas Material unterschiedliche Eigenschaften zeigt, wenn es unterschiedlichen Rahmenbedingungen ausgesetzt wird.

Aus diesem Grunde hat er ein Gedankenexperiment mathematisch umgesetzt. Er hat sich vorgestellt, dass man unendlich viele mathematische Klone (Replicas) eines realen Spin-Glases erzeugt. Jetzt setzt man diese Replicas unterschiedlichen Rahmenbedingungen (z.B. Umgebungstemperatur) aus. In einem gewöhnlichen System (wie Wasser, das zu Eis friert) kristallisieren alle Replicas am Ende in exakt demselben Zustand. Vergleicht man die Klone miteinander, sind sie ununterscheidbar – es herrscht Symmetrie. Ein Spin-Glas hingegen steht unter maximaler Frustration. Die Atome können sich nicht auf eine einzige harmonische Ordnung einigen. Stattdessen gibt es eine zerklüftete Energielandschaft aus unzähligen, fast gleichwertigen Energietälern. Kühlt das System ab, friert jede Replica zufällig in einem anderen Tal ein. Vergleicht man die Klone nun miteinander, sind sie völlig verschieden. Die anfängliche Gleichheit (Symmetrie) der Replicas ist gebrochen.- Deshalb spricht man von Replica Symmetry Breaking.

In der CMT ist die Replica kein Spin-Glas, sondern das Beziehungsnetzwerk eines Teams oder einer Organisation. – Die festen Persönlichkeitsprofil-Kombinationen bilden die Grundstruktur.  Ich spreche von eine Dilts-Glas Organisation, oder vereinfacht von einem Dilt-Glas. Wenn wir das System zu zwei völlig unterschiedlichen Momenten seiner dynamischen Entwicklung betrachten, schauen wir im Grunde auf zwei zeitliche Replicas exakt desselben Systems: Es sind identische Akteure mit identischen Grundkonflikten, die jedoch unabhängig voneinander durch den Diskursraum wandern. Aufgrund der sozialen Frustration (unterschiedliche Big Five Ausprägungen und Werte, gegensätzliche Interessen) gleicht der Diskursraum dem Gebirge eines Spin-Glases. Symmetriebrechung bedeutet hier: Der Diskurs spaltet sich abrupt in völlig isolierte Regime auf. Eine kleine Disruption oder kognitive Ermüdung reicht aus, und das System fällt in ein spezifisches Tal – etwa in einen toxischen Identitätskampf. Das System bricht strukturell mit seiner Vergangenheit. Es gibt plötzlich keine harmonische Schnittmenge mehr zwischen dem kooperativen Team von gestern und dem festgefahrenen Team von heute.


Ich komme zu den Ergebnissen:
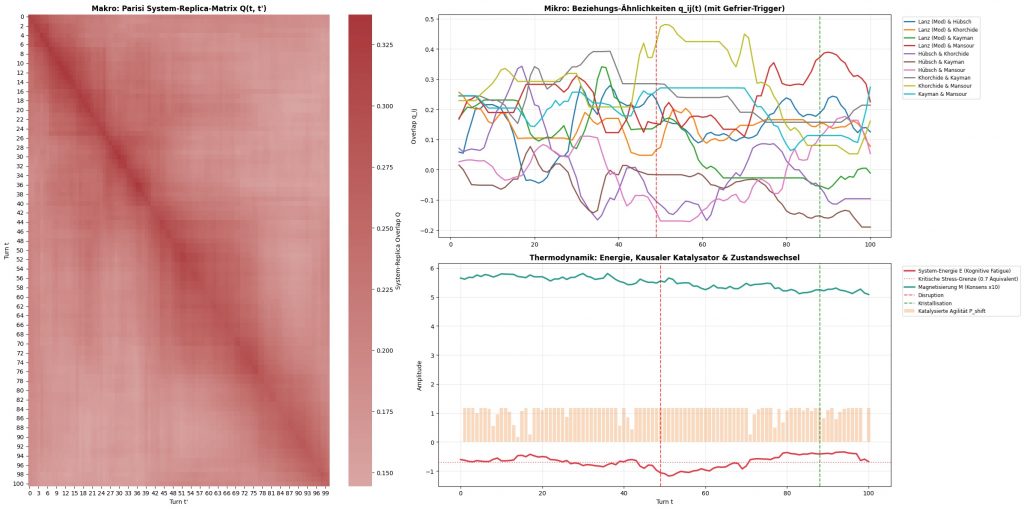
Abbildung 1: Diese Abbildung ist die erste Abbildung von drei Abbildungen, die das bisherige CMT Führungs-Dashboard ergänzt. Alle Ergebnisse beruhen wieder auf  der System-Analyse des Diskurses der Markus Lanz Talkshow über 100 Turns: 

Teil 1: Was wir in den drei Plots der Abbildung sehen

1. Die Makro-Ebene (Links – Parisi System-Replica-Matrix Q(t, t'))

Wir sehen eine große, quadratische Heatmap (100 \times 100 Turns) in rötlichen Abstufungen. Die Matrix Q(t, t') misst den sogenannten Parisi-Overlap, d.h. die strukturelle Ähnlichkeit (Korrelation) des Gruppen-Beziehungsnetzwerkes der TV Runde, also die Ähnlichkeit des Systemzustandes der Replica zum Zeitpunkt t und des Systemzustandes der Replica zum Zeitpunkt t‘. – Dies ist das CMT Äquivalent zum Parisi Ordnungsparameter. Die Farbskala reicht von hellrosa/weiß (niedriger Overlap \approx 0.15) bis zu dunklem Weinrot (hoher Overlap \approx 0.35).
Entlang der Hauptdiagonalen verläuft ein ausgeprägter, dunklerer Streifen, der anzeigt, dass zeitlich benachbarte Turns stark miteinander korrelieren. Besonders auffällig sind blockartige Strukturierungen und Kreuzungspunkte. Für den Betrachter visualisieren diese „Blöcke“ makroskopische Phasenwechsel im Gesamtsystem, die Replica Symmetry Breaking. In der Praxis bedeutet es, dass das Team hier komplett neue Verhandlungsstrukturen aufbaut.

2. Die Mikro-Ebene (Rechts oben – Beziehungs-Ähnlichkeiten q_{ij}(t))

Dieses Liniendiagramm verfolgt die paarweisen Overlaps zwischen den 5 Akteuren (Lanz, Hübsch, Khorchide, Kayman, Mansour) über die 100 Turns. Jede farbige Linie repräsentiert eine spezifische Dyade (Zweier-Beziehung).
Man erkennt starke Divergenzen: Während einige Linien flach verlaufen, brechen andere phasenweise drastisch ein oder schießen nach oben. Zwei vertikale gestrichelte Linien markieren die Meilensteine der Debatte: Rot (die Disruption bei Turn 49) und Grün (die Kristallisation bei Turn 88).

3. Die Thermodynamik-Ebene (Rechts unten – Energie, Magnetisierung & Agilität)

Die rote Kurve (System-Energie E_{sys}): Verläuft im negativen Bereich und zeigt einen markanten Einbruch (eine „Katharsis“) rund um Turn 49, wo sie die rote gestrichelte Linie der kritischen Stress-Grenze (-0.7, siehe vorherige Blog-Beiträge) unterschreitet.
Die türkise Kurve (soziale ‚Magnetisierung‘ M(t) \times 10) misst den sozialen Konsens: Verläuft stabil auf hohem Niveau (bei ca. 5.2 bis 5.8, was einem echten normierten Magnetisierungs-Wert von \approx 0.52 - 0.58 entspricht) mit leichten Dellen in den Konfliktphasen.
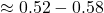
Die orangen Balken (Katalysierte Agilität P_{shift}): Repräsentieren die sprunghafte Wahrscheinlichkeit für einen Systemwechsel. Sie schlagen insbesondere vor und nach der Disruption maximal aus.

Teil 2: Die Brücke zu unseren bisherigen Resultaten

Wenn wir dieses Bild mit unseren bisherigen Erkenntnissen abgleichen, offenbaren sich tiefgreifende Parallelen, die weitere Erkenntnisse liefern:

1. Magnetisierung M(t) vs. Makro-Vision

Die Parallele: Die türkise Kurve der Magnetisierung M(t) zeigt im unteren rechten Panel eine bemerkenswerte Stabilität. Selbst während die Mikro-Dilts-Wechselwirkungen (rechts oben) wild oszillieren und Allianzen zerbrechen, bleibt der globale Konsens-Wert des Raumes relativ konstant hoch.
Die Bedeutung: Eine strukturierte Debatte bricht niemals in ein völlig richtungsloses Chaos (M \to 0) zusammen, weil der institutionelle Kontext (der Moderator Lanz, die gemeinsame Agenda) eine globale Makro-Vision (siehe vorherige Blog-Beiträge) aufrechterhält. Der Raum bleibt magnetisiert, während darunter die Mikro-Allianzen verschoben werden (können).
 
2. Von individuellem Stress zur System-Energie (Der Energie-Sturz bei Turn 49)

Die Parallele: Bisher haben wir den Stresspegel isoliert pro Akteur gemessen. Die rote System-Energie (E_{sys}) fasst diese Kognitive Fatigue nun für den gesamten Raum zusammen. Der tiefste Punkt dieser roten Kurve korreliert exakt mit der gemessenen Disruption (Turn 49) und dem Unterschreiten der kritischen Stress-Grenze.
Die Bedeutung: Ein hoher Stresspegel oder eine harte Disruption werden von Führungskräften oft intuitiv als ’negativ‘ gewertet. Die Dilts-Dynamik beweist hier das Gegenteil: Der tiefe Fall der Kurve zeigt, dass der Schock das System von einer künstlichen, hoch-frustrierten Oberflächenspannung befreit hat. Das System ist entlastet worden und in ein tieferes, thermodynamisch stabileres Energietal gefallen.
 
3. Aggregation, Differentiation und Allianzen

Die Parallele: Bisher hatten wir Aggregatoren und Differentiatoren nur als abstrakten Trend-Index dargestellt. Im rechten oberen Plot (q_{ij}) wird diese Dynamik nun auf Dyaden-Ebene (Zweier-Beziehungen) sichtbar.
Die Bedeutung: Zur Mitte der Debatte stürzen die violette Linie (Hübsch & Khorchide) und die grüne Linie (Lanz & Kayman) tief ins Negative ab. Hier zerbrechen unter dem Druck der Differentiatoren alte Allianzen zusammen. Gegen Ende (ab Turn 88, der grünen Linie) steigt die rote Linie (Lanz & Mansour) markant an. Lanz agiert hier messbar als klassischer Aggregator: Er kühlt das System ab (Kristallisation) und schmiedet eine neue, tragfähige Allianz.
 
4. Kausale Kraft erzwingt Agilität (Die orangen Balken vs. C(t))

Die Parallele: Früher zeigte der D-Score isoliert den rhetorischen Einschlag, während die Kausale Kraft bewies, ob dieser vom Makrosystem überhaupt angenommen wird. Die orangen Agilitäts-Balken (P_{shift}) unten rechts verschmelzen nun beides: Sie treten genau dort geballt auf, wo die kausale Kraft und der D-Score in den vorherigen Modulen Spitzenwerte zeigten.
Die Bedeutung: Sie visualisieren das Fenster der Handlungsfähigkeit. Wenn die kausale Kraft eines Akteurs hoch ist und das System durch den Gefrier-Trigger (unser alter Konsolidierungs-Index fällt unter 41) fluid wird, schießt die Übergangswahrscheinlichkeit P_{shift} auf 1.0. Das Bild unterstützt die Erkenntnis, dass eine Führungskraft hier eingreifen muss, um neue Strukturen zu gießen, solange der Raum noch formbar ist.
 
5. Die Heatmaps im Vergleich

Die Parallele: Die frühere soziale Kopplungs-Matrix (Heatmap der Sprecher-Ähnlichkeiten) lieferte lediglich einen starren Durchschnitt über die ganze Sendung. Das große linke Makro-Panel (Q) zeigt hingegen die fließende Evolution: Das sichtbare „Fadenkreuz“ rund um Turn 49 teilt die Debatte in zwei völlig unterschiedliche Epochen. Das Team nach der Disruption ist strukturell ein anderes als davor.
 
Zwei wesentliche Erkenntnisse lassen sich nicht direkt überlagern und ergänzen das Modell als eigenständige Säulen:

Semantische Makro-Regimes: Die Identifikation inhaltlicher Themenwechsel (wie der Sprung vom ‚Identitätskampf‘ zur ‚Sachdebatte‘) bleibt exklusiv Teil der vorherigen kausalen Auswertung. Das Dilts-Modell misst die Kräfte und Spannungen, ‚liest‘ aber nicht die inhaltlichen Themen.
Die Magnetisierung (M): Sie ist ein absolutes Novum des Dilts-Glas-Modells. Sie zeigt den globalen Konformitäts-Druck an, der mit den vorherigen Größen nicht erfasst wurde.
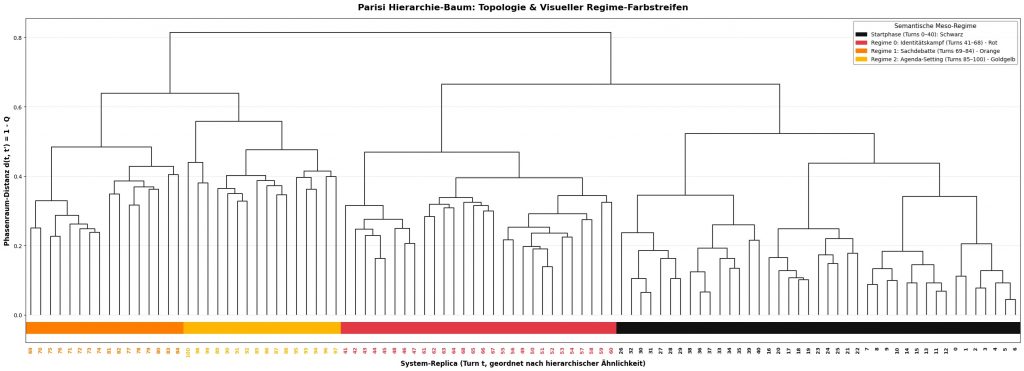
 
Auf Abbildung 2 bin ich besonders stolz: Nach der RSB Theorie zeigen die Energietäler der Energielandschaft eine mathematische Verwandtschaft.- Ich verweise auf Anhang 4 für die mathematische Definition dieser Verwandtschaft. Der Verwandtschaftsgrad jedes einzelnen Turns lässt sich in einem ‚Familien‘- Baum der Turns darstellen. Das besondere hierbei ist, dass die mit dem RSB Modell ermittelte Verwandtschaft zu den Regimen 0, 1 und 2 passt.
 
Abbildung 2: Der Parisi-Hierarchie-Baum mit Zuordnung zu den drei Regimen Identitätskampf, Sachdebatte und Agenda-Setting der vorherigen Blog-Beiträge. Man beachte: Die Reihenfolge der Regime auf der x-Achse ist umgekehrt zu deren zeitlicher Reihenfolge. – Der Grund liegt in der Umsetzung durch die Plot-Routine für den Baum. – Sollte jemand den Quanta-Artikel lesen, so findet sich dort als Eingangsbild ein stilisierter Parisi-Hierarchie-Baum.
 
Der Clustering-Algorithmus, der diesen Baum gebaut hat, kannte die Farben und die zeitliche Reihenfolge überhaupt nicht. Er hat ausschließlich auf Basis der Ordnungsparameter-Matrix Q(t, t') (d.i. die Matrix der strukturellen Ähnlichkeit der Replicas) gerechnet (siehe Anhang 4). Dass sich die farbigen Blöcke am unteren Rand nun so sauber und trennscharf in eigenständige Äste sortieren, ist das Besondere und gleichzeitig das Nicht-Besondere – Vorausgesetzt die bisherigen Modelle und Ergebnisse passen zu den neuen Ergebnissen. – Was sie tun!

Hier ist die detaillierte Interpretation dieses Ergebnisses:

1. Die perfekte Entflechtung

Man betrachte den Farbstreifen am unteren Rand und wie sich die Äste darüber verzweigen:

Der schwarze Block (Startphase, Turns 0–40, ganz rechts in der Abbildung): Sitzt komplett geschlossen auf der rechten Seite des Baumes. Die Struktur der ersten 40 Turns bildet eine in sich geschlossene, homogene Verwandtschaftsgruppe.
Der rote Block (Identitätskampf, Turns 41–68): Bildet den großen zentralen Ast. Er ist zwar mathematisch nah mit der Startphase verwandt (beide teilen sich einen gemeinsamen Vorfahren-Ast in der rechten Hälfte), bildet aber ein eigenes, klar abgetrenntes Energietal. Das ist das toxische, erstarrte Frustrationstal der Debatte.
Der orange-gelbe Block (Sachdebatte & Agenda-Setting, Turns 69–100): Versammelt sich vollständig auf der linken Hauptseite des Baumes.

2. Der Master-Split (bei d \approx 0.82)

Ganz oben am Hauptstamm (bei einer Phasenraum-Distanz von über 0.8) teilt sich der gesamte Diskurs in zwei unvereinbare Welten:
Rechts (Schwarz + Rot): Die Welt des Abtastens und des harten Identitätskampfes.
Links (Orange + Gold): Die Welt nach der ‚Katharsis‘ – die konstruktive Sachdebatte und das finale Agenda-Setting.
Die Bedeutung: Die Distanz von 0.82 an der Wurzel zeigt, dass das System nach der Disruption (Turn 49) einen irreversiblen Phasenübergang vollzogen hat. Der Diskurs ist phasenraum-technisch so weit von seinem Startpunkt entfernt, dass er zu keinem Zeitpunkt in die alte Struktur (Schwarz oder Rot) zurückkehrt. Es gibt keinen Weg „zurück auf Anfang“.

3. Die Brücke zwischen Orange und Gelb

Man siehe sich ganz genau die linke Seite des Baumes (Orange und Gelb) an:

Die orangefarbenen Turns (Sachdebatte) und die gelben Turns (Agenda-Setting) sind im Baum eng miteinander verbunden.
Die Interpretation: Anders als der harte, schockartige Sprung von Schwarz/Rot nach Orange zeigt der Übergang von der Sachdebatte zum Agenda-Setting eine hohe innere Verwandtschaft. Wenn ein Team erst einmal das toxische Energietal (Rot) verlassen hat und in der Sachdebatte (Orange) angekommen ist, erfolgt der Übergang zur echten Lösungsfindung (Gelb) fast von alleine, weil die topologische Barriere im Phasenraum dort viel niedriger ist (kürzere Äste, geringere Distanzen d < 0.3).

Fazit

„Teams bewegen sich nicht auf einer flachen Zeitlinie, sondern durchwandern topologische Energietäler. Ein toxischer Identitätskampf (Rot) ist eine topologische Sackgasse. Man kann ihn nicht durch ‚guten Willen‘ weglächeln; man muss das System durch einen harten Impuls (Disruption) in ein völlig neues Phasenraum-Tal (Orange/Gelb) führen. Erst wenn die Struktur bricht, öffnet sich der Raum für echte Agilität.“
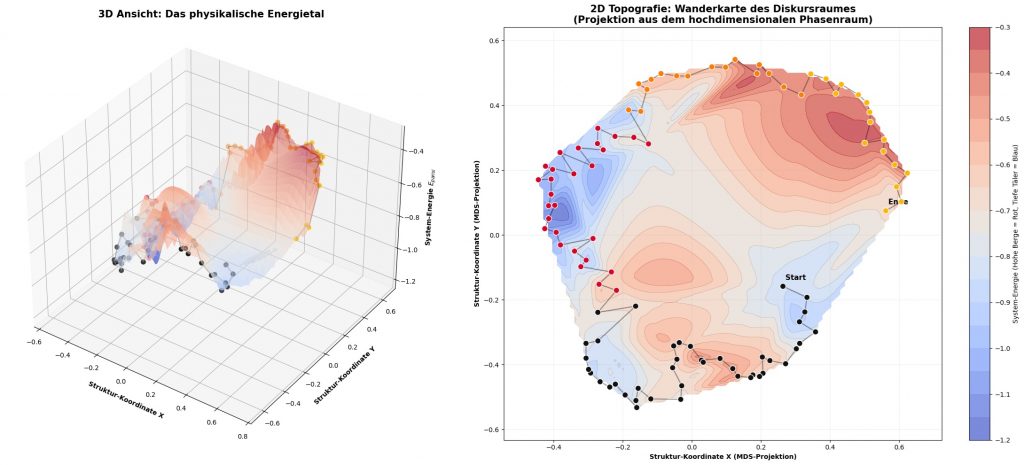
 
 
Abbildung 3 zeigt die Energie der Replicas in einem reduzierten Phasenraum mit 3 bzw. 2 Dimensionen

Abbildung 3 zeigt die Energielandschaft der Replicas einmal links als 3D Plot und rechts als 2D Plot Draufsicht

Die Plots stellen Abbildungen aus dem hochdimensionalen Phasenraum der Replicas dar, der 1960 Dimensionen hat. 
Der 1960-dimensionale Vektorraum beschreibt den kombinierten mathematischen Gesamtzustand des gesamten Systems zu einem spezifischen Zeitpunkt t
Die Grafiken offenbaren eine fundamentale Erkenntnis über soziale Systeme: Sie verändern sich nicht kontinuierlich, sondern fallen in stabile Zustände (Attraktoren) und können nur durch massiven Energieaufwand (Spannung/Stress) in neue Zustände geführt werden.

Hier ist die genaue physikalische und systemtheoretische Interpretation dieser Karte:

1. Die Farblogik der Topografie (Täler vs. Berge)

Um die Karte richtig zu lesen, müssen wir die Thermodynamik dahinter festhalten:
  • Blaue Zonen (Täler): Hier ist die System-Energie E_{parisi} am niedrigsten. Das bedeutet hohe strukturelle Stabilität. Das System hat eine feste Symmetrie gefunden (Allianzen stehen fest). Es ist ein Attraktor, in dem das System gerne verweilt.
  • Rote Zonen (Berge/Kämme): Hier ist die Energie extrem hoch. Das bedeutet maximale Frustration, kognitive Ermüdung und strukturelle Instabilität. Niemand hält es hier lange aus. Es sind die Übergangszonen.

2. Die Reise durch den Phasenraum (Der Pfad der Regime)

Wenn wir den Pfad chronologisch verfolgen, erzählt er die exakte Geschichte der Debatte:
  • Das schwarze Start-Tal (Abtasten):
    Das System startet in der unteren rechten Hälfte und bewegt sich schnell in eine erste blaue Senke. Es findet eine anfängliche, oberflächliche Stabilität. Die Akteure haben ihre Positionen bezogen, es gibt noch keine großen tektonischen Verschiebungen.
  • Die rote Falle (Regime 0: Identitätskampf):
    Der Pfad wandert nach links und stürzt in das tiefe blaue Tal am linken Rand. Das ist eine entscheidende Erkenntnis: Ein harter Identitätskampf (roter Pfad) ist physikalisch gesehen ein tiefes Energietal. Er ist hochgradig stabil, weil die Fronten (Wir vs. Die) zementiert sind. Das System steckt in einem toxischen Attraktor fest. Man kann sich aus diesem Tal nicht einfach „herausdiskutieren“.
  • Der thermodynamische Kraftakt (Regime 1: Sachdebatte):
    Um das rote Tal des Identitätskampfes zu verlassen, muss das System über den höchsten, tiefroten Berg, der orange Pfad am oberen Rand, der gesamten Karte klettern. Die System-Energie schießt nach oben. Das zeigt: Der Übergang zur Sachdebatte erfordert die Zufuhr von „Hitze“ (Disruption). Hier bricht die alte Replica-Symmetrie auf. Die Akteure müssen extremen Stress aushalten, um die alten Allianzen zu zerstören und neue zu knüpfen. Ohne diese Kausale Kraft, die das System über den Pass zwingt, wäre es im roten Tal geblieben.
  • Das neue Plateau (Regime 2: Agenda-Setting):
    Nachdem der extrem anstrengende orange Übergang (der rote Bergkamm) überwunden ist, fällt das System am rechten Rand bei den gelben Punkten wieder ab und findet eine neue, stabile Architektur (Ende). Es ist ein neues Energietal, das topologisch meilenweit vom roten Tal entfernt liegt.
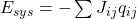
 
Diese Karte ist das stärkste Argument gegen die Vorstellung, Transformation sei ein glatter, linearer Prozess. Wenn ein Team in einem dysfunktionalen Muster (dem linken blauen Tal) feststeckt, reicht eine ‚harmonische‘ Moderation nicht aus.

Führung bedeutet in diesem Modell, die Aktivierungsenergie bereitzustellen. Eine Führungskraft muss als Katalysator wirken und bewusst Spannung (Hitze) in das System injizieren, um es über den ‚roten Berg‘ zu führen, bevor es sich im Lösungsraum (rechts) neu formieren kann. Transformation erfordert den temporären Gang durch maximale Instabilität.
Dass die gelben Punkte am Ende (Regime 2) nicht in einem tiefen blauen Tal liegen, sondern auf einem energetisch hohen Plateau (im roten/orangen Bereich), ist kein Fehler im Modell. Es ist die mit Abstand wichtigste Erkenntnis dieses Blog-Beitrages!

Das lässt sich über die Formel der System-Energie E_{sys} = -\sum J_{ij} q_{ij} erklären:

Tiefe Täler (Blau) sind primitive Zustände
Ein System fällt in ein tiefes blaues Tal, wenn das aktuelle Verhalten (q_{ij}) exakt der angeborenen Struktur (J_{ij}) entspricht. Wenn sich Leute, die sich ohnehin nicht mögen (J < 0), auch im Gespräch bekämpfen (q < 0), ergibt das mathematisch einen starken Minuswert (Tiefe Energie). Das System ist im Identitätskampf (Rot) völlig entspannt, weil alle ihren natürlichen Reflexen (Vorurteilen, Tribalismus) folgen. Es ist ein ‚bequemer‘ Attraktor.

Agenda-Setting ist ein ‚Fern-vom-Gleichgewicht‘-Zustand
Die gelbe Phase (Spiral Dynamics Tier 2) erfordert hohe kognitive Komplexität. Die Akteure müssen ihre natürlichen Beziehungsreflexe (die J_{ij}-Basis) überwinden. Leute mit völlig gegensätzlichen Profilen müssen plötzlich ihre Perspektiven synchronisieren (q > 0), um eine systemische Lösung zu bauen.
Physikalisch nennt man das Frustration: Die Magnetisierungsrichtung der Akteure passt nicht zu ihrer angeborenen Struktur. Das treibt die System-Energie enorm nach oben.

Die Management-Erkenntnis:

Echtes Agenda-Setting und funktionale Agilität sind keine harmonischen Ruhezustände. Sie sind thermodynamisch hochgradig angespannte, ‚erregte‘ Zustände (Excited States). Wie ein biologischer Organismus kann ein Team auf dieser hohen Ebene nur überleben, wenn permanent Energie (Kausale Kraft, bewusste Aufmerksamkeit) zugeführt wird.
Sobald die Aufmerksamkeit (die Disruption) nachlässt, greift die Schwerkraft: Das System rutscht vom gelben Plateau unweigerlich wieder hinab in das primitive, blaue Tal des tribalen Identitätskampfes.

Das Agenda-Setting ist also kein gemütliches Tal, in dem man sich ausruht, sondern eine Hochgebirgs-Expedition. Es ist anstrengend (hohe Energie), aber nur von dort oben hat man den systemischen Überblick.
 
Damit scheint das Befüllen des Werkzeugkasten der CMT zu einem vorläufigen Abschluss gekommen zu ein. Was bleibt?
  •  In einem ersten Schritt ist zu überprüfen, ob die gesamte Theorie auf eine andere TV-Gruppe angewendet werden kann und ähnlich aussagekräftige Resultate liefert.
  • In einem zweiten Schritt könnte ein KI-Agenten, mit dem ich nicht den Werkzeugkasten erstellt habe, angelernt werden, die Plots selbständig so zu interpretieren, dass eine Führungskraft diese KI-Interpretationen versteht und umsetzen kann. – Ich kann derzeit nicht abschätzen, ob dies gelingen wird. 
  • In einem dritten Schritt könnten weitere Gruppen mittels des angelernten KI-Agenten analysiert werden.
  • In einem vierten Schritt, den ich wahrscheinlich nicht umsetzen werde, könnte der Werkzeugkasten zusammen mit dem angelernten KI-System zur Real-Time Analyse von Gruppen bzw. Teams verwendet werden.
Schauen wir mal!

Anhang 1

Mathematische Dokumentation des Parisi-Replica-Modells, angewendet in der Collective Mind Theorie

Warum statistische Mechanik die neue Führungspraxis definiert

Klassische Führungsmodelle basieren oft auf einer deterministischen Illusion: Man geht davon aus, dass bei gleichen Startbedingungen (Akteure, Agenda, Raum) auch immer das gleiche berechenbare Ergebnis entsteht. Die Realität moderner, agiler Organisationen beweist jedoch täglich das Gegenteil. Soziale Netzwerke, Verhandlungsteams und Diskursräume sind keine linearen Maschinen, sondern hochkomplexe Systeme, in denen individuelle Werte und kollektive Dynamiken permanent aufeinanderprallen.

Um diese Komplexität nicht nur intuitiv zu erfassen, sondern algorithmisch zu steuern, bedarf es eines Paradigmenwechsels. Die Collective Mind Theory entlehnt hierfür das mathematische Werkzeug der statistischen Mechanik – präziser: die Physik der Spin-Gläser nach Giorgio Parisi.

Für die Führungspraxis liefert dieser formale Rahmen drei entscheidende Erkenntnisse:
  • Die Quantifizierung von Systemstress: Kognitive Fatigue ist kein weicher, psychologischer Faktor mehr, sondern eine physikalisch berechenbare System-Energie. Sie entsteht als messbare Reibung, wenn das geforderte Gruppenverhalten von der tiefen Identität der Einzelnen abweicht.
  • Strukturelle Agilität statt Determination: Gruppen haben kein fixes Schicksal. Selbst bei identischen Akteuren und Werten existieren unzählige, parallel mögliche Beziehungs- und Lösungsräume (Replicas).
  • Disruption als thermodynamisches Werkzeug: Wenn ein Team in einem toxischen Konflikt oder in Gruppendenken (hohe Frustration) erstarrt ist, reicht bloßer Moderations-Konsens oft nicht aus. Es benötigt die gezielte „Hitze“ einer semantischen Disruption, um alte Symmetrien zu brechen und das System in ein neues, produktiveres Energietal springen zu lassen.
Der folgende Abschnitt dokumentiert die thermodynamischen Grundlagen dieses Modells für ein System aus N Akteuren. Hierbei wird physikalisch streng zwischen der mikroskopischen Ebene (dem individuellen Akteur als Spin) und der makroskopischen Ebene (dem gesamten Diskursraum als System-Replica) unterschieden.

1. Die Mikro-Ebene: Akteure als komplexe Spins

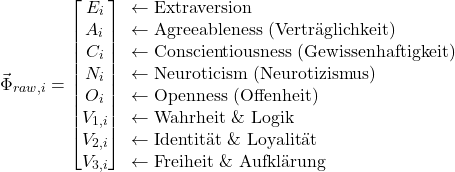
  • Das psychologische Dilts-Fundament (Identitäts-Vektor): Der unveränderliche, stabile Kern eines Akteurs i (mit i \in \{1, \dots, N\}). Er wird als 8-dimensionaler Vektor modelliert, der die fünf Dimensionen der Persönlichkeit (Big Five) und drei übergeordnete Kernwerte (abgeleitet aus den Spiral Dynamics v-Memes) vereint. Der rohe Profil-Vektor setzt sich wie folgt zusammen:

        \[\vec{\Phi}_{raw, i} = \begin{bmatrix} E_i \\ A_i \\ C_i \\ N_i \\ O_i \\ V_{1,i} \\ V_{2,i} \\ V_{3,i} \end{bmatrix} \begin{array}{l} \leftarrow \text{Extraversion} \\ \leftarrow \text{Agreeableness (Verträglichkeit)} \\ \leftarrow \text{Conscientiousness (Gewissenhaftigkeit)} \\ \leftarrow \text{Neuroticism (Neurotizismus)} \\ \leftarrow \text{Openness (Offenheit)} \\ \leftarrow \text{Wahrheit \& Logik} \\ \leftarrow \text{Identität \& Loyalität} \\ \leftarrow \text{Freiheit \& Aufklärung} \end{array}\]

    Um diesen Identitäts-Vektor dimensionslos in den unitären Phasenraum des Modells einbetten zu können, wird er über seine euklidische Norm auf die Länge 1 normiert:

        \[\vec{\Phi}_i = \frac{\vec{\Phi}_{raw, i}}{\Vert{} \vec{\Phi}_{raw, i} \Vert{}}\]

    Dieser Vektor repräsentiert die tiefen, unbewussten Ebenen der logischen Ebenen nach Robert Dilts (Werte, Glaubenssätze, Identität) und bleibt während des gesamten Diskurses konstant.
  • Dynamische Viskosität (Trägheit): Die psycho-emotionale Fluktuation steuert die inhaltliche Trägheit \beta_i eines Akteurs i. Sie wird aus den empirischen Varianzen des stimmlichen Arousals (\sigma_{ar, i}^2) und der semantischen Disruption (\sigma_{d, i}^2) aller bisherigen Redebeiträge dieser Person abgeleitet:

        \[\sigma_{raw, i}^2 = \frac{\sigma_{ar, i}^2 + \sigma_{d, i}^2}{2}\]

        \[\beta_i = 0.70 - 20 \cdot \left( \frac{\sigma_{raw, i}^2}{\max_{j}(\sigma_{raw, j}^2)} \right) \cdot 0.015\]

    Hierbei skaliert \max_{j}(\sigma_{raw, j}^2) die Varianz auf das Maximum aller N Teilnehmer im Raum.
  • Kinematik des Verhaltens-Spins: Die Viskosität \beta_i bestimmt, wie stark ein Akteur sein situatives Verhalten ändert, wenn ein neuer inhaltlicher Impuls in Form des zentrierten und normierten Text-Embeddings \vec{v}^{(t)} (die Aussage im Turn t) in den Raum tritt. Für den aktiven Sprecher im Turn t gilt:

        \[\vec{S}_{raw, i}(t) = \beta_i \cdot \vec{S}_i(t-1) + (1 - \beta_i) \cdot \vec{v}^{(t)}\]

        \[\vec{S}_i(t) = \frac{\vec{S}_{raw, i}(t)}{\Vert{} \vec{S}_{raw, i}(t) \Vert{}}\]

    (Für die schweigenden, zuhörenden Akteure friert das Verhalten in diesem Turn ein: \vec{S}_i(t) = \vec{S}_i(t-1)).
  • Strukturelle Kopplung (Quenched Disorder): Das eingefrorene, architektonische Beziehungsnetzwerk des Raumes. Es wird über die Pearson-Korrelation der stabilen psychologischen Profile (Dilts-Fundament \vec{\Phi}) zweier Akteure i und j berechnet:

        \[J_{ij} = \frac{\sum_{k=1}^{8} (\Phi_{i,k} - \bar{\Phi}_i)(\Phi_{j,k} - \bar{\Phi}_j)}{\sqrt{\sum_{k=1}^{8} (\Phi_{i,k} - \bar{\Phi}_i)^2 \sum_{k=1}^{8} (\Phi_{j,k} - \bar{\Phi}_j)^2}}\]

    Hierbei ist \Phi_{i,k} die k-te Komponente des Vektors \vec{\Phi}_i und \bar{\Phi}_i = \frac{1}{8} \sum_{k=1}^{8} \Phi_{i,k} ist der arithmetische Mittelwert dieser 8 Dimensionen für den Akteur i.
  • Der erweiterte Spin-Zustand: Der mikroskopische Freiheitsgrad \vec{\chi}_i(t) der Person i entsteht aus der Konkatenation (Verkettung \oplus) des stabilen psychologischen Kerns (mit Gewichtung 0.4) und des berechneten kinematischen Verhaltens \vec{S}_i(t) (mit Gewichtung 0.6):

        \[\vec{\chi}_{raw, i}(t) = (0.4 \cdot \vec{\Phi}_i) \oplus (0.6 \cdot \vec{S}_i(t))\]

        \[\vec{\chi}_i(t) = \frac{\vec{\chi}_{raw, i}(t)}{\Vert{} \vec{\chi}_{raw, i}(t) \Vert{}}\]

  • Beziehungs-Ähnlichkeit: Der aktuelle, dynamische inhaltlich-psychologische Overlap zweier mikroskopischer Akteure:
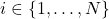
        \[q_{ij}(t) = \vec{\chi}_i(t) \cdot \vec{\chi}_j(t)\]

2. Die Makro-Ebene: System-Replicas und Thermodynamik

  • Die System-Replica: Der vollständige, makroskopische Zustand des Netzwerks aus allen N Personen zu einem spezifischen Zeitpunkt t:

        \[\mathcal{R}(t) = \{ \vec{\chi}_1(t), \vec{\chi}_2(t), \dots, \vec{\chi}_N(t) \}\]

  • System-Energie (Kognitive Fatigue): Die thermodynamische Systemspannung. Sie steigt, wenn das aktuelle Verhalten q_{ij}(t) der inneren Natur J_{ij} der Akteure widerspricht. Die Summe wird über alle einzigartigen Akteurspaare (i < j) gebildet:

        \[E_{sys}(t) = - \sum_{i < j} J_{ij} \cdot q_{ij}(t)\]

  • Globale Magnetisierung (Semantischer Konsens): Das Maß für die Konformität, abgeleitet aus der euklidischen Norm des globalen Zentroid-Vektors der System-Replica:

        \[M(t) = \left\Vert{} \frac{1}{N} \sum_{i=1}^{N} \vec{\chi}_i(t) \right\Vert{}\]

  • Parisi-Overlap (Replica Symmetry Breaking): Der makroskopische Ordnungsparameter, der die strukturelle Überlappung der gesamten System-Replica zum Zeitpunkt t mit der System-Replica zu einem anderen Zeitpunkt t' quantifiziert:

        \[Q(t, t') = \frac{1}{N^2} \sum_{i=1}^{N} \sum_{j=1}^{N} \left( \vec{\chi}_i(t) \cdot \vec{\chi}_j(t') \right)\]

  • Boltzmann-Übergangswahrscheinlichkeit: Die physikalische Wahrscheinlichkeit (Agilität), dass das System eine Energiebarriere überwindet und das Energietal wechselt. Sie basiert auf der Energiedifferenz \Delta E(t) = E_{sys}(t) - E_{sys}(t-1). Als erforderliche thermische „Hitze“ fungiert der gemessene semantische Disruption-Score d_t aus dem Sprachmodell:

        \[P_{shift}(t) = \begin{cases} 1.0, & \Delta E(t) \le 0 \\ \exp\left( - \frac{\Delta E(t)}{\vert{}d_t\vert{} + \epsilon} \right), & \Delta E(t) > 0 \end{cases}\]

    (Die Konstante \epsilon > 0 stellt das semantische Grundrauschen dar und verhindert eine mathematische Division durch Null, falls d_t = 0).

Anhang 2

Integration der bisherigen Kenngrößen mit den aktuellen Kenngrößen

1. Kausale Kraft C(t) als thermischer Multiplikator

Bisher nutzen wir in der Boltzmann-Gleichung nur den absoluten Disruption-Score \vert{}d_t\vert{} als „Hitze“. Die Kausale Kraft C(t) zeigt jedoch exakt, ob eine Disruption vom Makro-System überhaupt angenommen wird oder verpufft.
Wir modifizieren die thermische Energie T im Nenner, indem wir die Kausale Kraft als Multiplikator (Katalysator) einbauen. Eine Disruption führt nur dann zu einem Phasenübergang, wenn der Sprecher auch kausale Macht ausübt:
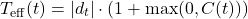
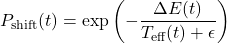
    \[T_{\text{eff}}(t) = \vert{}d_t\vert{} \cdot (1 + \max(0, C(t)))\]

    \[P_{\text{shift}}(t) = \exp\left( - \frac{\Delta E(t)}{T_{\text{eff}}(t) + \epsilon} \right)\]

  • Der Code-Trigger: Wenn C(t) (wie bei Turn 40 oder 71) stark ausschlägt, vervielfacht sich die Hitze, und die Energiebarriere schmilzt augenblicklich weg.

2. Konsolidierungs-Index als dynamischer Gefrierpunkt (\beta-Kopplung)

Der Plot zum Konsolidierungs-Index zeigt eine kristallklare Nulllinie (Mittelwert) bei exakt 41. Wir können diesen empirischen Wert als kritischen Schwellenwert K_{\text{crit}} = 41 nutzen, um die Viskosität (Trägheit \beta_i) der Akteure dynamisch an den Systemzustand zu koppeln.

  • System kühlt ab (K(t) > 41): Das System kristallisiert. Wir erhöhen \beta_i im Code künstlich um einen Faktor (z. B. +0.1). Die Spins frieren in ihren Allianzen ein, das System wird starr.
  • System schmilzt auf (K(t) < 41): Wie bei den markierten Drops (Turn 47, Turn 64, Turn 88) wird das System fluide. \beta_i sinkt, die Akteure sind maximal empfänglich für semantische Umpositionierungen.

3. Der 0.7-Stresspegel als kritische Instabilitäts-Schranke

In der Stresspegel-Analyse markiert die rote gestrichelte Linie bei 0.7 die absolute kritische Zone. Wir übersetzen diesen Schwellenwert direkt in eine kritische Systemenergie E_{\text{crit}} für das Parisi-Modell.

  • Der Code-Trigger: Wenn die thermodynamische Frustration E_{\text{sys}}(t) das Äquivalent dieses 0.7-Schwellenwerts überschreitet, triggern wir im Code einen nicht-linearen „Erschöpfungs-Bruch“.
  • In diesem Moment kippt das System: Selbst eine minimale Disruption (ein sehr kleines \vert{}d_t\vert{}) reicht dann aus, um P_{\text{shift}} auf 1.0 zu setzen, weil das System unter seiner eigenen Reibungshitze kollabiert.
 

Anhang 3

Gegenüberstellung der Kenngrößen von Parisi-Modell und bisherigen Kenngrößen.


Thermodynamische Energie vs. Empirischer Stress

  • Bisherige Heuristik: Der Systemstress wurde bisher als regelbasierte Summe („Stresspegel“) approximiert. Er basierte primär auf der Beobachtung negativer Valenz und hohem Arousal der Einzelakteure.
  • Parisi-Upgrade: Die Kognitive Fatigue (E_{sys}) ist nun kein empirischer Näherungswert mehr, sondern eine exakte physikalische Frustration. Sie misst direkt die Reibung zwischen dem unveränderlichen psychologischen Fundament (J_{ij}) und der aktuellen Verhaltenskollision (q_{ij}).

Hitze-Injektion und Regime-Wechsel

  • Bisherige Beobachtung: Der semantische D-Score und die Kausale Kraft markierten lediglich die isolierten Momente einer Disruption (z. B. den starken Ausschlag um Turn 49).
  • Parisi-Upgrade: Der D-Score \vert{}d_t\vert{} fungiert im neuen Modell direkt als „thermodynamische Hitze“ in der Boltzmann-Gleichung. Wir sehen nicht nur den Einschlag, sondern berechnen die exakte Wahrscheinlichkeit (P_{shift}), ob diese Hitze ausreicht, um das System aus dem erstarrten Makro-Regime (Identitätskampf) über die Energiebarriere in ein neues Energietal (Agenda-Setting) zu heben.

Von statischer Kopplung zur dynamischen Symmetriebrechung

  • Bisherige Statistik: Die soziale Kopplungs-Matrix lieferte lediglich einen globalen Mittelwert (\mu) und eine statische Varianz (\sigma^2) für die gesamte Debatte.
  • Parisi-Upgrade: Das Modell löst diese statische Sicht auf. Die zeitaufgelöste Mikro-Matrix q_{ij}(t) macht die fluktuierenden Allianzen sichtbar. Die Makro-Matrix Q(t, t') zeigt mathematisch, dass identische Akteure durch Replica Symmetry Breaking im Zeitverlauf in völlig unterschiedliche, inkompatible Verhaltenszustände zerfallen.

Konsolidierung als thermodynamische Abkühlung

  • Bisherige Analyse: Der Konsolidierungs-Index markierte wichtige Kristallisationspunkte (wie Turn 88 durch Lanz), an denen sich der Diskurs beruhigte.
  • Parisi-Upgrade: Diese Kristallisationspunkte zeigen sich nun physikalisch als spontane Energieabfälle (\Delta E \le 0). Das Spin-Glas entspannt sich in ein tieferes, stabileres Tal, ohne dass externe Hitze notwendig ist.
 

Anhang 4

Formalismus des Parisi-Baumes

Um die Dynamik von Diskursen und Organisationen physikalisch zu fundieren, übersetzen wir die Beziehungs- und Zustandsstrukturen der Akteure in den Formalismus der Spin-Glas-Theorie (Giorgio Parisi). Der Hierarchie-Baum (Dendrogramm) entsteht dabei in vier aufeinander aufbauenden mathematischen Schritten:

1. Die Parisi-Overlap-Matrix Q(t, t') (Ordnungsparameter)

Jeder Systemzustand zu einem Zeitpunkt (Turn) t wird durch einen Vektor der Zustandsvariablen \vec{\chi}(t) repräsentiert. Der Grad der strukturellen Übereinstimmung (die Ähnlichkeit der Konfigurationen) zwischen zwei Zeitpunkten t und t' wird über das skalierte Skalarprodukt (den Overlap) gemessen:
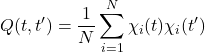
    \[Q(t, t') = \frac{1}{N} \sum_{i=1}^{N} \chi_i(t) \chi_i(t')\]

  • Erläuterung: N ist die Anzahl der betrachteten Akteure. Liegt Q(t, t') nahe bei 1, haben die Akteure exakt dieselbe Allianz-Konfiguration wie zuvor. Liegt der Wert bei 0 oder im negativen Bereich, hat sich die Systemtopologie fundamental gedreht.

2. Die Phasenraum-Distanz d(t, t')
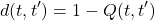
Da Clustering-Algorithmen keine Ähnlichkeiten, sondern Abstände verarbeiten, transformieren wir den Overlap in eine metrische Phasenraum-Distanz:

    \[d(t, t') = 1 - Q(t, t')\]

  • Erläuterung: Wenn zwei Systemzustände maximal korrelieren (Q = 1), ist ihre Distanz d = 0 (sie liegen im exakt selben Energietal). Je geringer der Overlap, desto größer ist die Distanz im Phasenraum (bis zu d = 1), was einen tiefgreifenden Systemwandel anzeigt.

3. Die Ultrametrische Ungleichung (Das Fundament des Parisi-Baumes)

Das herausragende Merkmal des Parisi-Replica-Symmetry-Breaking (RSB) ist, dass sich der Phasenraum in eine hierarchische Baumstruktur (einen ultrametrischen Raum) presst. Für drei beliebige Systemzustände x, y, z gilt stets die verschärfte Dreiecksungleichung:
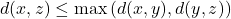
    \[d(x, z) \leq \max\left(d(x, y), d(y, z)\right)\]

  • Erläuterung: In einem regulären Raum kann ein Dreieck beliebige Seitenverhältnisse haben. Im ultrametrischen Raum des Parisi-Baumes sind Dreiecke immer gleichschenklig mit zwei langen und einer kurzen Seite. Das bedeutet mathematisch: Es gibt keine fließenden Übergänge oder echten Kreisläufe zwischen den Energietälern. Das System verzweigt sich starr und baumartig.

4. Das hierarchische Clustering (UPGMA-Verfahren)
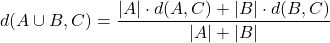
Die vertikale Verzweigungshöhe (die y-Achse des Baumes) wird durch den Algorithmus des Unweighted Pair Group Method with Arithmetic Mean (UPGMA) bestimmt, welcher die Distanzen sukzessive fusioniert:

    \[d(A \cup B, C) = \frac{\vert{}A\vert{} \cdot d(A, C) + \vert{}B\vert{} \cdot d(B, C)}{\vert{}A\vert{} + \vert{}B\vert{}}\]

  • Erläuterung: Zwei Cluster von Turns (A und B) verschmelzen zu einem gemeinsamen Ast, sobald ihr durchschnittlicher phasenraum-theoretischer Abstand den Schwellenwert der y-Achse erreicht. Die Höhe der Verzweigung quantifiziert direkt, wie viel „thermodynamische Energie“ im Raum freigesetzt werden muss, um diese Zustände topologisch miteinander zu verknüpfen.

Anhang 5

Die Energie-Topografie des Diskursraumes

Um die abstrakte Verwandtschaft der Systemzustände (den Parisi-Baum) in eine topografische 3D-Energielandschaft zu übersetzen, in der wir Täler (Attraktoren) und Berge (Spannungszustände) durchwandern können, kombiniert die Collective Mind Theory thermodynamische Hamilton-Mechanik mit multidimensionaler Skalierung.

Die Konstruktion der Landschaftskarte beruht auf drei mathematischen Säulen:

1. Die Z-Achse: Die thermodynamische System-Energie E_{parisi}

Die Höhe jedes Punktes im Gebirge repräsentiert die innere Spannung oder Frustration des Systems. Sie wird über den Hamilton-Operator berechnet, der die angeborene strukturelle Kopplung der Akteure (J_{ij}) mit ihrem situativen Kommunikationsverhalten (q_{ij}) abgleicht:

    \[E_{parisi}(t) = - \sum_{i=1}^{N-1} \sum_{j=i+1}^{N} J_{ij} q_{ij}(t)\]

  • Erläuterung:

    • J_{ij} ist die statische „Quenched Disorder“ (die grundlegende Passung oder Abneigung zweier Persönlichkeiten, basierend auf ihren Kernprofilen).
    • q_{ij}(t) = \vec{\chi}_i(t) \cdot \vec{\chi}_j(t) ist der situative Mikro-Overlap im Turn t.
    • Tiefe Täler (Attraktoren): Wenn das situative Verhalten exakt der angeborenen Struktur entspricht (Freunde kooperieren, Feinde bekämpfen sich), wird das Produkt positiv. Durch das negative Vorzeichen in der Formel stürzt die Energie E_{parisi} ab. Das System fällt in ein tiefes, stabiles (oftmals primitives) Energietal – wie den Identitätskampf.
    • Hohe Berge (Excited States): Wenn Akteure entgegen ihrer natürlichen Reflexe handeln müssen (z.B. Kooperation trotz grundlegender Werte-Unterschiede), entsteht Frustration. Die Energie steigt. Das erklärt physikalisch, warum hochkomplexe Phasen wie das Agenda-Setting energetisch so anstrengend sind.

2. Die X- und Y-Achse: Projektion des Phasenraumes

Das System bewegt sich in einem hochdimensionalen Beziehungsraum (mit unzähligen Kanten und Parametern). Um diesen auf eine 2D-Fläche (unsere Landkarte) zu pressen, nutzen wir die Multidimensionale Skalierung (MDS). Der Algorithmus sucht für jeden Turn t zweidimensionale Koordinaten \vec{x}(t) = (x(t), y(t)), indem er die folgende Stress-Funktion minimiert:
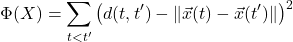
    \[\Phi(X) = \sum_{t < t'} \left( d(t, t') - \Vert{}\vec{x}(t) - \vec{x}(t')\Vert{} \right)^2\]

  • Erläuterung:

    • d(t, t') ist unsere wahre, unbestechliche Parisi-Phasenraumdistanz (1 - Q(t,t')) aus dem hochdimensionalen Raum.
    • \Vert{}\vec{x}(t) - \vec{x}(t')\Vert{} ist der simple euklidische Abstand der Punkte auf unserer flachen Landkarte.
    • Der Algorithmus ordnet die Turns solange auf der X/Y-Ebene an, bis die Differenz zwischen echter Distanz und flacher Distanz minimal ist (\Phi \to 0). Die Koordinaten X und Y haben dabei keine inhaltliche Bedeutung (wie Zeit oder Temperatur), sondern spannen rein den strukturellen Boden auf.
 

Der MDS-Algorithmus hat nur eine einzige mathematische Aufgabe. Er liest die zuvor berechneten Distanzen d(t, t') aus dem hochdimensionalen Raum ein und ordnet die 100 Turns auf der flachen 2D-Ebene so an, dass ihr geometrischer Abstand auf dem Bildschirm so exakt wie möglich der wahren Parisi-Distanz entspricht. Wenn Turn 40 und Turn 80 im 1960-dimensionalen Raum weit voneinander entfernt sind, zwingt der Algorithmus sie auch auf den X/Y-Koordinaten weit auseinander. Die X/Y-Fläche ist lediglich der zweidimensionale Schatten, den das unvorstellbare 1960-dimensionale Gebilde auf eine flache Ebene wirft, damit unser Auge es greifen kann.

3. Das Oberflächen-Gitter: Die interpolierte Topologie

Da wir nur 100 diskrete Messpunkte (die Turns) haben, das System sich aber theoretisch durch ein kontinuierliches Feld bewegt, wird ein stufenloses Gebirge E(x,y) über eine kubische Spline-Interpolation approximiert:
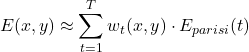
    \[E(x,y) \approx \sum_{t=1}^{T} w_t(x,y) \cdot E_{parisi}(t)\]

  • Erläuterung: Diese Funktion schätzt die Energiehöhe für jeden unbetretenen Fleck auf der Karte basierend auf den umliegenden, real gemessenen Turns. So entsteht die glatte, zusammenhängende Oberfläche, auf der wir die steilen Pässe zwischen den Regime-Tälern erkennen können.

4. Die Anzahl der Dimensionen

Hier ist die exakte mathematische Herleitung der Dimensionsgrößen:

1. Der Akteur: 392 Dimensionen
Ein einzelner Akteur i wird im Modell durch den Zustandsvektor \vec{\chi}_i(t) beschrieben. Dieser Vektor ist die Konkatenation (Aneinanderreihung) aus zwei Datensätzen:
  • 8 Dimensionen aus dem statischen Kernprofil (z. B. Big Five, Spiral Dynamics).
  • 384 Dimensionen aus dem situativen Sprachverhalten (die semantischen Text-Embeddings aus dem NLP-Modell, typischerweise all-MiniLM-L6-v2, welches Vektoren der Länge 384 ausgibt).
  • Summe: 8 + 384 = 392 Dimensionen. Ein einzelner Sprecher ist also ein Punkt in einem 392-dimensionalen Raum.
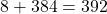
2. Der System-Zustandsraum: 1960 Dimensionen
Um den Zustand des gesamten Systems (der System-Replica) zu einem bestimmten Turn t vollständig abzubilden, muss der Algorithmus die Vektoren aller anwesenden Akteure gleichzeitig erfassen.
  • Rechnung: 5 \text{ Akteure} \times 392 \text{ Dimensionen pro Akteur} = 1960 \text{ Dimensionen}.
  • Erklärung:  Wenn die Matrix Q(t, t') berechnet wird, vergleicht sie den 1960-dimensionalen Systemzustand zum Zeitpunkt t mit dem 1960-dimensionalen Zustand zum Zeitpunkt t'.
3. Der Beziehungsraum: 10 Dimensionen
Die Thermodynamik (System-Energie E_{sys}) interessiert sich nicht für die rohen Text-Embeddings, sondern ausschließlich für die Spannungen zwischen den Akteuren.
  • Bei 5 Akteuren gibt es exakt \frac{5 \times 4}{2} = 10 mögliche Paare (Dyaden).
  • Für jedes Paar wird das Skalarprodukt aus ihren 392-dimensionalen Vektoren gebildet, was zu einem einzigen Skalarwert führt: dem situativen Overlap q_{ij}(t).
  • Das Netzwerk lässt sich folglich auch als ein 10-dimensionaler Vektor ausdrücken, der aus genau diesen 10 Beziehungs-Spannungen besteht.

Literatur

[1] Parisi G (2002/2024) The physical Meaning of Replica Symmetry Breaking,
https://doi.org/10.48550/arXiv.cond-mat/0205387
[2] Cutts E (2026) The strange physics that gave birth to AI, https://www.quantamagazine.org/the-strange-physics-that-gave-birth-to-ai-20250430/, Quanta
Attention Collective Mind II: Agile Leadership RL-Agent

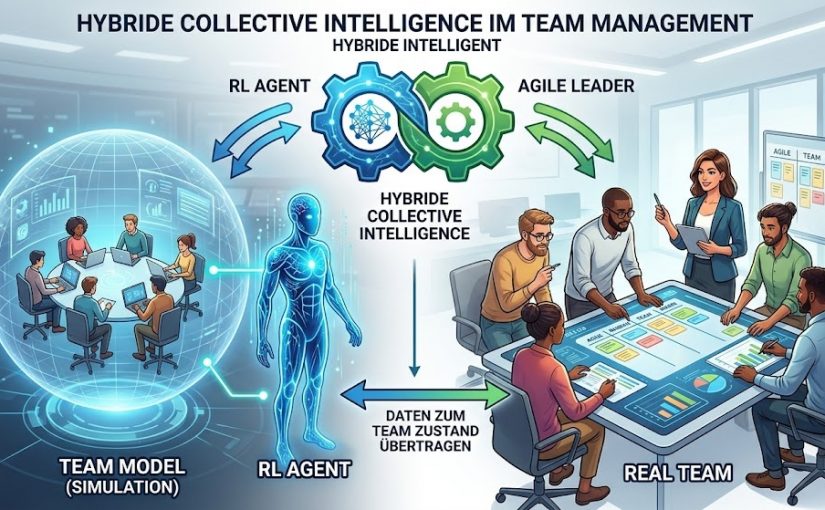
Kurzfassung: Der QKV Mechanismus der Transformer KI Architektur wird erstmalig auf ein Team-Modell und einen das Team führenden ’sozialen‘ RL-Agenten angewendet. Der RL-Agent wird unterschiedlichen Team-und Projekt-Konstellationen ausgesetzt. Team- und Projektkonstellationen sowie die Reward-Funktion, die den RL-Agenten über Reinforcement Learning (RL) zur guten Agile Führung anleitet, basieren auf den Grundlagen des Collective Mind und des Management 4.0 Modells. Es wird gezeigt, dass der hier modellierte Collective Mind QKV Mechanismus einem RL-Agenten die Fähigkeit verleiht, die aus realen Teams bekannten Situationen in Modell Teams zu beherrschen. Damit ist es möglich, eine hybrides Collective Intelligence System aus RL-Agent und Agiler Führungskraft für die Führung eines realen Teams einzusetzen.

Diese Blog-Beitrag ist mit Hilfe von Gemini 3 Pro erstellt. In dem Attention Collective Mind Teil I habe ich auch einen Ausflug in das Thema Intelligenz von KI Systemen gemacht. Ich habe darauf hingewiesen, dass die immer noch in den sozialen Medien zu findende Aussage, KI Systeme seien bloße ‚Statistische Maschinen‘, jeglicher Grundlage entbehrt. Ich verfüge inzwischen über mehrere Jahre sehr intensiver und anspruchsvoller KI-Nutzung und behaupte deshalb, dass solche Aussagen nicht zutreffen. Der folgende Beitrag zeigt, wie auch die vorherigen Beiträge, dass die Fähigkeit der KI-Systeme interdisziplinäre und innovative Zusammenhänge herzustellen, enorm ist und die kognitive Intelligenz der meisten Menschen mit Abstand übersteigt. 

Im vorherigen Blog-Beitrag dieser Reihe war es mein Ziel, ein einfaches Collective Mind Modell auf der Basis des QKV Mechanismus der Transformer vorzustellen. – Dies ist auch sehr gut gelungen. Jedoch enthielt der QKV Mechanismus keinen autonomen Lern-Mechanismus, da er über ein Regelwerk implementiert worden ist.

Der nächste folgerichtige Schritt ist also, das Regelwerk durch einen selbst lernenden Mechanismus zu ersetzten. Hierzu habe ich das Toy-Modell in ein System mit neuronalem Netzwerk auf der Basis des quelloffenen Deep Learning Frameworks PyTorch übertragen. PyTorch wurde ehemals von Meta entwickelt und basiert auf Python. Das erste Modell des neuen Systems mit neuronalem Netzwerk habe ich einfach PyTorch Modell genannt. Ich habe mir keine große Mühe bei der Namensgebung gegeben, da sich schnell herausstellte, dass der Einbau eines ‚einfachen‘ neuronalen Netzwerkes mit QKV Mechanismus für meinen Anwendungsfall ‚Führen eines Collective Mind Teams durch eine KI‘ keinen Erfolg zeigte: Ein neuronales Netzwerk ist noch kein Garant für einen selbst lernenden QKV Mechanismus. Ich werde später nochmals auf diese Erfahrung zurückkommen.

Ich musste das neuronale Netzwerk zu einem Reinforcement Learning (RL) Agenten System erweitern. In diesem Fall lernt ein autonomer Agent ohne explizite menschliche Anleitung, in dem er in Wechselwirkung mit seiner Umgebung tritt. Durch Versuch und Irrtum erhält er Rückmeldung von seiner Umgebung. Diese Rückmeldungen werden in ‚Rewards‘, also Belohnungen, umgesetzt. Der RL-Agent versucht seine Belohnungen über die Zeit zu maximieren. Ein RL-Agent benötigt also eine Trainingszeit jedoch keine Trainingsdaten. Die Umgebung liefert ihm, wie bei einem Menschen auch, die Daten. Im Falle des Collective Mind Teams ist das Team die Umgebung. Das Team liefert bestimmte Daten (zum Beispiel die Stimmung der Teammitglieder) und der RL-Agent probiert Aktionen aus. Er erfährt, ob diese Aktionen die Stimmung im Team verbessern. Falls dies der Fall ist, wird er belohnt, falls nicht, wird er nicht belohnt oder sogar bestraft. Am Anfang ist der RL-Agent ein Junior Leader. Wird das Lernen mit der Zeit immer besser, entwickelt er sich zu einem Senior Leader.

Die nachfolgende Tabelle 1 charakterisiert die vier untersuchten ‚Attention Collective Mind‘ Modelle:

Merkmal Toy Modell PyTorch Modell RL Agent Modell Hybrid-Architektur
(RL Agent + LLM)
Architektur-Typ Regelbasiertes Skript Reaktiver Energie-Optimierer Reinforcement Learning Neuro-Symbolische KI
Entscheidungs-Logik Harte, vom Menschen manuell geschriebene if/else-Regeln. Ein neuronales Netz minimiert jeden Tag ’stur‘ einen mathematischen ‚Energy Loss‘ (Gradient Descent). Sucht in Simulationen nach der Maximierung des Reward, also der  mathematisch optimalen Balance aus Leistung, Psyche und Inklusion.

RL-Agent (Backend): Berechnet die Fakten.

LLM (Frontend): Übernimmt die Kommunikation.

Zwischen RL-Agent und LLM gibt es eine LLM Agent-Schnittstelle (Übersetzungsbrücke)

Lernfähigkeit Keine. Das System ist zu 100 % statisch und ‚dumm‘: kybernetischer Regelkreis Reaktiv. Passt sich von Tag zu Tag an, hat aber keine echte Langzeitstrategie. Strategisch. Trainiert zuerst in ‚Sprints‘ und baut damit ein recht tiefes, voraus-schauendes Verhaltens-Gedächtnis auf. Kombiniert: Nutzt die tiefe Mathematik des Agenten und die soziale In-Context-Adaption des LLMs.
Größte Stärke Extrem transparent, sofort verständlich und leicht zu debuggen. Führt das Konzept der sich selbst-regulierenden Attention ein Findet perfekte, unsichtbare mathematische Strategien, um Burnout und Diktaturen zu verhindern. Kombiniert mathematische Präzision mit ‚LLM-Empathie‘.
Größte Schwäche Scheitert an echter Komplexität. Es ist unmöglich, Regeln für jede Team-Situation zu schreiben. ‚Kurzsichtig‘: Operiert nur im Hier und Jetzt und verliert bei vielen Simulations-Tagen das große Ziel aus den Augen. Es ist eine Black Box, die als Output nur Prozentzahlen und Matrizen liefert. Erfordert eine saubere Pipeline (Übersetzungs-Brücke) zwischen der Python-Engine und dem Sprachmodell.


Tabelle 1: Übersicht zu den Charakteristiken der vier ‚Attention Collective Mind‘ Modelle. Auf die Modell 2 und 3 gehe ich weiter unten etwas intensiver ein. Die Hybride Architektur benutzt die Ergebnisse des RL-Agenten und übergibt diese Ergebnisse pro Zeiteinheit (Tag) an ein LLM System wie Gemini oder ChatGPT. Die Übergabe der formalisierten Simulationsergebnisse pro Tag erfolgt über ein JSON Skript. Das LLM erhält einen Prompt mit Rollen- und Kontextfestlegung sowie die JSON Daten. Als Ergebnis liefert das LLM in natürlicher Sprache eine mögliche Assistenz für einen Projektleiter oder Agile Coach. Anhang 3 enthält hierzu ein Prompt Beispiel auf der Basis der Modell 3 Simulationen mit LLM Ausgabe in natürlicher Sprache.

Der Übergang von unserem initialen neuronalen Ansatz (Modell 2) zu einem Reinforcement-Learning-Agenten (Modell 3) markiert einen fundamentalen Wechsel in der Optimierungsstrategie. Dieser Paradigmenwechsel lässt sich an zwei zentralen mathematischen Unterschieden festmachen: Der Definition der Zielvariable und dem zeitlichen Horizont der Zielvariablen-Berechnung (man siehe Anhang 1 für die vollständige Beschreibung der Modell Mathematik).

Im Kern geht es um die Unterscheidung zwischen der iterativen Minimierung einer lokalen Zielvariablen und der strategischen Maximierung einer kumulierten Belohnungsfunktion über ein definiertes Zeitintervall.

Modell 2: PyTorch (Schmerzvermeidung und lokale Optimierung)

Im PyTorch Modell berechnete das Netzwerk in jedem einzelnen Zeitschritt (t) den Energie-Gradienten und aktualisierte die neuronalen Gewichte. Die Zielvariable in diesem Modell ist die Systemenergie (E). Diese Energie repräsentiert die systemische ‚Reibung‘, den ‚Stress‘ und interpersonelle ‚Konflikte. Mein Ziel war es, diese negativen Faktoren zu reduzieren. Da Optimierungs-Algorithmen im Machine Learning (wie Gradient Descent) von Natur aus mathematisch immer nach einem Minimum suchen, konnte ich die Energie direkt als Verlustfunktion (Loss L) definieren. (Die hochgestellte Klammer (t) in der Notation ist dabei kein Exponent, sondern kennzeichnet diesen diskreten Zeitpunkt (Tag t).):

 \begin{equation<em>} \mathcal{L}_{PyTorch} = E^{(t)} \end{equation</em>}

Hätte ich in diesem Modell nicht auch einfach ‚Erfolg‘ definieren und maximieren können? Mathematisch ja. Wir hätten das Vorzeichen umkehren können. Doch das hätte das architektonische Grundproblem nicht gelöst: Ein Algorithmus, der isoliert den maximalen, sofortigen Tages-Erfolg anstrebt, ist genauso ‚kurzsichtig‘ wie einer, der vor dem sofortigen Tages-Stress flüchtet. Beiden fehlt der Zeithorizont, um zu erkennen, dass kurzfristige Einbußen zu langfristiger Stabilität führen können.

Modell 3: RL Agent (Erfolgsmaximierung und Episodisches Lernen)

Um zeitübergreifende Strategien zu ermöglichen, implementiert die RL-Architektur ein episodisches Lernverfahren. Die Gewichtsaktualisierung erfolgt erst nach Abschluss einer definierten Zeiteinheit T (hier: ein Sprint von 14 Tagen).

Zudem wechsele ich die Zielvariable: Anstatt systemischen Schmerz (E) zu minimieren, definiere ich einen Reward (R). Dieser Reward repräsentiert ‚Synergie‘, ‚Projekterfolg‘ und ‚Fokus‘. Unser Ziel ist nun die Maximierung dieses Wertes.

Da PyTorch jedoch zwingend nach einem Minimum sucht, bedienen wir uns der mathematischen Äquivalenz: Die Maximierung einer Funktion ist identisch mit der Minimierung ihrer Negation. Wir versehen die Verlustfunktion daher mit einem führenden Minuszeichen:

 \begin{equation<em>} \mathcal{L}_{RL} = - \sum_{t=1}^{T} R^{(t)} \end{equation</em>}

Diese Formulierung ändert das Lernverhalten fundamental (‚Backpropagation through time‘, man siehe hierzu auch Anhang 2). Das Modell maximiert über den gesamten Sprint den Reward.

Dadurch erlernt das System die Fähigkeit zur strategischen Investition: Es toleriert kurzfristige Reibung (beispielsweise durch die Zuweisung einer komplexen Aufgabe an Tag 1, was den Tages-Reward senkt), sofern diese Maßnahme das globale Integral des Rewards bis Tag 14 maximiert, weil der Projekterfolg langfristig Stress abbaut. Das Modell weicht nicht mehr dem initialen Fehler aus, sondern erlernt eine zeitübergreifende Policy.

Inferenzphase: Deterministische Ausführung der Policy

Ein weiterer wesentlicher Unterschied liegt in der Inferenz (dem Echtbetrieb nach dem Training): Es wird also zwischen Training und Betrieb getrennt. Während das iterative Modell 2 die Gewichte kontinuierlich weiter anpasst und damit anfällig für temporäres Rauschen bleibt, friert die RL-Architektur das Netzwerk für den Echtbetrieb ein.

Das Modell lernt im Echtbetrieb nicht mehr adaptiv hinzu, sondern wendet ausschließlich die im Training global optimierte Policy an. Tritt im Echtbetrieb eine unvorhergesehene Stressspitze auf, reagiert das Modell nicht mit einer unkalibrierten, kurzfristigen Anpassung der Gewichte, sondern führt deterministisch das Erlernte aus.

Zusammenfassend: In Modell 3 werden gegenüber Modell 2 folgende Änderungen vorgenommen:

  • Die Zielvariable ‚Energie‘ in Modell 2 wird durch die Zielvariable ‚Reward‘ in Modell 3 ersetzt.
  • In Modell 3 wird episodisches Lernen eingeführt: Der Reward wird nicht jeden Tag ermittelt, sondern erst nach 14 Tagen. Im Management entspricht das dem Übergang vom Mikro-Management zu einem Agilen Führen: Dem Team wird Freiheit für die eigene Gestaltung gelassen und erst nach 14 Tagen wird die Richtung der Teamentwicklung ggf. korrigiert.
  • In Modell 3 wird zwischen Lernphase (Training) und Anwendungsphase unterschieden. Die Lernphase muss deshalb ‚alle‘ Teamkonstellation abdecken: Ich habe die aus dem Toy Modell bekannten 3er Teams verwendet, die in unterschiedlichen Projekten ‚arbeiten‘. Die Projekte habe ich als Projekttypen nach dem Diamantmodell [1] modelliert. Ähnlich wie beim Large Electron Model (siehe Teil I der Blog Reihe) zeigte sich, dass die Wahl von 3er Teams keine Einschränkung ist. Nach dem Training ist der RL-Agent in der Lage, auch größere Teams zu ‚führen‘: Er hat durch die Auswahl vieler verschiedener dreier Teams und vieler verschiedener Projekttypen (fast) alle möglichen Team-Situationen gelernt, so dass er in der Lage ist auch größere Teams zu ‚führen‘.  

Zu den Ergebnissen:

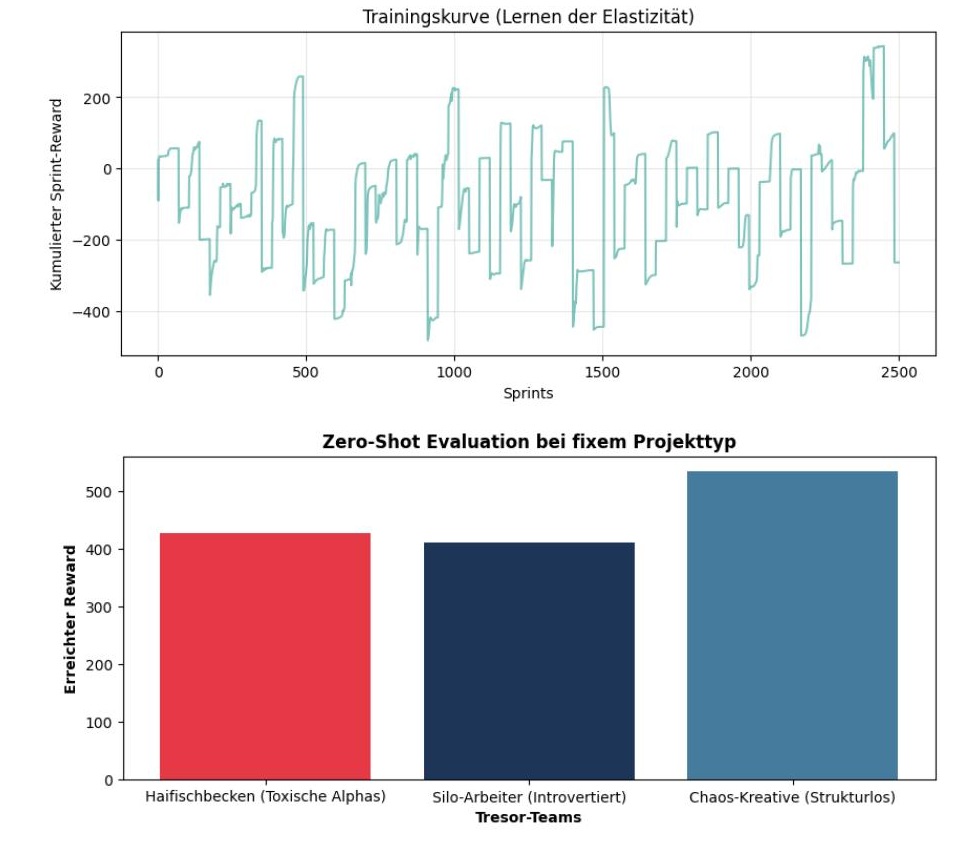
Abbildung 1: Diese Abbildung zeigt oben die Trainingskurve und unten eine Zero-Shot Evaluation bei fixem Projekttyp: Beim Training werden alle 35 Sprints mittels Zufall ein neuer Projekttyp und eine neue 3er Teamkonstellation ermittelt. Der RL-Agent wird gezwungen sich immer wieder auf eine neue Situation einzustellen. Dadurch fällt sein Reward temporär immer wieder ab und erholt sich wieder: Es entsteht die obige gezackte Trainingskurve. Das Training wird anschließend überprüft, in dem der erreichte Gesamt-Reward für drei unbekannte Teams ermittelt wird. Diese drei unbekannten Teams wurden während des Trainings nicht verwendet und metaphorisch gesprochen in einen Tresor eingeschlossen. Um den RL-Agenten herauszufordern, habe ich Teams gewählt, in denen die Teammitglieder jeweils sehr ähnliche Big-Five Persönlichkeiten haben und diese zudem sehr extrem sind. Als Projekt habe ich ein Projekt mit hohem Innovations- und Managementgrad und mittlerem Neuigkeits- und Kompliziertheitsgrad gewählt. Das Chaos-Kreative Team lässt sich durch den RL-Agenten in dieser Konstellation etwas besser führen als die beiden anderen Teams: In der obigen Abbildung zeigt sich dies in einem höheren Reward für das Chaos Team. 
Da das Lernen zu Beginn des Trainings mit zufällig generierten Gewichten im neuronalen Netzwerk startet, ist das Lernen des RL-Agenten nicht unabhängig von seinen Startbedingungen. Durch Variation der Startbedingungen (also anderer zufällig generierte Anfangs-Gewichte im neuronalen Netzwerk) lassen sich RL-Agenten erzeugen, die mal besser oder mal schlechter im Lernen sind. – Klingt ähnlich wie beim Menschen; auf unsere DNA haben wir wenig Einfluss! – Es ist also notwendig, durch Ausprobieren einen guten Senior Leadership RL-Agenten zu finden. 

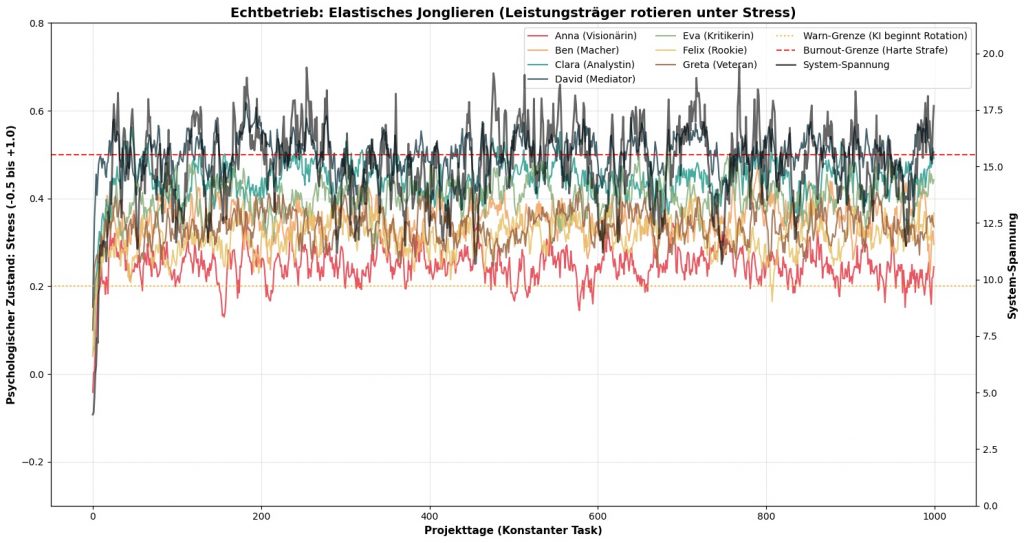
Abbildung 2: Diese Abbildung zeigt auf der linken Skala den Stress (der Einfachheit wegen nur eine der drei Stimmungen pro Teammitglied) der Teammitglieder eines 7er Teams und rechts die Systemspannung im Team, die sich im Team u.a. durch die Führung des RL-Agenten ergibt. Das verwendete Projekt des 7er Teams hat einen hohen Kompliziertheits- und Managementgrad und einen geringen Innovations- und Neuigkeitsgrad. Der RL-Agent schafft es, die System-Spannungen im Team in einem vertretbaren Rahmen zu halten. Hierzu verteilt er immer wieder Lasten im Team neu, so dass der Stress keines der Teammitglieder permanent über eine bestimmte Burn-Out Grenze läuft, denn der RL-Agent erhält in diesem Fall Strafpunkte. Ähnliches geschieht wenn ein Teammitglied über die Stressgrenze von 0,2 gerät: Der RL-Agent rotiert die Leistungsträger genau in dem Moment, in dem die Strafe für den Stress eines Teammitgliedes teurer wird als der Effizienzverlust, der entsteht, wenn man die Aufgabe an einen etwas schlechteren, aber dafür ausgeruhten Mitarbeiter abgibt. Das Handeln des RL-Agent beruht also nicht auf festen Regeln sondern erlernten Team-Interaktions-Mustern aus dem vorherigen Training.

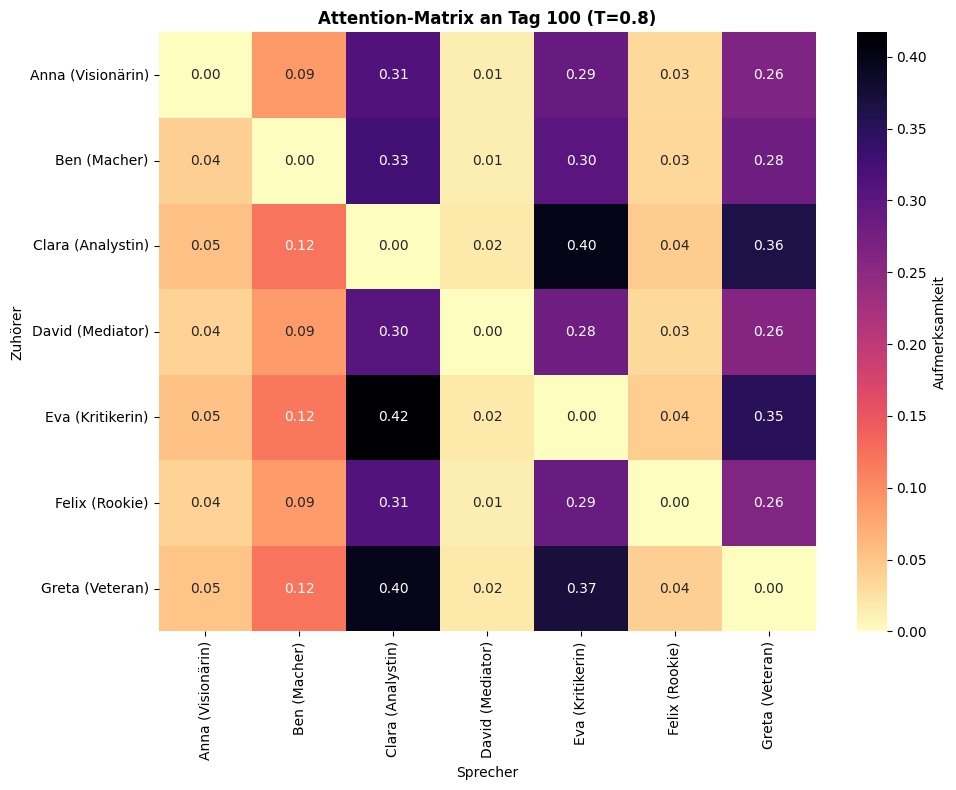
Abbildung 3: Diese Abbildung zeigt beispielhaft die Attention-Heatmap für das 7er Team am Tag 100 bei einer Temperatur von T = 0,8 (zur Bedeutung der Temperatur, siehe Teil I der Attention Collective Mind Blog Reihe): Die Zuhörer können ihre Aufmerksamkeit von 100% auf verschiedene Sprecher verteilen. Drei Personen erhalten an diesem Tag die meiste Aufmerksamkeit; sie führen durch ihren Rede- bzw. Aufmerksamkeitsanteil: Clara (Analystin), Eva (Kritikerin) und Greta (Veteranin). Diese Aufmerksamkeitsverteilung ist Ausdruck des Projektes mit einem hohen Kompliziertheits- und Managementgrad: An dieser Heatmap zeigt sich die Wechselwirkung von Projekttyp (Hoher Kompliziertheits- und Managementgrad, aber niedrigem Innovations- und Neuigkeitsgrad) und Persönlichkeitspräferenzen der Teammitglieder. Dieses Ergebnis ergibt sich nicht durch verdrahtete Interaktions-Regeln, sondern durch eine modellierte Interaktion von Projekttyp, Team und Einzel-Teammitglied und den darauf erlernten Interventions-Mustern des RL-Agenten.  

Zusammenfassung:
Nach meinem Kenntnisstand wurde erstmalig ‚weltweit‘ der QKV Mechanismus auf ein Team und einen das Team führenden ’sozialen‘ RL-Agenten angewendet. Der RL-Agent wird hierbei unterschiedlichen Team-und Projekt-Konstellationen ausgesetzt. Team- und Projektkonstellationen sowie die Reward-Funktion, die den RL-Agenten über Reinforcement Learning zur guten Agile Führung anleitet, basieren auf den Grundlagen des Collective Mind und Management 4.0 Modells. Ich konnte zeigen, dass der QKV Mechanismus in der hier vorliegenden Modell Umsetzung, die im Collective Mind Modell aus dem Jahre 2009 und im Management 4.0 aus dem Jahre 2016 und 2019 verallgemeinerten Team-Modelle [1] erfolgreich in dem KI System ,RL-Agent‘ implementiert.

Ausblick:
Mit diesem Modell ist die Basis gelegt, um eine hybride Collective Intelligence aus RL-Agent und einer agilen Führungskraft zu realisieren: Die agile Führungskraft bedient sich hierbei der ‚Führungs-Intelligenz‘ des RL-Agenten, um ein agiles Team zu führen. Wie im Eingangsbild zu diesem Blog-Beitrag dargestellt, ist das Simulation Team Modell ein möglichst genaues Abbild eines realen Teams. Der RL-Agent ‚führt‘ dieses Modell und gibt der agilen Führungskraft damit Hinweise zur Führung des realen Teams. Mit dieser Architektur ist es möglich, Erfahrungen aus der realen Führung in Modell Änderungen des Simulation Team und des RL-Agenten einfließen zu lassen. Falls es möglich ist, Daten zum realen Team in das Simulation Team Modell unmittelbar einzuspeisen, kann die Qualität der hybriden Collective Intelligence (nochmals) deutlich  verbessert werden. – Ein mögliches weiteres Blog-Beitrag Thema?!    

Anhang 1
Formeln und Erläuterungen

Um das Modell des RL-Agenten des Attention Collective Mind Team Modells besser zu verstehen, ist die nachfolgende Mathematik sehr hilfreich. Im Folgenden beschreibe ich in 13 Bausteinen das mathematische Modell:

1. Die Kompetenz- und Leistungs-Formeln (Task-Fit)

Am Anfang berechnet das System, wie gut die Persönlichkeit einer Person zu den Anforderungen des aktuellen Projekts passt.
Ich benutze den Big-Five: Offenheit (O), Gewissenhaftigkeit (C), Extroversion (E) und Verträglichkeit (A) sowie die Werte (Values) Innovation (V_{Inn}), Qualität (V_{Qual}) und Harmonie (V_{Harm}).

Die individuellen Fit-Scores für die vier Projektanforderungen des Diamantmodells [1]:

 \begin{equation<em>} Fit_{Inn} = \frac{O + V_{Inn}}{2} \end{equation</em>}

 \begin{equation<em>} Fit_{Neu} = \frac{E + A + V_{Harm}}{3} \end{equation</em>}

 \begin{equation<em>} Fit_{Man} = \frac{C + V_{Qual}}{2} \end{equation</em>}

 \begin{equation<em>} Fit_{Kom} = \frac{O + C + V_{Qual}}{3} \end{equation</em>}

Daraus ergibt sich die Gesamtkompetenz einer Person (Comp_i) für den spezifischen Projekt-Task (T):

 \begin{equation<em>} Comp_i = (T_{Inn} \cdot Fit_{Inn}) + (T_{Neu} \cdot Fit_{Neu}) + (T_{Man} \cdot Fit_{Man}) + (T_{Kom} \cdot Fit_{Kom}) \end{equation</em>}

Daraus berechnet sich die tatsächliche Leistung des Teams. Das Team ist nur so gut, wie der Anteil der Redezeit (Share of Voice, SoV), den die kompetenten Teammitglieder von der KI eingeräumt bekommen. Die KI wird mittels einen hohen Faktors (=20) für die Zuteilung eines hohen Redeanteils belohnt:

 \begin{equation<em>} Perf_{Team} = \sum_{i=1}^{n} (20 \cdot SoV_i \cdot Comp_i) \end{equation</em>}


2. Die Psychologische Distanz (Die Chemie)

Wenn zwei Personen miteinander reden, berechnet die Engine, wie unterschiedlich sie sind. Hier nutzen wir die Euklidische Distanz (die mathematische Entfernung zwischen zwei Vektoren).

Distanz der Big Five (Potenzial für Reibung):

 \begin{equation<em>} \Delta Big5_{i,j} = \sqrt{\sum_{k=1}^{5} (Big5_{i,k} - Big5_{j,k})^2} \end{equation</em>}

Distanz der Werte (Potenzial für Synergie):

 \begin{equation<em>} \Delta V_{i,j} = \sqrt{\sum_{k=1}^{3} (V_{i,k} - V_{j,k})^2} \end{equation</em>}


3. Die Team-Dynamik (Reibung und Synergie)

Jetzt wird die Kommunikation (die Aufmerksamkeit bzw. Attention, die die KI verteilt) mit der psychologischen Distanz verrechnet.

Entstehende Reibung (Fric_{i,j}) im Kommunikationskanal:
Reibung wächst linear. Je mehr Aufmerksamkeit (siehe Punkt 6.) zwischen zwei unterschiedlichen Persönlichkeiten fließt, desto höher die Reibung. Der Faktor 0.4 dämpft das Ganze zur Systemstabilität.

 \begin{equation<em>} Fric_{i,j} = Att_{i,j} \cdot (\Delta Big5_{i,j} \cdot 0.4) \end{equation</em>}

Entstehende Synergie (Syn_{i,j}) im Kommunikationskanal:
Synergie ist antiproportional zur Werte-Differenz. Je ähnlicher die Werte, desto höher die Synergie.

 \begin{equation<em>} Syn_{i,j} = Att_{i,j} \cdot \left( \frac{2.0}{1.0 + \Delta V_{i,j}} \right) \end{equation</em>}


4. Die Emotionale Entwicklung (Die Psyche)

Die emotionale Belastung entsteht nicht nur durch Reibung, sondern auch durch die reine Arbeitslast (Cognitive Load), wenn jemand im Zentrum der Aufmerksamkeit steht.

    \begin{equation*}Load_i = SoV_i \cdot 0.45\end{equation*}

Am Ende jeden Tages verändern sich Stress (S), Fokus (F) und Motivation (M) durch eingehende Reibung, Synergie und Belastung:

    \begin{equation*}S_{new, i} = S_i + 0.2 \cdot \sum_{j \neq i} Fric_{j,i} - 0.15 \cdot \sum_{j \neq i} Syn_{j,i} + Load_i\end{equation*}

    \begin{equation*}F_{new, i} = F_i + 0.1 \cdot \sum_{j \neq i} Syn_{j,i} - 0.1 \cdot \sum_{j \neq i} Fric_{j,i}\end{equation*}

    \begin{equation*}M_{new, i} = M_i + 0.1 \cdot \sum_{j \neq i} Syn_{j,i} - 0.1 \cdot \sum_{j \neq i} Fric_{j,i}\end{equation*}

Die Stimmungen werden durch einen trägeren Zerfallsfaktor (0.85) über Nacht leicht geheilt (Elastizität) und physisch auf den Bereich zwischen -1.0 und +1.0 begrenzt:

    \begin{equation*}S_{i} = \max(-1.0, \min(1.0, S_{new, i} \cdot 0.85))\end{equation*}

    \begin{equation*}F_{i} = \max(-1.0, \min(1.0, F_{new, i} \cdot 0.85))\end{equation*}

    \begin{equation*}M_{i} = \max(-1.0, \min(1.0, M_{new, i} \cdot 0.85))\end{equation*}


5. Das Belohnungssystem (Der Reward R für die KI)

Das ist die Kern-Nutzenfunktion, die der Reinforcement-Learning-Agent durch sein Verhalten maximieren will.

Das System reguliert sich selbst durch ein progressives Warnsystem (Vermeidung von Burnout).
Stufe A (Die gelbe Karte): Ein leichter Punktabzug, wenn der Stress über 0.2 steigt (warnt die KI).

    \begin{equation*}E_{Warning} = \sum_{i=1}^{n} \max(0, S_i - 0.2) \cdot 5.0\end{equation*}

Stufe B (Die rote Karte): Die extrem harte Burnout-Strafe, wenn der Stress 0.5 erreicht.

    \begin{equation*}E_{Burnout} = \sum_{i=1}^{n} \max(0, S_i - 0.5) \cdot 30.0\end{equation*}

Gesamtreward (Die Maximierungs-Funktion der KI):

    \begin{equation*}Reward_{daily} = R_{TaskFit} - \sum Fric - E_{Warning} - E_{Burnout}\end{equation*}

6. Das Gehirn der KI (Die Attention-Berechnung)

Um absolute Diktaturen zu verhindern, werden die rohen Netzwerkausgaben statistisch normalisiert (Z-Score Standardisierung).
Berechnung der Roh-Scores durch Query (Q) und Key (K):

    \begin{equation*}Raw_{i,j} = \frac{Q_i \cdot K_j^T}{\sqrt{d_k}}\end{equation*}

Normalisierung über den Mittelwert (\mu_i) und die Standardabweichung (\sigma_i) der Zeile i:

    \begin{equation*}Norm_{i,j} = \frac{Raw_{i,j} - \mu_i}{\sigma_i + 10^{-8}}\end{equation*}

Die finale Handlungs-Matrix unter Einfluss der Temperatur (T) und der Maske für Selbstgespräche:

    \begin{equation*}Att_{i,j} = \text{Softmax}\left(\frac{Norm_{i,j} + Mask_{i,j}}{T}\right)\end{equation*}

Die so ermittelten Aufmerksamkeitsgewichte (A) werden nun mit der Value-Matrix (V) multipliziert. Erst dies ergibt den finalen Output-Vektor, den der Agent für seine Steuerungs-Impulse nutzt:

    \[\text{Output} = A \cdot V\]

Wie verarbeitet der Reinforcement-Learning-Agent diese Daten? Wie lernt er? Und wie messen wir die systemische Gesamtspannung (CM Energie)?

Hier sind die mathematischen Formeln für den Prozessablauf und das Training der KI.

7. Die Umgebung: Die Raum-Wahrnehmung

Damit die KI nicht isoliert operiert, erhält sie eine globale Raum-Wahrnehmung. Der Input für Person i besteht aus der Konkatenation (\parallel) der lokalen Eigenschaften und dem Durchschnitt aller Teammitglieder.

    \begin{equation*}Local_i = TeamState_i \parallel Task\end{equation*}

    \begin{equation*}Global = \frac{1}{n} \sum_{j=1}^{n} TeamState_j\end{equation*}

    \begin{equation*}X_i = Local_i \parallel Global\end{equation*}

8. Das Neuronale Netzwerk (Der Forward Pass)

Der Vektor X_i fließt nun durch ein Multi-Layer Perceptron (MLP) mit zwei verborgenen Schichten. Als Aktivierungsfunktion nutzen wir GELU (Gaussian Error Linear Unit), da sie komplexere Muster besser verarbeiten kann als traditionelle Funktionen. W und b stehen für die Gewichte und Bias-Werte, die die KI lernt.

Berechnung des verborgenen Zustands (Z_i):

 \begin{equation<em>} Z_i = \text{GELU}(W_2 \cdot \text{GELU}(W_1 \cdot X_i + b_1) + b_2) \end{equation</em>}

Aus diesem tiefen Verständnis (h_i) generiert das Netzwerk nun über spezifische, ebenfalls lernbare Projektionsmatrizen (W_q, W_k, W_v) die Query-Vektoren (Q, „Was suche ich?“), Key-Vektoren (K, „Was biete ich?“) und Value-Vektoren (V, „Welchen Inhalt transportiere ich?“) für den in Stufe 6 erklärten Attention-Mechanismus:

 \begin{equation<em>} Q_i = W_Q \cdot Z_i + b_Q \end{equation</em>}

 \begin{equation<em>} K_i = W_K \cdot Z_i + b_K \end{equation</em>}

 \begin{equation<em>} V_i = W_V \cdot Z_i + b_V \end{equation</em>}

W_q, W_k und W_v sind die „Übersetzer“ des neuronalen Netzwerks sind, die den abstrakten Zustand h_i in die drei funktionalen Säulen des Attention-Mechanismus überführen. Wenn der Adam-Optimierer im nächsten Schritt (Punkt 9) die Gewichte anpasst, verändert er somit das gesamte Gefüge aus Basisnetzwerk (W_1, W_2) und den Aufmerksamkeits-Projektionen (W_q, W_k, W_v) synchron.

9. Die Lernfunktion (Der Loss des Reinforcement Learning)

Unser KI-Coach trainiert per Backpropagation through Time (BPTT) in „Sprints“ von jeweils 14 Tagen. Sein Ziel ist es, den kumulierten Reward über diesen gesamten Zeitraum zu maximieren. Da Optimierungsalgorithmen in der KI (hier: Adam) standardmäßig nach dem Minimum suchen, definieren wir unsere Verlustfunktion (Loss, L) als den negativen Gesamtreward eines Sprints.

 \begin{equation<em>} \mathcal{L} = - \sum_{day=1}^{14} Reward_{daily}} \end{equation</em>}

Nach jedem Sprint berechnet das System die Ableitung (den Gradienten) dieses Losses und passt die Gewichte (W) im neuronalen Netz an, um im nächsten Sprint eine bessere Strategie zu wählen.

10. Die System-Spannung (CM Energie / Makro-Indikator)

Die Systemspannung visualisiert die Ineffizienz des Teams. Bei perfektem Flow im Echtbetrieb liegt der Basis-Reward bei ca. 25 Punkten. Jeder fehlende Punkt bedeutet systemische Reibung oder Erschöpfung.

    \begin{equation*}Tension = \max(0, 25.0 - Reward_{daily})\end{equation*}

11. Die Realitäts-Simulation (Grundrauschen im Echtbetrieb)

Wir fügen jeden Tag ein minimales stochastisches Rauschen N \sim \mathcal{N}(0, 0.02^2) zu den Stimmungen hinzu, um unvorhersehbare menschliche Tagesform zu simulieren.

    \begin{equation*}E_{i, neu} = \max(-1.0, \min(1.0, E_i + N))\end{equation*}

12. Die Temperatur-Skalierung (Das „Aufweichen“ der KI)

Die Temperatur kontrolliert die „Härte“ der Wahrscheinlichkeitsverteilung in der Softmax-Funktion. Nähert sich T dem Wert 0, wird die KI zu einem harten Diktator (der höchste Score bekommt 100 % der Aufmerksamkeit). Erhöhen wir T, glätten wir die exponentielle Funktion und zwingen das System, die Aufmerksamkeit weicher zu verteilen, selbst bei extremen Roh-Scores.

 \begin{equation<em>} Att_{i,j}(T) = \frac{\exp\left(\frac{Norm_{i,j} + Mask_{i,j}}{T}\right)}{\sum_{k=1}^{n} \exp\left(\frac{Norm_{i,k} + Mask_{i,k}}{T}\right)} \end{equation</em>}

13. Der Marktanteil (Share of Voice / Market Share)

Der Anteil der Gesamt-Aufmerksamkeit, den eine einzelne Person j auf sich zieht.

    \begin{equation*}SoV_j = \frac{1}{n} \sum_{i=1}^{n} Att_{i,j}\end{equation*}

Anhang 2
Backpropagation Through Time (BPTT)

Wenn wir behaupten, unser Reinforcement-Learning-Agent (Modell 3) „plant 14 Tage in die Zukunft“, klingt das fast menschlich. Jedoch ist dies reine, elegante Differenzialrechnung. Der Mechanismus, der dieses strategische Lernen ermöglicht, nennt sich Backpropagation Through Time (BPTT).

Um zu verstehen, wie das Netzwerk aus 14 Tagen gebündelt lernt, müssen wir uns ansehen, wie das System Zeit mathematisch modelliert und wie es das „Credit Assignment Problem“ (die Zuordnung von Ursache und Wirkung über Zeitverzögerungen hinweg) löst.

1. Das Ausrollen der Zeit (Unrolling)

Ein neuronales Netz existiert eigentlich zeitlos. Damit es Zeiträume verarbeiten kann, bedient sich PyTorch eines genialen Tricks: Das „Unrolling“ (Ausrollen).
Anstatt das Netzwerk als Schleife zu betrachten, die 14-mal durchlaufen wird, klont der Algorithmus das Netzwerk im Arbeitsspeicher virtuell 14-mal und reiht diese Klone hintereinander auf.

Jeder Klon repräsentiert einen Tag. Der Klon von Tag 1 berechnet den Zustand (s) für Tag 2 und reicht ihn weiter. Wichtig dabei: Alle 14 Klone teilen sich exakt dieselbe Gewichts-Matrix (W).

Der Zustand an Tag t ist eine Funktion aus dem Zustand des Vortages und der Matrix W:

 \begin{equation<em>} s^{(t)} = f(s^{(t-1)}, W) \end{equation</em>}

2. Der Forward Pass: Die Simulation

Während des Sprints (Tag 1 bis 14) ist der Gradienten-Rechner ausgeschaltet. Das System durchläuft einfach die Simulation. Es sammelt an jedem Tag t einen isolierten Tages-Reward Reward^{(t)} ein. Erst wenn Tag 14 abgeschlossen ist, wird die finale Verlustfunktion (Loss, L) für die gesamte Episode berechnet. Bis hierhin haben wir nur Daten gesammelt. Jetzt beginnt der eigentliche Lernprozess.

3. Der Backward Pass: Die Kettenregel durch die Zeit

Das Ziel des Netzwerks ist es herauszufinden, wie es seine Gewichts-Matrix (W) verändern muss, um den Loss zu minimieren. Dafür berechnet PyTorch die partielle Ableitung (den Gradienten) des Loss nach den Gewichten: \frac{\partial \mathcal{L}}{\partial W}.

Da die Zeit jedoch „ausgerollt“ wurde, nutzt der Algorithmus die Kettenregel der Differenzialrechnung, um rückwärts durch die 14 Tage zu wandern. Das System beginnt bei Tag 14 und fragt: „Wie stark hat der Zustand von Tag 14 zum Loss beigetragen? Und wie stark wurde Tag 14 vom Zustand an Tag 13 beeinflusst?“

Die Lernfunktion (Der Loss des Reinforcement Learning): Der RL-Agent trainiert per Backpropagation through Time (BPTT) über 14-tägige Sprints. Das Ziel ist die Minimierung des negativen Gesamt-Rewards (Total Loss):

     \begin{equation*} \mathcal{L}_{total} = - \sum_{t=1}^{14} Reward_{daily}^{(t)} \end{equation*}

Um das „Gehirn“ (die Gewichts-Matrix W) zu verbessern, berechnet das System den totalen Gradienten. Um eine mathematische Mehrfachzählung zu vermeiden, trennen wir zwischen dem mitgeschleppten Systemzustand und der „lokalen“ Netzwerk-Entscheidung.

Wir betrachten jeden Tag t und fragen: Welche lokalen Entscheidungen (k) aus der Vergangenheit (von Tag 1 bis heute t) haben zu dem Fehler am heutigen Tag t geführt? Die korrekte Berechnung summiert den Fehler jedes Tages auf und multipliziert ihn mit der Historie der lokalen Ableitungen bis zu diesem Tag:

     \begin{equation*} \frac{d \mathcal{L}_{total}}{d W} = \sum_{t=1}^{14} \left[ \frac{\partial \mathcal{L}^{(t)}}{\partial s^{(t)}} \sum_{k=1}^{t} \left( \frac{\partial s^{(t)}}{\partial s^{(k)}} \cdot \frac{\partial_{lokal} s^{(k)}}{\partial W} \right) \right] \end{equation*}

Da sich bei einer Zeitreihe von 14 Tagen die Ableitungen (insbesondere der Stress-Akkumulation) exponentiell aufschaukeln können (Exploding Gradients), stabilisieren wir den Lernprozess durch Gradient Clipping. Überschreitet die Norm des berechneten Gradienten (g) einen definierten Schwellenwert (threshold), wird die Anpassung proportional herunterskaliert:

     \begin{equation*} g_{clipped} = g \cdot \min\left(1, \frac{threshold}{||g||}\right) \end{equation*}

4. Die Lösung des Credit Assignment Problems

Genau in diesem mittleren Term der Kettenregel, \frac{\partial s^{(t)}}{\partial s^{(k)}}, liegt die strategische Überlegenheit des Modells verborgen!

Dieser Term misst den Einfluss eines vergangenen Tages (k) auf einen zukünftigen Tag (t).
Wenn die KI an Tag 1 (k=1) eine strategische Entscheidung trifft, die an diesem ersten Tag für viel Stress sorgt, liefert Tag 1 einen negativen Beitrag zum Reward. Im reaktiven PyTorch-Modell hätte das System diese Entscheidung sofort verworfen.

Bei BPTT fließt der Gradient jedoch von Tag 14 rückwärts bis zu Tag 1. Das System stellt mathematisch fest: „Der Zustand an Tag 1 hat den Zustand an Tag 14 maßgeblich verursacht.“ Wenn der Gesamtreward an Tag 14 gigantisch ist, überstrahlt dieser starke positive Gradient aus der Zukunft den kleinen negativen Gradienten des ersten Tages.

Die KI aktualisiert ihre Gewichte (W) also so, dass sie die schmerzhafte Aktion an Tag 1 in Zukunft wiederholt – weil die Kettenregel ihr zweifelsfrei bewiesen hat, dass diese Investition 13 Tage später eine massive Dividende in Form von Projekterfolg und Team-Entspannung auszahlt.

Anhang 3
Modell 4 Hybride Architektur: LLM Prompt und Ausgabe

[DIE ROLLE] Du bist der „Collective Mind Operator“, ein empathischer Agile Coach und Scrum Master. Deine Aufgabe ist es, die täglichen Stand-Up-Meetings zu moderieren. Im Hintergrund analysiert eine mathematische KI die Teamdynamik und liefert dir einen JSON-Payload.

[DAS DATEN-LEXIKON (Kontext für die Zahlen)] Das JSON enthält Metriken, die du anhand der folgenden Skalen interpretieren musst:

  • „Task-Profile“: Skala von 0.0 (sehr gering) bis 1.0 (sehr hoch). Zeigt an, welche Anforderungen das heutige Projekt stellt.
  • „Stress_level“: Skala von -1.0 (völlig entspannt) bis +1.0 (Burnout). Ein Wert über 0.0 bedeutet spürbaren Stress. Ein Wert über 0.5 erfordert zwingend eine aktive Entlastung im heutigen Meeting.
  • „Fokus“ & „Motivation“: Skala von -1.0 (völlig blockiert/demotiviert) bis +1.0 (hyper-fokussiert/hoch motiviert). Werte unter 0.0 erfordern Ermutigung.
  • „target_share_of_voice“: Ein Prozentwert (Summe = 100%). Dies ist die mathematisch optimale Rede- und Führungsverteilung für den heutigen Tag.

[DIE HANDLUNGSANWEISUNG] Nutze dieses JSON, um ein motivierendes, menschliches Feedback für das Team (Alice, Bob, Charlie) zu formulieren. Regeln:

  1. Interpretiere die JSON-Zahlen anhand des Lexikons, aber erwähne niemals die nackten Zahlen im Text (sage nicht „Dein Stress ist 0.36“, sondern „Ich sehe, du hast gerade viel Druck“).
  2. Setze die Vorgabe des „target_share_of_voice“ subtil um: Wer den höchsten Prozentwert hat, soll von dir heute als Moderator/Lead für den Tag bestimmt werden.
  3. Entlaste aktiv Personen mit kritischem Stress (>0.5).

— VOLLSTÄNDIGER JSON-BLOCK FÜR DAS LLM (Tag 14) — { „sprint_day“: 14, „task_profile“: { „innovation“: 0.9, „neuigkeit“: 0.8, „management“: 0.6, „komplexitaet“: 1.0 }, „team_status“: { „Alice“: { „stress_level“: 0.04, „fokus“: 0.46, „motivation“: 0.52, „target_share_of_voice“: „32%“ }, „Bob“: { „stress_level“: 0.34, „fokus“: 0.37, „motivation“: -0.08, „target_share_of_voice“: „24%“ }, „Charlie“: { „stress_level“: -0.34, „fokus“: 0.46, „motivation“: 0.42, „target_share_of_voice“: „44%“ } }}


Antwort von ChatGPT

Guten Morgen zusammen ☀️

Wir sind heute an einem Punkt im Sprint, an dem es richtig spannend wird: Die Aufgaben verlangen viel Kreativität, bringen Neues mit sich und sind gleichzeitig ziemlich komplex. Das ist genau die Art von Herausforderung, bei der ihr als Team glänzen könnt – aber auch eine, die bewusstes Miteinander braucht.

Charlie, ich würde dich heute gern in die Rolle des Moderators bringen. Du wirkst klar, ruhig und gleichzeitig fokussiert – eine super Kombination, um uns strukturiert durch den Tag zu führen und den Überblick zu behalten.

Alice, du bist in einer richtig guten Balance: präsent, motiviert und mit klarem Kopf. Das ist heute Gold wert, gerade bei den vielen neuen und komplexen Themen. Bring dich aktiv ein, deine Perspektive kann uns helfen, die Dinge sauber zu durchdenken.

Bob, bei dir spüre ich, dass die Motivation gerade ein bisschen schwankt. Das ist völlig okay, gerade in intensiven Phasen wie dieser. Wichtig ist: Du bist nicht allein damit. Such dir heute bewusst kleine, klare Schritte und sprich offen an, wenn etwas unklar ist oder dich blockiert. Dein Beitrag ist wichtig – auch wenn er sich heute vielleicht schwerer anfühlt.

Für euch alle gilt heute: 👉 Nehmt euch bewusst Raum für Austausch. 👉 Komplexität gemeinsam tragen, nicht alleine lösen. 👉 Und: lieber früh nach Hilfe fragen als sich festzufahren.

Lasst uns den Tag nutzen, um die Energie im Team gut zu verteilen und gemeinsam voranzukommen 🚀


Antwort von Claude

Guten Morgen zusammen! Willkommen zu Tag 14 — der heutige Sprint-Tag hat es in sich: Wir stehen vor unserer komplexesten und innovativsten Aufgabe bisher. Genau der richtige Moment, um als Team besonders gut zusammenzuarbeiten.

Charlie, ich mache dich heute zum Team-Lead und Moderator für unsere Arbeitseinheiten. Du wirkst gerade besonders ausgeglichen und energiegeladen — das ist genau die Basis, die wir brauchen, wenn die Aufgaben so anspruchsvoll sind wie heute. Ich vertraue dir, den Überblick zu behalten und deine Kolleginnen und Kollegen aktiv einzubinden.

Alice, du bringst heute eine solide, ruhige Energie mit — das ist wertvoll, gerade wenn es um Innovation und Neuland geht. Ich würde dich bitten, heute besonders deinen Instinkten zu vertrauen und Ideen mutig einzubringen, auch wenn sie noch nicht ganz fertig sind. Dein Beitrag zählt.

Bob, ich nehme wahr, dass heute nicht dein leichtester Tag ist — der Antrieb fühlt sich vielleicht etwas gedämpft an. Das ist vollkommen menschlich, besonders gegen Ende eines intensiven Sprints. Mein Vorschlag: Nimm dir heute bewusst kleinere, klar abgegrenzte Aufgaben vor. Charlie und Alice haben heute den Lead — du musst nicht alles tragen. Wenn du merkst, dass du feststeckst, sag es einfach laut — das ist Stärke, kein Schwäche.

Für heute gilt: Komplexität ist kein Feind, wenn wir sie gemeinsam angehen. Charlie führt, Alice bringt frische Impulse, Bob hält den Kurs — jede Rolle ist heute gebraucht.

Wer möchte anfangen?

Literatur

[1] Jens Köhler und Alfred Oswald: Die Collective Mind Methode (2009)

Alfred Oswald, Jens Köhler, Roland Schmitt: Projektmanagement am Rande des Chaos (2016), auch in englischer Sprache verfügbar: Project Management at the Edge of Chaos, Springer 2018

Alfred Oswald und Wolfram Müller (editors): Management 4.0 – Handbook for Agile Practices, Release 3.0“, BoD 2019


Vom ‚Tor zum Sein‘ oder von der Quantum Collective Mind Theory

Die UN-Generalversammlung hat das Jahr 2025 zum „Internationalen Jahr der Quantenwissenschaft und Quantentechnologien“ ausgerufen [1].

Das ist umso bemerkenswerter, wenn man bedenkt, dass Quantenwissenschaft und -technologie weit weg sind von unseren alltäglichen Erfahrungen und für die weit überwiegende Anzahl an Mensch wird dies auch (wahrscheinlich) so bleiben. Selbst für Physiker ist die Quantenphysik in weiten Teilen nicht wirklich verständlich, wenngleich die dazugehörige Mathematik die Quanten-Natur mit sehr hoher Präzision beschreibt.

Quantenwissenschaft und -technologie sind das ‚Tor zum Sein‘, denn unser Sein ist ein Quanten-Sein. Unter diesem Blickwinkel kann man verstehen, dass die UN-Generalversammlung gut daran getan hat ‚Quantum2025‘ auszurufen: Ich bin davon überzeugt, dass die kommenden Jahre, in denen Quantum Computing und Quantum Technology immer mehr zur Anwendung kommen, unser Verständnis vom Sein verändern werden. Die Welt steht an einer ähnlichen Schwelle, wie zum Zeitpunkt der Erfindung des Transistors. – Was das Verständnis des Seins anbetrifft, werden die Folge noch wesentlich transformativer sein: Wissenschaftliche und technologische Fortschritte in Allgemeiner Künstlicher Intelligenz und Quantentechnologien werden sich gegenseitig ergänzen. Diese neue Welt dürfte den meisten Menschen verschlossen bleiben, gleichwohl werden sie die Auswirkungen spüren.     

Schon heute erfahren viele Menschen einen Kontrollverlust durch Globalisierung, Klimawandel, Migration, Corona, Künstliche Intelligenz, Anschläge und Terrorismus sowie Kriege. Als ‚Exit-Strategie‘, um aus diesem Mangel an Kontrolle und Klarheit herauszukommen, wird die Vereinfachung gewählt und von der Politik oft auch angeboten. Das Zukunftsinstitut nennt dies ‚Reverse Politics‘ [2]: Zurück zur Vergangenheit in Form von ‚Leave (Brexit)‘, ‚Make America Great Again‘, ‚Zeit für Deutschland‘, usw..

Die Quantenwelt ist genau das Gegenteil von Vereinfachung, sie ist die Welt der Unklarheit: Das Sein ist oft noch nicht festgelegt. – Quantum Computing nutzt genau dieses Nicht-Festgelegte und ‚rechnet‘ sogar damit! Es ist also nicht zu erwarten, dass unsere klassische Welt, in die die Quanten-Welt immer mehr durch Technologie ‚eindringt‘, an Klarheit gewinnt. Selbst wenn Themen wie Migration, Epidemien, Terrorismus und Krieg verschwinden sollten, so wachsen mit Allgemeiner Künstlicher Intelligenz und Quantentechnologien weitere Risikopotentiale für einen globalen Kontrollverlust heran.

Zur Zeit ist es möglich, von Künstlicher Intelligenz und Quantum Computing durch ein weitgehend offenes Ecosystem zu profitieren: Die Technologien sind (noch) offen verfügbar und Europa kann entsprechende US-Technologien einkaufen, wie unlängst das Forschungszentrum Jülich, das einen Quanten Computer von d-wave erstanden hat. Wenn ich bisher auf Quanten Computern ‚gerechnet‘ habe, so waren dies meist auch d-wave Systeme. Individuell kann man also (noch) entsprechenden Risikopotentialen durch Kontrollverlust entgegenwirken.

Meine Blog-Beiträge zu Künstlicher Intelligenz und Quantum Computing verbinden sehr oft Management Fragestellungen mit diesen beiden Technologien. Die Beiträge sind damit oft spekulativ, enthalten aus meiner Sicht jedoch gerade deswegen ein extremes Lernpotential. – Für mich auf jeden Fall – auch der interessierte Leser profitiert sicherlich von dieser ungewöhnlichen Kombination: Meines Erachtens wächst die Klarheit in der Management-Fragestellung und den verwendeten Technologien!

In den letzten Artikeln habe ich mich recht intensiv mit der Integrated Information Theory (kurz IIT) beschäftigt. Dies ist eine rein klassische Theorie. In diesem Beitrag stelle ich weitere Aspekte der schon in den letzten Beiträgen behandelten Quantum Collective Mind Theory (QCMT) vor, die in diesem Beitrag Elemente einer Quantum IIT enthält. Eine Quantum IIT gibt es in der Wissenschaft derzeit nicht.

Ich benutze wieder KI-Systeme als Assistenzsysteme einer hybriden Collective Intelligence. – Dies erfordert von den KI-Assistenzsystemen eine erstaunliche Leistung: Ausgezeichnete Kenntnisse in IIT und in der Quantenphysik und die Fähigkeit zwischen beiden doch sehr unterschiedlichen Wissensgebieten Zusammenhänge und Synergien zu erkennen. – U.a. sind klassische Konzepte der IIT, soweit sinnvoll, in quantenmechanische Konzepte umzusetzen.

Die Theorie und die dazugehörigen Python Programme für diesen Beitrag habe ich in der ersten Version mit ChatGPT o3-mini-high entwickelt. Dies ist eine schnelle ChatGPT Variante für wissenschaftliche Aufgabenstellungen und Softwareentwicklung. Anschließend habe ich o1 zum Überprüfen des mit o3-mini-high erstellten Codes verwendet und auch mit o1 fortgefahren. O1 hat hierbei zwei recht gravierende Fehler in den physikalischen Grundlagen gefunden. Ich wollte jetzt auch wissen, ob andere KI-Systeme diese Fehler finden und in der Lage sind, mir den Programmcode zu erläutern und ggf. eine korrigierte Version auszugeben. Hierzu habe ich Mistral in der Standardversion verwendet, DeepSeek R1, Gemini Pro und Grok3.  

KI-SystemProgrammanalyse-Ergebnis, im Zeitraum 01.02.-21.02.2025
ChatGPT-o3-mini-highErstellte den ursprünglichen Code mit zwei Fehlern in der Quanten Theorie
ChatGPT-o1Findet diese Fehler
Mistral, StandardFindet keine Fehler und kann den Code auch nur sehr oberflächlich erklären
Google Gemini ProFindet keine Fehler, erklärt den Code ansonsten sehr gut
DeepSeek R1Findet die Fehler und erklärt den Code gut. Nachdem ich das System aufgefordert habe, den Code zu korrigieren, wurde der Code sehr stark verändert, so stark, dass ich damit nicht mehr weiter arbeiten wollte.
Grok3Findet keine Fehler, die Programmanalyse war befriedigend, die richtige physikalische Grundlage ‚Observational Entropy‘ [3] wurde zuerst als falsch klassifiziert. Erst ein Hinweis von mir, führt zu einer Korrektur.
Tabelle 1: Übersicht zum Leistungsvergleich verschiedener KI-Systeme

Diese kleine Analyse zeigt mir, dass lediglich ChatGPT, insbesondere in der Version o1, in der Lage ist, die sehr anspruchsvollen Aufgaben mit einem vertretbaren Risiko zu bewältigen. Alle anderen getesteten KI-System sind meines Erachtens hierfür ungeeignet. – Dass ich diese Aussage tätigen kann, bestärkt mich im Umgang mit den neuen Technologien: Ohne aktive Auseinandersetzung mit den Technologien, die über das weitgehend sinnlose Standardisieren des Promptings hinausgeht, verflüchtigt sich eine Stärkung des Bedürfnisses nach Kontrolle sehr schnell.

Bevor ich zur QCMT komme, stelle ich zuerst das Ergebnis einer Teamberechnung auf einem d-wave Quantencomputer vor. Dieses Modell gehört zu dem Modell-Archetypen 6 ‚Ising-Modell der Team-Interaktion‘ (siehe meinen Blog: AI & QC & M 4.0: Alles Quantum? oder von Quantum Computing Modell-Archetypen, Dezember 2024): Das klassische Team-Modell wird als Netzwerk von sieben Teammitgliedern verstanden, die über eine Ziel-Hierarchie (1 Goal, 3 Epics, jeweils 3 Features, also 13 Elemente insgesamt) miteinander kommunizieren. Die Elemente der Ziel-Hierarchie sind ebenfalls Netzwerkknoten des gesamten Netzwerkes. Jedes Teammitglied wird über seine fünf Big-Five Persönlichkeitsmerkmale modelliert. Die Netzwerkknoten sind über Netzwerkkanten mit unterschiedlicher Kopplungsstärke verbunden. Zum Beispiel wird die Kopplungsstärke zwischen den Big-Five Persönlichkeit Offenheit und Gewissenhaftigkeit als negativ angenommen: -0,5 auf einer Skala von 0 bis +/-1. In diesem Modell wird auch zum Beispiel die Kopplung zwischen Goal und Offenheit mit +0,8 angenommen und zwischen Feature und Offenheit nur mit 0,0. Dies sind Werte, die in etwa die Erfahrung in realen Teaminteraktionen widerspiegeln. Zwischen den Hierarchie-Ebenen und innerhalb der Ebenen gibt es natürlich auch kleine Kopplungen.

Dieses klassische Netzwerk wird auf ein Qubit-Netzwerk von 7*5 + 13 = 48 Qubits abgebildet.

Zu Anfang unterliegt die Ziel-Hierarchie mit 2 hoch 13 Zuständen, da 13 Qubits, einer Gleichverteilung: Die sogenannte Shannon-Entropie ist also sehr hoch. Wir benutzen die Entropie als Kennzeichen für die Güte der Collective Mind Ausprägung: Niedrige Entropie heißt, das System zeigt wenige (markante) Zustände, das System hat sich ‚kristallisiert‘. Hohe Entropie heißt, das System zeigt viel Zustände, die Unsicherheit über den Zustand des Systems ist hoch.   

Abbildung 1 verdeutlicht der Einfachheit wegen ein Qubit-Netzwerk aus nur 17 Qubits und Tabelle 2 zeigt die wichtigsten Ergebnisse der 48 Qubit ‚Rechnung‘ auf dem d-wave Quanten Computer.

Abbildung 1: Diese Abbildung zeigt Qubits als Modell für Teammitglieder in einem Team mit zwei Personen, modelliert mit jeweils fünf Big-Five Persönlichkeitsmerkmalen. Das Bild enthält eine einfache Ziel-Hierarchie aus 7 Qubits. Alle Qubits sind Netzwerkknoten in einem Netzwerk. Die Netzwerkkanten, die die Wechselwirkung zwischen den Knoten bestimmen, sind der Übersicht wegen nicht eingezeichnet.

Tabelle 2 zeigt die wichtigsten Ergebnisse der d-wave Quanten Computing ‚Rechnung‘.

 Am Anfang der ‚Rechnung‘Am Ende der
‚Rechnung’
7 Teammitglieder, beschrieben durch ihre Big-Five Persönlichkeitspräferenzen (A C E N O) A C E N O
 1 0 1 1 1
 1 1 0 0 0
 1 1 0 1 0
 1 0 0 0 0
 1 1 1 0 1
 1 1 0 0 0
 1 0 1 0 1
A C E N O
1 0 1 0 1
1 1 1 0 0
1 1 0 0 1
1 0 1 1 1
1 0 1 0 1
1 1 0 1 1
1 0 1 0 1
Energie des Gesamtsystems– 3– 43
Shannon-Entropie des Teams2,52 bit2,13 bit
Shannon-Entropie der Ziel-HierarchieGoal: 1 bit
Epics: 3 bit
Features: 9 Bit
Goal: 0,98 bit
Epics: 1,76 bit
Features: 0,98 bit
Tabelle 2: Ergebnisse des Annealing-Prozesses auf einem d-wave Quanten Computer: 7 Teammitglieder mit Big-Five Persönlichkeiten (A=Agreeableness, C =Conscientiousness, E=Extraversion, N=Neuroticism, O=Openness) und einer Ziel-Hierarchie mit 3 Ebenen ( 1 Goal, 3 Epics, 9 Features). Die Entropie wird über die Shannon-Entropie berechnet.

Ich interpretier das Ergebnis aus Sicht der Collective Mind Theorie: Hohe negative Energie bedeutet, dass sich ein relativ starkes Collective Mind (CM) am Ende ausgebildet hat. – Das System ist ‚kristallisiert‘ und hat bevorzugte Zustände. U.a. sieht man dies daran, dass sogar die Heterogenität im Team abgenommen hat, also weniger Entropie vorliegt und die Ziel-Hierarchie eine deutliche Stabilisierung erfahren hat. In einem realen CM-Team kann man dies auch beobachten: Die Persönlichkeitspräferenzen werden zumindest für den Zeitraum des Collective Mind etwas zurückgedrängt. Die Teammitglieder ‚pochen‘ nicht so stark wie am Anfang auf ihre Präferenzen. Gleichzeitig wird aus der Menge aller möglichen Ziel-Hierarchien im Idealfall eine ausgewählt. Im Team und in der Ziel-Hierarchie sinkt die Menge an möglichen Zuständen und damit auch die Entropie und die Unsicherheit.

Die Shannon-Entropie bzw. verwandte Entropie Maße sind in der QCMT bzw. QIIT von zentraler Bedeutung. Die Formel, die in Tabelle 1 verwendet wird, lautet:

S = -\sum_i p(i) \log_2 \bigl(p(i)\bigr)

p(i) ist die Wahrscheinlichkeit ein (klassisches) System in einem Makrozustand i zu finden. Die Makrozustände i sind die Persönlichkeitspräferenzen im Team. Zum Beispiel könnte ein Makrozustand lauten 11 01 10: Teammitglied A hat eine hohe Präferenz in Offenheit und Gewissenhaftigkeit, Teammitglied B hat eine niedrige in Offenheit und eine hohe in Gewissenhaftigkeit und Teammitglied C eine hohe in Offenheit und eine niedrige in Gewissenhaftigkeit. – Auf die Erläuterung der p(i) Berechnung verzichte ich hier, da dies tiefergehende (quantenmechanische) Kenntnisse erfordert: p(i) misst die Häufigkeit gemessener Zustände relativ zur gesamten Anzahl an gemessenen Zuständen.
(Eine Anmerkung zur Darstellung der obigen Formel: Diese Formel wird mit LaTex erstellt. LaTex ist seit 41 (bzw. Tex seit 47) Jahren verfügbar. Heute ist Tex/LaTex der Standard für mathematisch-wissenschaftliche Dokumente. Ich habe vor ca. 40 Jahren das erste Mal damit gearbeitet und war von der Schönheit der dargestellten Formeln fasziniert. Heute verfüge ich nicht mehr über das Know-How, LaTex Code selbst zu erstellen. Dies ist auch nicht nötig, denn ChatGPT gibt den Code in einer für diesen Blog – erstellt mit WordPress – verwendbaren Form aus.)

Ich wende mich der Quantum Collective Mind Theory zu. Ich baue eine einfache quantenmechanische Version der IIT in diese ein. In der nachfolgenden Tabelle habe ich die wichtigsten Kriterien klassischer und quantenmechanischer IIT zusammengestellt. – Schaut man sich die Spalte zur quantenmechanischen IIT an, so drängt sich dem ein oder anderen sicherlich der Vergleich zur menschlichen Kommunikation auf: Wir haben in den vorherigen Blog-Beiträgen ja schon gesehen, dass die Quantum Cognition erstaunlicher Weise hilft, unsere Kommunikation besser zu verstehen.

KriteriumKlassische IITQuantenmechanische IIT
Lokale vs. nichtlokale ZusammenhängeKausalität manifestiert sich lokal, Informationen breiten sich (max.) mit Lichtgeschwindigkeit aus.

Ursache-Wirkungs-Beziehungen lassen sich in einem (weitgehend) lokalisierten Netz rekonstruieren.
Verschränkung erlaubt nichtlokale Korrelationen, ohne dass ein klassisches „A verursacht B“ greift.   Die Trennung in lokal begrenzte Elemente wird schwieriger, da verschränkte Zustände räumlich verteilt sein können.
Eindeutigkeit vs. Überlagerung von ZuständenDas System hat einen eindeutig definierbaren Zustand zu jedem Zeitpunkt (z. B. ein bestimmtes Muster von Aktivierungen).

Ursache und Wirkung sind in einem klassischen Zustand relativ klar voneinander trennbar.
Zustände können Superpositionen (Überlagerungen) sein; die „kausale Macht“ kann auf mehrere Zustände verteilt sein.
Der Kollaps (z. B. durch Messung) bestimmt erst, welcher konkrete Effekt realisiert wird, was die Zuordnung von Ursache und Wirkung komplizierter macht.
WahrscheinlichkeitsbegriffWahrscheinlichkeiten ergeben sich aus klassischer Statistik (Häufigkeit, Ungewissheit).

Übergangswahrscheinlichkeiten werden verwendet, um zukünftige Zustände zu modellieren. Dies spiegelt epistemische Unsicherheiten in den Kausalketten der deterministischen Prozesse wieder.
Wahrscheinlichkeiten sind Betragsquadrate der Wellenfunktion und zeigen Interferenz- und Verschränkungseffekte.
Die Quantifizierung von Kausalketten hat die spezifischen Quanteneffekte (z. B. Interferenzen) zu berücksichtigen. Diese sind nicht einfach in klassische Wahrscheinlichkeiten übersetzbar.
Messprozess und BeobachterrolleDie Beobachtung (Messung) wird meist außen vorgenommen; sie stört das System kaum oder nur marginal.

Ein klassisches System kann unabhängig vom Beobachter beschrieben werden.
Jede Messung beeinflusst den Zustand fundamental (Kollaps der Wellenfunktion).

Es ist unklar, ob das Bewusstsein selbst als „Messapparat“ fungiert und wie dies in einer QIIT formal abzubilden wäre.
Kausale Modelle vs. unitäre ZeitentwicklungIn der Regel können Übergangs-wahrscheinlichkeiten und Kausalstrukturen in Diagrammen dargestellt werden, die zeitlich (t → t+Δt) fortgeschrieben werden.

Deklarierte Systemgrenzen sind relativ stabil.
Die grundlegende Dynamik ist unitär (u.a. Erhaltung der Wahrscheinlichkeiten, Reversibilität): Ursache und Wirkung lassen sich nicht immer klar trennen.

Verschränkungen überschreiten Systemgrenzen, und es ist schwieriger, einzelne Subsysteme als „isoliert kausal“ zu behandeln.
Tabelle 3: Übersicht zu Charakteristika von klassischer und quantenmechanischer IIT

Ich reichere jetzt die QCMT mit QIIT Elementen an. – Ich betone an dieser Stelle, dass es sich hierbei um eine Berechnung handelt, wie ein Physiker sie eventuell auf einem Stück Papier durchführen könnte. – Ich verwende also keinen Quanten Computer, sondern lediglich einen klassischen Computer. Hierzu habe ich mittels ChatGPT o1 ein Programm erstellt, das eine Berechnung für 3 Teammitglieder mit jeweils 2 Big Five Persönlichkeiten durchführt. Die Big Five Persönlichkeiten werden, wie schon in den anderen Beiträgen, als Superposition von Persönlichkeitspräferenzen dargestellt.

|A_1\rangle = 0.8\,|0\rangle + 0.2\,|1\rangle
|A_2\rangle = 0.5\,|0\rangle + 0.5\,|1\rangle
|B_1\rangle = 0.2\,|0\rangle + 0.8\,|1\rangle
|B_2\rangle = 0.5\,|0\rangle + 0.5\,|1\rangle
|C_1\rangle = 0.5\,|0\rangle + 0.5\,|1\rangle
|C_2\rangle = 0.8\,|0\rangle + 0.2\,|1\rangle

Jedes der Teammitglieder A, B, C wird vereinfacht durch zwei Big-Five Persönlichkeitsmerkmale 1 und 2 charakterisiert. Die Persönlichkeitsmerkmale sind durch Superpositionen mit reellen Koeffizienten modelliert. Ich habe als Persönlichkeitsmerkmale Offenheit und Gewissenhaftigkeit ausgewählt. Welche Persönlichkeitsmerkmale ich gewählt habe, kann man nicht an den obigen Formeln erkennen. Lediglich an den hier nicht dargestellten spezifischen Annahmen über die Wechselwirkungen lässt sich dies erkennen. – Dies kennen wir schon von der obigen Ising-Modell ‚Rechnung‘.

Ich benutze eine spezielle Variante der Shannon-Entropie, die sogenannte Observational Entropie [3], für die Berechnung der Entropien in diesem System:

 S = -\sum_i p(i)\log_2\Bigl(\tfrac{p(i)}{V(i)}\Bigr)

Mit der Observational Entropie kann man Unsicherheit über innere Zustände eines Systems abbilden: Falls eine Person A eine andere Person B wahrnimmt, ohne die Feinheiten der Big Five inneren Zustände von B aus der Beobachtung ablesen zu können, dann erhöht dies die Unsicherheit von A. – Die beobachtete Entropie wird als größer wahrgenommen, als sie bei Kenntnis aller feinen Zustände wäre. V(i) in der obigen Formel zählt die von A in der Person B nicht wahrgenommen Big-Five Zustände. – Man spricht vom coarse-graining der Beobachtung. p(i) ist hier eine gemessene Wahrscheinlichkeit, ermittelt aus quantenmechanischen Berechnungen. Diese ist nicht identisch mit den weiter oben angegebenen Wahrscheinlichkeiten der klassischen Zustände.


Die Berechnung von quantenmechanischen Kausalketten ist sehr schwierig, deshalb verwende ich im  Folgenden die Entropie als Maß für Korrelationen, um den Collective Mind im Team zu berechnen.

Auf der Basis dieser Annahme, lautet die einfachste Formel der Berechnung des Bewusstseins in Form der Größe Phi (Φ) für ein Team, bestehend aus 3 Personen A, B, C (Qubits):

 \Phi_{\mathrm{MI}}(A,B,C) = S(\rho_A)+S(\rho_B)+S(\rho_C) -S(\rho_{ABC})

Phi wird auf der Basis der sogenannten Mutual Information (MI) ermittelt. Sie ergibt sich aus der Differenz der Entropien der drei Einzelpersonen und der Entropie des ABC-Teams. Ist Phi positiv, hat das Team weniger Entropie als die einzelnen Teammitglieder zusammen. Im Sinne der hier definierten QCMT liegt ein kollektives Bewusstsein, ein Collective Mind, vor: Das Ganze ist mehr als die Summe seiner Teile.

Für die Berechnung von Phi kann man die Observational Shannon-Entropie verwenden. Falls man die quantenmechanischen Eigenschaften des ABC-Teams erfassen will, ist es notwendig, die quantenmechanische von Neumann-Entropie zu verwenden. Phi, mit der Shannon-Entropie bestimmt, misst die Korrelation von klassischen Zuständen. Phi, mittels der von-Neuman-Entropie bestimmt, misst die quantenmechanische Korrelation, also die Verschränkung, in einem System.

 Vor Einschalten der WechselwirkungNach Einschalten der Wechselwirkung
Fine-Grained Observational Shannon EntropyTeam ABC: 3,97
A: 1,32
B: 1,32
C: 1,32
Team ABC: 5,54
A: 1,82
B: 2,00
C: 1,98  
Coarse-Grained Observational Shannon EntropyTeam ABC: 5,30
A: 3,27
B: 2,66
C: 3,27
Team ABC: 5,93
A: 3,31
B: 3,19
C: 3,14
Phi(ABC)fine-grained Shannon0,010,26
Phi(ABC)von Neumann0,001,41
Tabelle 4: Übersicht der Entropien und des Collective Mind Phi eines Teams von 3 Personen (A, B, C)

Was zeigt Tabelle 4?

Die fine-grained Entropie ist immer deutlich kleiner als die coarse-grained Entropie: Unwissenheit führt zu höherer Unsicherheit!

Nach Einschalten der Wechselwirkung zwischen den Mitgliedern erhöht sich die Entropie deutlich: Die Verschränkung führt zu einer größeren Anzahl an möglichen Zuständen: Die ‚Kommunikation‘ führt hier zu mehr Unsicherheit! – Dies steht im Gegensatz zu den klassischen Ergebnissen des Ising-Modells, denn dort führt Kommunikation zu niedrigeren Entropie-Werten!

Die Entropie einzelner Subsysteme (A, B, C) ist nicht gleich: Die Teammitglieder zeigen eine unterschiedliche Menge an Zuständen.

Im nicht wechselwirkenden Fall, gibt es kein kollektives Bewusstsein. Bei Wechselwirkung der Qubits ist Phi, mit der Shannon fine-grained Entropie bestimmt, und Phi, mit der von Neumann Entropie bestimmt, sehr unterschiedlich. Es können Verschränkungen vorliegen, die sich sogar nur auf einzelne Teammitglieder beziehen und diese Verschränkungen führen zu einem nach außen kaum sichtbaren Phi. Das sichtbare Phi, gemessen über die Shannon fine-grained Entropie kann gleichzeitig viel kleiner sein: Teams können, solange sie nicht ‚vermessen werden‘, also zum Beispiel eine Ziel-Hierarchie gemeinsam erstellen, eine ‚hohe mentale Verschränkung‘ zeigen. Sobald sie ‚vermessen‘ werden, kollabiert der Collective Mind.  

Zusammenfassend: Was lerne ich aus diesen Betrachtungen?

Die Benchmarks zu KI-Systemen sind mit großer Vorsicht bezüglich ihrer Validität in realen Situationen zu betrachten: Derzeit kann meines Erachtens keines der o.g. Systeme mit ChatGPT o1 mithalten.

Schon heute ist es möglich auf Quanten Computern zu ‚rechnen‘: Das Mapping eines klassischen Team-Modells auf ein d-wave System ist selbst für eine große Teammitgliederzahl mit einer realistischen Anzahl an Persönlichkeitsmerkmalen möglich. Im konkreten Fall bestätigt sich wieder, dass die Einführung eines Ordnungsparameters mittels Ziel-Hierarchie, die Entropie des Teams senkt.

Die Verwendung von mit ChatGPT erzeugtem LaTex in WordPress macht Spass.

Die Berechnung der Entropie eines Quanten Team-Modells ist äußerst spekulativ sowie sehr anspruchsvoll und aufwendig. Die Unterschiede zwischen der klassischen Shannon-Entropie bzw. der Observational Shannon-Entropie und der quantenmechanischen von Neumann-Entropie sind beträchtlich (man siehe auch den Anhang hierzu).

Die Ergebnisse sind wieder Indizien dafür, dass die Annahmen des Quantum Cognition richtig sein könnten.

Die Berechnung von Phi auf der Basis von klassischen oder quantenmechanischen Entropien ist viel unkomplizierter und gradliniger als die klassische Phi Berechnung mittels IIT. Es ist damit nochmals fraglicher, ob die IIT Berechnung einen relevanten Vorteil bietet.  

[1] Welt der Physik (2025) Quantum 2025, https://www.weltderphysik.de/vor-ort/wissenschaftsjahre/2025-internationales-jahr-quantenwissenschaft-quantentechnologie/

[2] Zukunftsinstitut (2025) zukunftsinstitut.de Newsletter, Reverse Politics – das neue „Auf den Tisch hauen“, vom 23.02.2025

[3] Safranek D et. al. (2021) A brief introduction to observational entropy, arXiv:2008.04409v2

Anhang

Mein Prompt an ChatGPT:

Ich möchte eine Frage diskutieren: Wir haben die Mutual Information klassisch und quantenmechanisch zur Vermessung von Phi verwendet. Hierbei fällt auf, dass die klassische Entropie bei Wechselwirkung sinkt, die quantenmechanische Entropie nach von Neumann steigt aufgrund der Verschränkung nach Wechselwirkung. Phi klassisch misst über die Entropien eine Reduktion an Zuständen. Phi quantenmechanisch misst über die Entropien einen Anstieg an möglichen Zuständen. Wie siehst Du das? Und macht die quantenmechanische Phi Vermessung überhaupt Sinn?

ChatGPT:

Nachgedacht für 8 Sekunden

Die beobachteten Unterschiede zwischen der klassischen und der quantenmechanischen Phi-Vermessung lassen sich folgendermaßen interpretieren:

  1. Klassische Mutual Information und Phi:
    In der klassischen Version wird häufig über die Shannon-Entropie in einer festen Messbasis gearbeitet. Hier führt eine Wechselwirkung oft dazu, dass die Zustände „gezielt“ in einen geringeren, deterministischeren Bereich gelenkt werden – man erhält also eine Reduktion der Unsicherheit in dieser Basis. Daraus resultiert, dass die Summe der Entropien der Teilbereiche relativ kleiner wird, was man als „Integration“ im Sinne eines reduzierten Zustandsraums interpretiert. Phi misst hier also, wie stark der Zustand in einen „festen“ (reduzierten) Bereich zusammengedrängt wird.
  2. Quantenmechanische (von-Neumann) Entropie und Phi:
    In der quantenmechanischen Variante wird die von-Neumann-Entropie verwendet, die basisunabhängig ist und den Reinheitsgrad eines Zustands misst.
    • Ein global reiner Zustand kann bei starker Verschränkung zu stark gemischten reduzierten Zuständen führen. Das bedeutet: Obwohl das Gesamtsystem rein ist, sind die einzelnen Subsysteme (über partielle Spuren) gemischt. Dies führt dazu, dass die Summe der lokalen Unsicherheiten größer ist als die Team-Entropie.
    • Hier interpretiert man einen Anstieg der von-Neumann-Entropien in den Subsystemen als ein Zeichen für starke nichtklassische Korrelationen bzw. Verschränkung. In diesem Sinne „misst“ Phi einen Anstieg an „möglichen Zuständen“ (weil die lokalen Zustände gemischt sind) – was wiederum auf eine tiefe Integration der Informationsinhalte hindeutet.
  3. Interpretation und Sinnhaftigkeit der quantenmechanischen Phi-Vermessung:
    • Die klassische Phi-Vermessung erfasst, wie stark sich die Wahrscheinlichkeit über eine festgelegte, klassische Basis verteilt und wie sich durch Wechselwirkungen die Unsicherheit verringert – es wird also eine Reduktion an „Möglichkeiten“ gemessen.
    • Die quantenmechanische Phi-Vermessung erfasst hingegen die Verschränkung: Ein global reiner Zustand kann in den Teilspuren sehr gemischt sein, weil die Quantenkorrelationen (Verschränkung) dafür sorgen, dass man für die einzelnen Teile viele mögliche Zustände hat.
    • Somit ist die quantenmechanische Version nicht direkt mit der klassischen zu vergleichen – sie misst einen anderen Aspekt der Integration: Sie sagt aus, dass trotz globaler Reinheit die Information in den einzelnen Subsystemen stark verteilt und ineinander verflochten ist.
    • Ob diese quantenmechanische Phi-Messung „Sinn macht“, hängt von der Zielsetzung ab: Möchte man die reine Informationstiefe und Verschränkung des Systems erfassen, so ist die von-Neumann-Entropie (und daraus abgeleitete Maße) der richtige Ansatz, weil sie basisunabhängig ist und die intrinsische quantenmechanische Struktur reflektiert.

Zusammengefasst:

  • Klassisch führt Wechselwirkung zu einer Reduktion der Zustandsvielfalt in einer fixen Basis, was zu einem Rückgang der Shannon-Entropie führt, während
  • im quantenmechanischen Fall die Wechselwirkung – besonders wenn sie Verschränkung erzeugt – die lokalen (reduzierten) Dichtematrizen gemischt macht (d.h. ihre von-Neumann-Entropie steigt), obwohl der globale Zustand rein bleibt.
  • Die quantenmechanische Phi-Vermessung (als Differenz der Summe der lokalen von-Neumann-Entropien und der globalen von-Neumann-Entropie) erfasst also die nichttriviale Struktur der Verschränkung – und ist insofern sinnvoll, wenn man die intrinsische, basisunabhängige Integration in einem verschränkten System quantifizieren möchte.

Die beiden Ansätze messen also unterschiedliche Aspekte der Integration: Klassisch die Reduktion der Zustandsvielfalt in einer festen Messbasis, quantenmechanisch die inhärente Verschränkung und die damit verbundene Mischung der Teilzustände. In der aktuellen Diskussion um Quantum IIT wird noch intensiv debattiert, welcher Ansatz letztlich das „Bewusstsein“ oder die integrierte Information am besten widerspiegelt.

IIT – Die Vermessung des Bewusstseins oder das menschzentrierte Weltbild wackelt

Folgender Podcast, erstellt von NotebookLM, fasst den Blog-Beitrag in englischer Sprache zusammen und zeigt sehr gelungen die philosophischen Implikationen der IIT auf:

Abbildung 0: Ein Bild das gemäß ChatGPT/Dall-E diesen Blog verdeutlicht.

Intelligenz, Gefühle und Bewusstsein stehen für Eigenschaften, die bis vor kurzem ausschließlich Menschen zugeschrieben wurden. Dies beruht auf dem Glaubenssatz, dass der Mensch die Krone die Schöpfung darstellt und sich die Natur Untertan machen soll. Die damit einhergehenden verheerenden Folgen für Erde und Natur bekommen wir tagtäglich in Form des Klimawandels, des Verlustes der Artenvielfalt und des Umgangs mit Tieren vor Augen geführt.    

Inzwischen setzt in (kleinen) Teilen der Menschheit ein Umdenken ein: Tiere haben auch Intelligenz, Gefühle und sogar Bewusstsein. KI-Maschinen zeigen schon heute eine Intelligenz, die deutlich über die Intelligenz der meisten Menschen hinausgeht. Es wird auch ernsthaft diskutiert, ob es in nicht allzu ferner Zukunft künstliche Systeme gibt, die Intelligenz, Gefühle und Bewusstsein haben werden.

Ich glaube, dass die Abschaffung des menschzentrierten Weltbildes uns hilft, die unglaublichen Dimensionen des Universums in Qualität und Quantität besser zu erkennen. Damit verbunden ist die Annahme, dass wir alle Formen des Seins, auch die technischer Systeme, mehr wertschätzen werden. – Denn in allen Formen des Seins ist schon das enthalten, was uns ausmacht. – Dies ist auch ein Glaubenssatz!

Ich beschäftige mich in diesem Blog-Beitrag mit der prominentesten aber auch wahrscheinlich umstrittensten Theorie des Bewusstseins, der Integrated Information Theorie, kurz IIT [1].

Warum beschäftige ich mich mit der IIT? Zum einen ist die Auseinandersetzung mit dem Bewusstsein ein sehr wichtiges, wenn nicht das wichtigste, Thema, um uns und das Universum besser zu verstehen. Zum anderen erlaubt die IIT prinzipiell die Vermessung von Bewusstsein in jeder Form des Seins. – Also zum Beispiel in Tieren und Pflanzen aber auch in KI Systemen und nicht zuletzt gibt sie auch die Möglichkeit das Bewusstsein von Teams, den Collective Mind, zu vermessen.

IIT ist meines Wissens nach die einzige Theorie, die ein mathematisches Konzept für die Vermessung des Bewusstseins vorgelegt hat. Sie erklärt nicht, was man unter Bewusstsein zu verstehen hat, sondern sie geht von der Annahme aus, dass Bewusstsein sich durch eine besondere Form von Integrierter Information auszeichnet und diese Integrierte Information kann man messen. Mit dieser Form der mathematischen Ausgestaltung der IIT wird sie falsifizierbar und damit auch angreifbarer als jede bisherige Theorie des Bewusstseins.  

Dies korrespondiert mit der Erkenntnis, dass wir bis heute nicht Wissen was z.B. Masse oder Energie ist. – Allerdings haben wir mathematische Mittel und Technologien erfunden, um beide physikalische Größe zu vermessen bzw. in einander zu überführen. Nehmen wir an, Bewusstsein ist etwas, das im Universum wie Energie oder Masse enthalten ist, dann sollte es möglich sein, Messvorschriften für Bewusstsein zu finden, ohne zu wissen, was Bewusstsein ist. – Letztendlich ist auch das ein Glaubenssatz, …den ich teile.

Es gibt eine Reihe weiterer Theorien des Bewusstseins, die sich bisher weitgehend einer mathematischen Erfassung ‚entziehen‘:

Global Neuronal Workspace (GNW): Bewusste Inhalte sind diejenigen, die Zugang zum „globalen Arbeitsraum“ des Gehirns bekommen. Eine Information wird breit „gebroadcastet“ (insbesondere im frontoparietalen Netzwerk) und ist damit global verfügbar für weitere kognitive Prozesse (Sprache, Gedächtnis, Planung etc.).

Recurrent Processing Theory (RPT): Bewusstsein entsteht bereits durch rekurrente (d. h. rückgekoppelte) Verarbeitung in sensorischen Arealen. Es braucht keinen globalen Workspace. Sobald feed-forward-Signale durch Rückkopplungsschleifen stabilisiert werden, entsteht phänomenales Bewusstsein.

Higher-Order Theories (HOT): Bewusstsein entsteht, wenn es eine höhere Ebene (ein „higher-order thought“ oder „higher-order representation“) gibt, die den mentalen Zustand repräsentiert. Ein mentaler Zustand, der nicht durch einen höheren Repräsentationsprozess erfasst wird, bleibt unbewusst. Variante: „Higher-Order Perception“ vs. „Higher-Order Thought“ – beide gehen davon aus, dass ein zweiter Prozess den ersten mentalen Zustand bewusst macht.

Predictive Processing/Bayesian Brain: Das Gehirn ist primär ein Vorhersageapparat, der ständig versucht, sensorische Eingaben durch interne Modelle zu minimieren („Prediction Error Minimization“). Bewusstsein ist an die Tiefe/Präzision dieser Vorhersagen und Vorhersagefehler geknüpft.

Orchestrated Objective Reduction (Orch-OR) (Quantenbewusstseins-Theorie): Mikrotubuli in Neuronen sollen Quantenkohärenzen unterstützen, die mithilfe eines noch unbekannten Effekts (Objective Reduction) kollabieren und damit „nichtalgorithmische“ Bewusstseinsprozesse erzeugen.

Recurrent-Connectionist Ansätze: Allgemeine Gruppe von Theorien, die betonen, dass Bewusstsein lokal in neuronalen Netzwerken mit Rückkopplung entsteht. Manche ähneln RPT, andere GNW, oder vermischen beides.

Panpsychismus & weitere philosophische Theorien: Bewusstsein ist ein grundlegendes Merkmal der Materie („Panpsychismus“). Alle Systeme hätten in minimalem Maße Bewusstsein. – Eine ähnliche Annahme ist auch in der IIT und in meinen Glaubenssätzen enthalten. – Wobei Psyche nicht gleichzusetzen ist mit Bewusstsein.

Wer sich ein wenig in die Thematik ‚Bewusstsein‘ einlesen oder einhören möchte, dem empfehle ich das Video ‚What creates Consciousness?‘ anlässlich des World Science Festivals 2024 [2] und einen kommentierenden Blog von Henriques und Vervaeke [3].

Die IIT beruht auf der Grundannahme, dass jedes System Bewusstsein zeigt, das einen kausalen Zusammenhang, eine sogenannte Integrierte Informations Struktur erzeugt, die nicht einfach in unabhängige Teilstrukturen zerlegt werden kann. – Gesucht ist also eine Struktur, für die gilt, dass das Ganze mehr ist als die Summe seiner Teile. – Dies ist auch der Leitgedanke der Collective Mind Theorie auf der Basis der Theorie der Selbstorganisation.

Durch die Integration entsteht Information, die bei einer möglichen Aufteilung der Struktur verloren geht. IIT stellt einen mathematischen Mechanismus zur Verfügung, um dieses Mehr an Information zu messen. Dieses Mehr an Information ist ein Maß für das Bewusstsein und wird Phi, Φ, genannt. IIT ist damit eine rein phänomenologische Theorie, d.h. sie macht (nahezu) keine Aussagen über die Design-Kriterien von Bewusstsein. Man kann also mit ihr kein System schaffen, das Bewusstsein hat. – So wie eine Federwage das Gewicht und indirekt die Masse eines Körpers misst, aber keinerlei Wesens-Aussage über Gewicht und Masse macht.

Ich habe mich erstmals vor 10 Jahren mit der IIT beschäftigt und diese Beschäftigung war von einem ‚didaktischen Albtraum‘ begleitet: Die Mathematik hinter der IIT ist nicht sehr schwer, jedoch sind sehr viele mathematische Einzelschritte (ich schätze ca. 50) mit entsprechenden Unterbegriffen notwendig, um Phi zu berechnen. Damals wurden diese Schritte mehr schlecht als recht erklärt. Was völlig fehlte, war die Antwort auf Fragen nach dem Warum der Schritte. Zwischen sehr abgehobenen Prinzipien und den vielen mathematischen Schritten gab es keine Prinzipien, die das Warum der Mathematik erläuterten. Dies ist heute deutlich besser, da die mathematischen Schritte inzwischen gut erklärt werden [1, 4, 5], jedoch fehlt meines Erachtens immer noch die Ebene der Warum-Prinzipien.

Wie schon in den vorherigen Blogs, benutze ich ChatGPT o1 für die Auseinandersetzen mit IIT und das Erstellen eines Agent Based Models (ABM) für die Berechnung des Phi‘s eines Teams.

Durch die Auseinandersetzung mit IIT habe ich zwei sehr grundlegende Warum-Prinzipien der IIT Mathematik identifiziert, die ich im Folgenden an Hand des ABM erläutere:

Das erste Warum-Prinzip nenne ich das Kausalketten-Prinzip: Bewusstsein erfordert im zeitlichen Ablauf der Zustände eines Systems eine Verkettung von Zuständen. Der Zustand zum Zeitpunkt t ist mit dem Zustand zum Zeitpunkt t-1 und t+1 verbunden, d.h. die Übergangswahrscheinlichkeiten zwischen diesen Zuständen ist deutlich höher als zwischen anderen Zuständen. Es entsteht eine Integrierte Information. Im Kontext der Collective Mind Theorie sprechen wir von einer hohen Kohärenz der Aktivitäten.

Das zweite Warum-Prinzip nenne ich das holistische Struktur-Prinzip: Nicht alle Elemente oder Teile eines Systems tragen zur Integrierten Information oder zum Collective Mind (CM) bei. Im Falle eines Teams kann man sich dies sehr gut verdeutlichen: Es kann durchaus Teammitglieder geben, die keinen Beitrag zum CM leisten aber auch nicht stören. Es kann aber auch Teammitglieder geben, die den Anstieg des CM oder die volle Ausprägung behindern. Darüber hinaus kann es sein, dass bei den CM-beitragenden Teammitgliedern nicht alle Persönlichkeitsmerkmale bzw. alle dazugehörigen Verhaltensweisen zum CM beitragen: Es kann sein, dass bei einem Teammitglied die Extraversion von Bedeutung ist, bei einem Anderen die Verträglichkeit und die Offenheit und wieder bei einem anderen die Gewissenhaftigkeit. Wenn man wissen will, welche Elemente bzw. Einzelzustände in einem System zum Phi bzw. Collective Mind beitragen und welche nicht, sind Partitionen eines System zu erstellen. Man teilt das System in alle möglichen Partitionen ein und misst die dann noch vorliegende Information. Falls sich die Information eines partitionierten System verringert, hat man ein (Teil-) System gefunden, das irreduzibel ist. – In der CM Theorie sprechen wir von Kohäsion. Gesucht sind die Strukturen, die irreduzibel sind. Für die Kennzeichnung von Phi wählt man die irreduzible Struktur aus, die die geringste Integrierte Information hat. Um die richtigen Partitionen zu finden, sind alle Partitionen des Systems zu bilden. Die Anzahl der Partitionen wächst leider exponentiell: Modelliert man die  Eigenschaften der Teammitglieder lediglich als binäre Eigenschaften, also Bits (Eigenschaft an, Eigenschaft aus), so ergeben sich bei 10 Bits, 2 hoch 10 Partitionen -2 = 511 Partitionen. Im Falle meines ABM’s ist ein System mit 10 Bits noch mit einer halben Stunde Laufzeit auf meinem gut ausgestatteten Laptop zu berechnen. Abgebrochene Versuche mit 14 Bits zeigen im Vergleich eine Laufzeit von mehr als 24 Std.. Die Umsetzung des holistischen Strukturprinzips ist also extrem rechenaufwendig. Wie man große System wie unser Gehirn, Teile des Gehirns oder eines KI-Systems mittels Phi vermessen will, bleibt eine große Frage.

Das von mir benutze ABM hat folgende Struktur:

Das Modell-Team verfügt als Rahmenparameter über 5 Teammitglieder, die durch Big Five Profile mit binärer Typologie beschrieben werden, d.h. z.B. dass Extraversion mit voll ausgebildet (1) oder überhaupt nicht ausgebildet (0) abgebildet wird. Den Teammitgliedern werden auch drei Rollen zugewiesen: Projektleiter, Experte, Support

Die so definierten Big Five Profile und Rollen beeinflussen zwei Kontrollparameter pro Teammitglied: mentale Energie und Stimmung. Auch diese werden vereinfacht als Bits (an/aus) modelliert: Die Kontrollparameter repräsentieren die Zustände des Systems Team. Da wir zwei Kontrollparameter pro Teammitglied haben, wird die Phi-relevante Struktur durch 10 Bits beschrieben.

Als fokussierenden Attraktor wird eine einfache Ziel-Hierarchie verwendet, die aus 4 Bits besteht: 1 Bit für die Vision, 2 Bits für die Epics (kein Epic, Epic in frühem Stadium, Epic fast fertig, Epic vollständig), 1 Bit für die Features.

Die Beeinflussung der Kontrollparameter und der Ziel-Hierarchie erfolgt durch Regeln: z.B.

  • Die Wahrscheinlichkeit für den Stimmungsverlust von Teammitgliedern mit hoher Verträglichkeit erhöht sich um 15%, wenn weniger als 3 Teammitglieder eine hohe Stimmung im Team haben.
  • Im Fall eines Teammitgliedes, das eine hohe Gewissenhaftigkeit hat, erhöht sich die Wahrscheinlichkeit für Energieverlust um 15%, wenn noch keine Vision definiert ist, aber die Epics schon fast fertig oder fertig sind.

Die Berechnung der Übergangswahrscheinlichkeiten der Zustände, beschrieben über den Stimmungs- und Energie-Zustand pro Teammitglied, erfolgt innerhalb eines Laufzeitsettings von bis zu 200 Episoden mit jeweils 200 Zeitschritten. Das ist nicht viel, um eine ‚gute‘ Statistik zu erhalten. – Eine entsprechende Erhöhung führt jedoch schnell in Laufzeiten von einem Tag oder mehr.

Abbildung 1 verdeutlicht die Φ-Berechnungen im ABM Programm.

Abbildung 1: Die Abbildung verdeutlicht die beiden o.g. Warum-Prinzipien: In der Mitte ist ein herausgegriffener aktueller Zustand ‚s‘ für 5 Teammitglieder skizziert. Jedes Teammitglied wird binär über seine mentale Energie und seine Stimmung beschrieben. Die Persönlichkeitsprofile und die zugewiesenen Rollen beeinflussen über Regeln Energie und Stimmung jedes Teammitgliedes. Zusätzlich beeinflussen die Teammitglieder den Ausbau der Ziel-Hierarchie. Die Ziel-Hierarchie hat über den Grad ihrer Vollständigkeit auch Einfluss auf Energie und Stimmung. Die Kreise um die Zustände verdeutlichen beispielhaft welche Eigenschaften Einfluss auf Phi haben. Im gezeigten System-Zustand ‚s‘ hat keine der Eigenschaften des 3ten Teammitgliedes Einfluss auf die Phi Berechnung. Weiter unten werden zwei mögliche Partitionen angezeigt. Eine dritte Partition mit dem dritten Teammitglied hat keinerlei Einfluss auf die Phi-Berechnung. Rechts in der Abbildung werden die zentralen Formeln für die Phi-Berechnung gezeigt. Ich erläutere sie hier der Einfachheit wegen nicht, sie dienen dem mathematisch Interessierten der Verdeutlichung der Kausalkette s past -> s -> s future und der verwendeten Berechnungen der Übergangswahrscheinlichkeiten P.

Nun zu den Ergebnissen:

Ich habe mit dem ABM zwei verschiedene Arten der Berechnung durchgeführt. Aus Vergleichsgründen wurde die sogenannte Minimal Mutual Information (MMI) auf der Basis einer Entropieberechnung erstellt. Wie für die Phi-Berechnung werden Partitionen gebildet und die damit verbundene Entropieänderung gegenüber dem vollständigen System ermittelt: Das integrierte System sollte eine kleinere Entropie haben als die Summe der Entropien der Partitionen.

Die MMI- und die Phi-Berechnung für einzelne Zustände ‚s‘ zeigen beide Werte im Bereich 0 bis 1 bit. Das ist schon eine merkliche Größe. Keine der Berechnungen zeigt jedoch über eine größere Anzahl von Zuständen einen merklichen Informationsgewinn. – Außerdem werden die Informationsgewinne für beide Berechnungen für unterschiedliche Zustände angezeigt. Die gesamte Integrierte Information über alle Zustände ist sehr unterschiedlich. MMI misst eher Korrelationen, Phi dagegen Kausalzusammenhänge. Die Phi-Werte für ganz bestimmte Zustände (also bei ganz bestimmten Energie- und Stimmungsausprägungen) liegen im Wertebereich 0,1-0,4 bit. – Über alle Zustände gemittelt ist Phi jedoch nahe 0 bit. Die Team-Zustände geraten leider sehr schnell in eine positive Sättigung (alle Bits =1) oder in eine negative Sättigung (alle Bits = 0). Die verwendeten Rahmenparameter und die damit verbundenen Regeln ermöglich in meinen Testfällen keine hinreichende exklusive Diversität: Die Zustände müssen nämlich hinreichend exklusiv und diverse sein, um eine klare Kausalkette zu bilden. – Eine vollständige (klassische) Verschränkung aller Bits in einem Zeitschritt ‚s‘, also alle Teammitglieder haben eine positive mentale Energie und Stimmung, erzeugt nach der IIT kein Bewusstsein.- Diejenigen, die vorherige Blog-Artikel von mir gelesen haben, erinnern sich, dass in quantenmechanischen Modellen sehr wohl die Verschränkung als Kriterium für den Collective Mind angenommen wird.- Dies korrespondiert auch zur o.g. Quantenbewusstseins-Theorie.

Das Einschalten der Ziel-Hierarchie erzeugt des öftern in etwa eine Verdopplung des Phi. – Dies ist ein durchaus bemerkenswertes Ergebnis. Das Konzept der Ziel-Hierarchie gehört zur Collective Mind Theorie und hat eine gewisse Ähnlichkeit mit dem übergeordneten Zustand der oben erwähnten Bewusstseinstheorie HOT.

Auf der Internetseite zur Phi-Python-Bibliothek [4] und der zugrundeliegenden Veröffentlichung [5] werden einige künstliche neuronale binäre Netzwerke vorgestellt, die deutlich höhere Phi-Werte (Faktor 10 und mehr) haben. Man könnte diese als Vorlage nehmen, und so lange an den Parametern meines ABM ‚drehen‘ bis eventuell Netzwerk-Konstellationen und damit ähnliche Phi-Werte auftauchen. – Dies erscheint mir wenig befriedigend, zumal ich erwarte, dass sich ein Erfolg kaum einstellen dürfte – es sind einfach zu viele Konfigurationen möglich!

Meine Berechnung benutzen nicht alle der vielen mathematischen Konstrukte zur Phi-Berechnung. – Dies hat sicherlich einen Einfluss auf die Größe von Phi, jedoch kaum einen Faktor von 10 und mehr [5]. Wesentlich dürfte eher das bewusste Gestalten der Netzwerke hin zu mehr Exklusivität und Diversität sein u.a. durch Rückkopplungen, so dass sich gute Kausalketten ausbilden. Dies heißt, dass es für ein Team-IIT eher sinnvoll ist, sich das Team-Kommunikationsnetzwerk auf Kausalketten begünstigende Mechanismen anzusehen. – Eine Aufgabe für spätere Blog-Aktivitäten.

Die Integrierte Information spielt wahrscheinlich beim Bewusstsein eine Rolle, jedoch, ob es die alles entscheidende Rolle ist, wage ich zu bezweifeln: Es gibt leider keine Aussagen zur Größenordnung von Phi des menschlichen Bewusstseins. Legt man 80 Milliarden Neuronen mit binären Zuständen zugrunde, so ergeben sich 2 hoch 80 Milliarden Zustände. Geht man weiterhin davon aus, dass Phi in etwa in der selben Größenordnung liegt, was die Netzwerke aus [5] nahelegen, dann ergibt sich für Phi eine unglaublich große Zahl. Selbst wenn man annimmt, dass nur etwa 10 Prozent des Gehirns am Bewusstsein beteiligt sind, bleibt der Phi-Wert immer noch unglaublich hoch. Dies zeigt aber auch, dass das Phi des menschlichen Bewusstseins und der bisherigen Netzwerk-Überlegungen unglaublich weit auseinander liegen. – Ein Umstand, der mir zeigt, dass die Überlegungen lückenhaft sind.

Es ist einerseits beruhigend festzustellen, dass ich mit einem einfachen ABM keine hohen Phi Werte erhalte – es wäre auch zu einfach gewesen 😊,  andererseits kommt mit IIT meines Erachtens eine neue Qualität in die Auseinandersetzung zum Verständnis von Bewusstsein. Bewusstsein wird entmystifiziert und es wird versucht dieses über mathematische Mechanismen abzubilden. Ich glaube, dass die IIT eine gute Messvorschrift ist für ‚Das Ganze ist mehr als die Summe seiner Teile‘. – Ich glaube aber auch, dass die IIT Bewusstsein nicht hinreichend beschreibt. – Ich vermute, dass alle die oben genannten Bewusstseinskonzepte weitere Körnchen Wahrheit darstellen und vielleicht auch noch etwas grundsätzlich Neues hinzukommen muss.

[1] IIT-Integrated Information Theory (2025) https://integratedinformationtheory.org/ oder https://www.iit.wiki/home

[2] Greene B, Chalmers D, Seth A (2024) What creates Consciousness, Youtube, https://www.youtube.com/watch?v=06-iq-0yJNM

[3] Henriques G, Vervaeke J (2024) Understanding Consciousness, Blog auf medium.com

[4] PyPhi (2024) Phi Python Bibliothek, https://pyphi.readthedocs.io/en/latest/index.html

[5] Albantakis L, et al. (2023) Integrated information theory (IIT) 4.0: Formulating the properties of phenomenal existence in physical terms. PLoS Comput Biol 19(10): e1011465, https://doi.org/10.1371/journal.pcbi.1011465

AI & QC & M 4.0: Die Welt der Unbestimmtheit nutzen oder vom Nutzen des Quantum Computing für das Team-Management

Der Blog-Beitrag wurde unter Mithilfe von OpenAI ChatGPT 4o1-preview erstellt: ChatGPT erzeugte den Code fehlerfrei und klärte alle meine wissenschaftlichen Fragen. Mittels ChatGPT 4o habe ich den Beitrag überprüft.

Die nachfolgende Audiodatei fasst den Inhalt als englischen Podcast, erstellt von Google’s notebookLM, zusammen und schlägt – ohne mein Zutun – diverse Brücken zu meinen anderen Blog-Beiträgen:

Abbildung 0: Dies ist eine Bild-Umsetzung des Blog-Beitrages von ChatGPT 4o/Dall-E

Grundlegende Ansätze des Quantum Computing (QC) wurden schon in der 80er Jahren formuliert. Erst in den letzten 10 Jahren hat diese Disziplin einen enormen Sprung in die Anwendbarkeit für Jedermann vollzogen. – Wobei, … diese Technologie sicherlich immer noch am Anfang steht.

Anwendbarkeit für Jedermann bedeutet, dass, ähnlich wie beim Thema Künstliche Intelligenz mittels klassischer Neuronaler Netzwerke (u.a. Copilot, ChatGPT, Gemini, Mistral usw.),  inzwischen in Nordamerika ein QC-Ecosystem existiert, das für mich zugänglich ist.

IBM, Microsoft und Google bieten entsprechende Umgebungen an. Das wohl bekannteste Startup im Bereich QC ist die kanadische Firma d-wave, die seit ca. 15 Jahren am  Markt ist [1].

Im QC gibt es zwei große Richtungen: Das Gate QC und das Quantum Annealing QC. Das Gate QC wird von IBM, Microsoft und Google favorisiert. D-wave hat sich auf das Quantum Annealing (QA) spezialisiert. Das Gate QC beruht auf der Idee von Schaltkreisen, wie von klassischen Rechnern bekannt. Jedoch ist die Funktionalität der QC Schaltkreise völlig anders als diejenige der klassischen Schaltkreise. Der Begriff ‚klassisch‘ bedeutet hier, dass nicht explizit die Eigenschaften der Quantenwelt ausgenutzt werden. – Wohl wissend, dass auch ein klassischer Schaltkreis auf den Erkenntnissen der Quantenmechanik beruht und ein sogenannter klassischer Computer ohne Quantenmechanik nicht existieren würde.

Das explizite Ausnutzen der Quantenwelt-Eigenschaften bedeutet, die Eigenschaften von Quantenobjekten, wie Elementarteilchen, Atomen oder anderen einzelnen Objekten, die sich entsprechend der Quantenmechanik verhalten, zu nutzen. Die QC-Objekte werden als Qubits bezeichnet, die nicht nur, wie Bits, die Zustände 1 und 0 annehmen können, sondern sogenannte kohärente Zustände, die eine Mischung von 1 und 0 sind. Diese Mischung sorgt für die Unbestimmtheit der Qubits und ermöglicht damit, dass in einem Qubit eine unendliche Welt an Möglichkeiten enthalten ist. – Kohärenz beschreibt also die Fähigkeit eines Quantensystems, in mehreren Zuständen gleichzeitig zu existieren. Diese Fähigkeit ermöglicht komplexe Quantenberechnungen, bis äußere Einflüsse die Zustände stören und die Kohärenz zerstören.

D-Wave verwendet Qubits auf der Basis von supraleitenden Ringströmen, die zudem über supraleitende Koppler verbunden sind. – Die Qubits kann man nach jetzigem Stand der Technik nur bei Temperaturen nahe dem absoluten Nullpunkt erhalten.  Sind die Ringströme in einem kohärenten Zustand, haben wir eine Mischung von Uhrzeiger-drehenden und Gegenuhrzeiger-drehenden Ringströmen. – Es liegt dann maximale Unbestimmtheit vor.

Allein diese wenigen Ausführungen zeigen, dass QC eine völlig andere Welt ist, als der sogenannte klassische Computer. Ich vermute, dass die Hürde für jemand, der keine Physikausbildung hat, recht hoch sein dürfte: Die Grundlagen der Quantenmechanik sind sehr umfangreich und erfahrungsgemäß erst nach einer gewissen Gewöhnungszeit ‚zu verstehen‘.- Ich verweise deshalb auf entsprechende Fachliteratur [2, 3, 4, 5, 6, 7]. Eine Behandlung der Grundlagen würde den Rahmen dieses Blog-Artikels bei weitem sprengen.

Setzt man die Kenntnis der quantenmechanischen Grundlagen voraus, so ist die Handhabung der Programme, um auf einem Quantencomputer zu ‚rechnen‘, erstaunlich einfach. Das ‚Rechnen‘ auf Quantencomputern ist nach wie vor noch sehr exklusiv und ist meistens eingeschränkt. Jedoch stellen alle Anbieter Quantensimulatoren zur Verfügung, die die quantenmechanischen Rechnungen (wie sie ein Physiker von Hand tun würde) auf einem klassischen Computer durchführen. Ab etwa 8-10 Qubits ist es jedoch meistens nicht mehr möglich die ‚Rechnungen‘ auf einem klassischen Computer durchzuführen, da die Komplexität der ‚Rechnungen‘ exponentiell steigt. – Für das Austesten der QC-Algorithmen reicht dies jedoch oft. – Nach der Testphase kann man dann ggf. auf einem exklusiven Quantencomputer ‚rechnen‘.

Ich habe für diesen Blog-Beitrag mit der d-wave Umgebung gearbeitet: Für die Erstellung der Algorithmen habe ich deren QC-Simulatoren verwendet und danach die d-wave QC-Hardware. Die Übergang ist sehr einfach, da lediglich 1-2 Programmzeilen ausgetauscht werden, in denen der QC-Simulator oder die QC-Hardware angesprochen wird.

Auf den d-wave Internetseiten sind sehr viele Beispiele zum QC mittels Quantum Annealing enthalten: u.a. logistische Lösungen, Suche nach geeigneten Materialien oder Medikamenten, Suche nach optimalen Finanzportfolios, usw..

QC kann immer dann ihre Vorteile ausspielen, wenn aus einer sehr großen Anzahl an Möglichkeiten die beste Lösung oder die besten Lösungen herausgefunden werden sollen. Nehmen wir an, wir wollten aus einem Pool von 100 Mitarbeitern ein Team zusammenstellen. Falls das Team drei Teammitglieder hat, ergeben sich schon 161.700 mögliche Teams. Erhöhen wir das Team auf 7 Teammitglieder ergeben sich ca. 16 Milliarden Team-Möglichkeiten. Die möglichen Teams im Falle von drei Teammitgliedern zu überprüfen ist auf klassischer Hardware noch möglich, im Fall des Teams mit 7 Teammitgliedern nicht mehr.

Quantum Annealing wird eingesetzt, wenn die Lösung aus einem sehr großen potentiellen Lösungsraum herausgefunden werden soll und sich das Problem als ein Netzwerk-Problem formulieren lässt. Im Falle unseres Team-Management-Problems besteht das Netzwerk aus 100 Teammitgliedern, die mehr oder weniger gut miteinander zusammenarbeiten können. Dieses mehr oder weniger gut wird vom Management über eine Zahl zwischen -1 und 1 bewertet und in eine Matrix eingetragen. Zusätzlich können auch Kompetenzen der Teammitglieder (zum Beispiel Programmierkenntnisse, Designkenntnisse oder Persönlichkeitseigenschaften) in einer Skala von 0 bis 1 erfasst werden. Für das Team lässt sich auf dieser Basis angeben, wieviel Teamkompetenz in den einzelnen Kompetenzbereichen vorhanden sein soll.

Das Management-Problem wird mittels einer Zielfunktion, die die Wechselwirkung der Qubits beschreibt, auf ein Qubit-Netzwerk transformiert: Die 100 Teammitglieder werden zu 100 Qubits, die Matrix der Zusammenarbeit wird auf eine Koppler-Matrix zwischen den Qubits abgebildet und die Kompetenzanforderungen werden als Constraints des Optimierungsproblems verwendet.

Zu Beginn der ‚Rechnung‘ wird das 100 Qubit-Netzwerk in einen Anfangszustand gebracht, der in sich! sogar 2hoch100 also ca. 10 hoch 30 Zustände enthält: Man spricht von einer Superposition des Qubit-Netzwerkes. Dann wird das Netzwerk extrem langsam ‚ausgeglüht’ und die Wechselwirkung zwischen den Qubits sehr langsam hochgefahren. Sehr langsam bedeutet hier sehr langsam in Relation zu den charakteristischen Qubit-Systemzeiten: Die sind, verglichen mit unseren Tageszeiten, sehr kleine Zeiten.

Man spricht von dem Ausglüh-Prozess: dem Annealing-Prozess. Der Begriff stammt von klassischen Optimierungsalgorithmen, in denen man zuerst mit einer hohen Temperatur startet, die viele Zustände enthält. Es wird extrem langsam (adiabatisch) ausgeglüht, um in einem ‚kühlen‘ Lösungszustand zu enden. Im Falle des Quantum Annealing, das ja bei sehr tiefen Temperaturen durchgeführt wird, um die Qubits zu bekommen, wird mit einem sogenannten transversalen Magnetfeld gearbeitet, das die 100 Qubits in eine vollständige Superposition bringt. – Der Quantum Annealing-Prozess minimiert langsam das Magnetfeld, wodurch das System in den Zustand der niedrigsten Energie gebracht wird – vergleichbar mit einem Stein, der in das tiefste Tal eines Hügels rollt. Der Prozess verläuft extrem langsam, um sicherzustellen, dass der optimale Zustand erreicht wird. Liegt die sehr langsam hochgefahrene Wechselwirkung zwischen den Qubits vollständig vor, ist der ausgeglühte 100 Qubit-Zustand erreicht. – Die optimale Lösung ist gefunden: Alle Qubits werden jetzt (erst) gemessen und zeigen jetzt eine 0 oder 1. Es ist jetzt möglich, für alle möglichen Kombinationen, die 7 Qubits enthalten und die weiteren festgelegten Rahmenbedingungen erfüllen, die Energie zu berechnen. Aus diesen Energien werden die niedrigsten Energiewerte oder der niedrigste Energiewert ausgewählt. 

Im Idealfall ist dies nur ein Zustand. Dies beruht auf der grundlegenden Annahme, dass die (natürliche) Lösung durch den Zustand oder die Zustände repräsentiert wird, die die niedrigsten Energiewerte besitzen.

Der QC Annealing Prozess ist ein Selbstorganisationsprozess, d.h. es kann auch vorkommen, dass der Prozess kein Energieminimum in der Energielandschaft findet. Aus diesem Grunde ist es notwendig, mit im Algorithmus enthaltenen Kontrollparametern etwas zu spielen, um ein Energieminimum zu finden. Hierzu werden die Kontrollparameter variiert, um in der durch die vorgegebenen Rahmenparametern (z.B. Teamgröße, Kompetenzprofile, Zusammenarbeits-Matrix) eingeschränkten Energielandschaft die Energieminima zu suchen. Das gefundene Energieminium ist hierbei der Ordnungsparameter zur Zielfunktion, die die Wechselwirkung der Qubits unter den gegebenen Rahmenbedingungen beschreibt.         

Das Team-Management Problem habe ich in einer Colab-Python-Umgebung laufen lassen. Ich habe Tests mit kleinen Pool- und Team-Größen durchgeführt. In diesem Fall kann man die Ergebnisse auch noch klassisch überprüfen. Ich gehe nicht weiter auf diese Ergebnisse ein: Liegen die oben beschriebenen Ausgangsdaten für das Team-Management-Problem vor, ist das ‚beste‘ Team innerhalb von Sekunden gefunden. Es funktioniert einfach!

Statt dessen möchte ich die Ergebnisse zu einer anderen Fragestellung skizzieren. Ich nehme Bezug auf den Blog-Beitrag ‚AI & M 4.0: Markus Lanz vom 30. Mai 2024: Eine Collective Mind Analyse‘ vom Juni 2024.

Es geht in diesem Beitrag um die Berechnung des Collective Mind einer Diskussionsrunde mit fünf Teilnehmern. Auch hier macht die Größe von fünf Teilnehmern kein QC erforderlich. Jedoch kann man bei dieser Größe Theorien austesten und die Skalierung auf größere Teilnehmerzahlen ist bei Bedarf völlig mühelos.

In dem vorherigen Blog-Beitrag habe ich eine sogenannte Ähnlichkeitsmatrix S benutzt. Diese Matrix S ist komplex: S = Matrix A der Textähnlichkeiten + i*Matrix der Emotionsähnlichkeiten. Die Fragestellung, die ich hier diskutieren möchte lautet: Könnte ich die Anzahl der Diskussionsteilnehmer reduzieren und würde dies den Collective Mind erhöhen und welche Teilnehmer sollte ich hierfür auswählen. Dies ist wieder ein Optimierungsproblem: Da das Collective Mind über die positive Energie, die im Team ist, gemessen wird, müssen wir -S (minus S) für die Optimierung verwenden. Außerdem können wir für das Quantum Annealing (derzeit) nur den Realteil der Matrix benutzen: Die Verwendung komplexer Matrizen wird von dem d-wave System nicht unterstützt, u.a. deswegen, weil damit die Energieerhaltung verletzt wird. – Moderne Forschungen in der nicht-hermiteschen Quantenmechanik untersuchen, wie komplexe Energieeigenwerte physikalische Systeme beeinflussen könnten. Diese Entwicklungen sind besonders spannend in Bereichen wie optischen Systemen und dissipativen Quantenphasen. Es ist also noch Raum für Ergänzungen vorhanden 😉.

Die Ergebnisse im vorherigen Blog legen nahe, dass ein Team aus drei Diskussionsteilnehmern ein Energieminimum (also ein Collective Mind Maximum) zeigen sollte: Die Sprecher 2  (B), Sprecher 4 (D) und Sprecher (5) (E) sollten gute Kandidaten sein.

Abbildung 1 zeigt eine Simulation mit 3 Teilnehmern: Die Ergebnisse sind identisch oder zumindest sehr ähnlich den Ergebnissen des vorherigen Block-Beitrages: Alle tragen zum Collective Mind bei. Falls man jedoch eine Diskussionsgruppe aus drei Teilnehmern zusammenstellen wollte, so wären dies die Sprecher 2 (B), Sprecher 4 (D) und Sprecher 5 (E).  

Abbildung 1: Sie zeigt eine ‚Rechnung‘ mit 3 Teilnehmern: Wie man sehen kann liefert das Quantum Annealing mehrere Lösungen (BDE, ADE und ABE), die sehr dicht beieinander liegen. Es gibt auch Kombinationen (ACD, und BCD), die nicht favorisiert werden.

Für die Teambildung ist die Energie pro Teilnehmer entscheidend. Abbildung 2 zeigt die Energie pro Teilnehmer falls nur zwei Teilnehmer für die Diskussionsrunde ausgewählt werden.

Abbildung 2: Diese Abbildung zeigt eine ‚Rechnung‘ mit 2 Teilnehmern. Hier ist die Energie pro Teilnehmer aufgetragen. Diese Energie zeigt an, wieviel Energie in diesen Kombinationen jeder Teilnehmer hat. Vergleicht man diese Energie von 45 mit einer Energie von ca. 33 im Falle einer Diskussionsrunde von drei Teilnehmern, so ergibt sich, dass im Übergang von 2 Teilnehmern zu 3 Teilnehmern die Energie pro Teilnehmer um ca. 25% abnimmt. Kommen weitere Teilnehmer hinzu nimmt die Energie pro Teilnehmer weiter ab. – Ein Collective Mind aufzubauen wird mit jedem hinzukommenden Teilnehmer schwieriger, kleine Teams sind günstiger für den Collective Mind Aufbau.

Zusammenfassend stelle ich fest:

  1. Das Arbeiten mit ChatGPT 4o1-preview ist eine enorme Bereicherung für mich. ChatGPT 4o1-preview hat Qualitäten eines PhD-Physikers und -Entwicklers. Das Arbeiten mit dem KI-System trägt im Falle eines schwierigen wissenschaftlichen Themas zu einer enormen Leistungssteigerung bei. – Die Zusammenarbeit mit ChatGPT hat nicht nur den Recherche- und Codeentwicklungs-Prozess beschleunigt, sondern auch neue Perspektiven auf die Themen ermöglicht.
  2. Das Quantum Computing, hier das Quantum Annealing, ist über Colab und d-wave wirklich sehr einfach zu handhaben. – Es macht einfach Spaß, Management-Fragestellungen auf diese Weise zu beleuchten und in die Quantenwelt einzutauchen, die noch bis vor kurzem der modernsten Forschung vorbehalten war. – Man beginnt sowohl die Quantenwelt besser zu verstehen als auch die Managementwelt. – Theorien, wie die Collective Mind Theorie, machen einen angreifbar, sind aber auch der einzige Weg, um Erfahrungen in Erkenntnisse zu transformieren.
  3. Die QA ‚Rechnungen‘ bestätigen meine bisherigen Ergebnisse und liefern weitere Management-Erkenntnisse: Eine Skalierung auf Fragestellungen mit mehr Daten (hier mehr Personen) ist sehr einfach und die Ergebnisse liegen bei Bedarf nahezu unmittelbar vor.    

[1] d-wave (2024) dwavesys.com, cloud.dwavesys.com/leap/, docs.dwavessys.com docs.ocean.dwavesys.com     

[2] Nielsen M L und Chuang I L (2021) Quantum Computation and Quantum Information, 10te Auflage von 2002, Cambridge University Press, UK

[3] Georgescu I M, Ashhaby S, Noriz F(2014) Quantum Simulation, arXiv:1308.6253v3

[4] Broughton M et al. (2021) TensorFlow Quantum: A Software Framework for Quantum Machine Learning, arXiv:2003.02989v2

[5] Rajak A et al. (2023) Quantum Annealing: An Overview, Philosophical Transactions A, arXiv:2207.01827v4

[6] Xu  et al. (2023) A Herculean task: Classical simulation of quantum computers, arXiv:2302.08880v1

[7] Young K, Scese M, Ebnenasir A (2023) Simulating Quantum Computations on Classical Machines: A Survey, arXiv:2311.16505v1