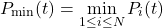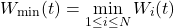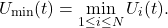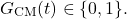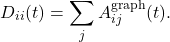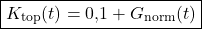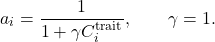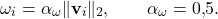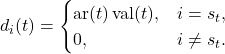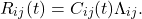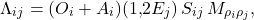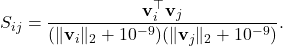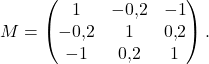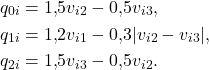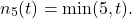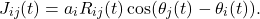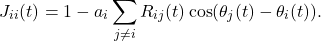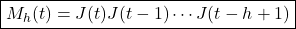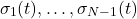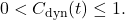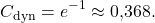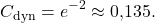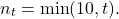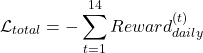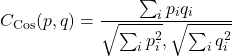Collective Mind Criticality Index 6.0: Kollektive Intelligenz erkennen und entwickeln

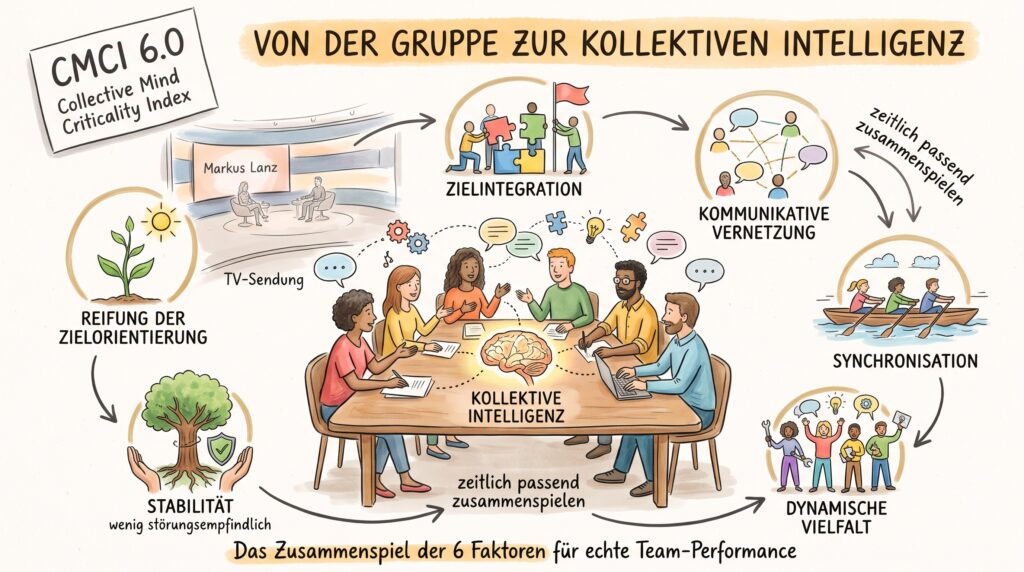
Kurzfassung: Der Collective Mind Criticality Index 6.0 (CMCI 6.0) misst unter welchen Bedingungen es in einer Gruppe oder einem Team gelingt, individuelle Fähigkeiten und Perspektiven so miteinander zu verbinden, dass eine kollektive Intelligenz entsteht, die über das isolierte Handeln der einzelnen Mitglieder hinausgeht. Mit Hilfe des CMCI 6.0 werden zwei Markus Lanz TV-Sendungen vermessen. Es zeigt sich, dass eine zunehmende gemeinsame Zielorientierung nicht automatisch zu einer entsprechend hohen kollektiven Leistungsfähigkeit führt. Mit entscheidend ist, ob das Team in der jeweiligen Situation auch ausreichend vernetzt, dynamisch vielseitig und wenig störungsempfindlich zusammenarbeiten kann. Die sechs Faktoren Zielintegration, kommunikative Vernetzung, Synchronisation, dynamische Vielfalt und Stabilität sowie Reifung der Zielorientierung müssen zeitlich passend zusammenspielen. 

Dieser Beitrag wurde mittels ChatGPT Plus erstellt. Die ersten Ergebnisse basieren auf Gemini Pro Beiträgen. Das Eingangsbild erstellte Gemini. 


Schon vor vier Wochen hatte ich geplant, einen neuen Blog-Beitrag zu veröffentlichen. Ziel sollte sein, zentrale Ergebnisse der vorherigen Blog-Beiträge in einen Collective Mind Criticality Index (CMCI) einfließen zu lassen. Mit diesem Collective Mind Criticality Index will ich den Grad des Collective Mind in einer Gruppen- oder Team- Sitzung erfassen. Er soll folgende Frage beantworten: ‚Wie lässt sich die kollektive Intelligenz eines Teams erkennen und entwickeln?‘. Die Qualitätssicherung mittels ChatGPT Plus zum damals vorhanden Entwurf des Blog-Beitrags ergab, dass insbesondere die mathematische Transparenz, also warum welche Einflussfaktoren des Collective Mind (CM) wie modelliert werden, nicht ausreichend vorhanden war. Ich startete also auf der Basis des damals vorliegenden mathematischen Modells eine systematische Analyse der Einflussfaktoren. Dies führte zur bisher mit Abstand umfangreichsten mathematischen Analyse für einen Blog-Beitrag. Der neue jetzt hier vorliegende Collective Mind Criticality Index hat den Namen CMCI 6.0.

Das weiter unten mit ChatGPT erzeugte mathematische Modell verfügt über eine deutlich höhere Transparenz bezüglich der CMCI 6.0 Einflussfaktoren als das mit Gemini erstellte Modell. Die Ergebnisse unterscheiden sich auch quantitativ. Erstaunlich ist jedoch, dass sich die Ergebnisse beider Modelle qualitativ nicht unterscheiden!

Wie schon in vorherigen Blog-Beiträgen benutze ich zwei Markus Lanz TV-Sendungen für meine Untersuchungen:

Markus Lanz (2024) Muslime in Deutschland: Zunehmend isoliert?, Sendung vom 30 Mai 2024, ZDF, http://youtu.be/rpINCu5VmnY

und
Lanz M (2026) Warum ist die Stimmung im Land so bescheiden, Sendung vom 04. Juni 2026, ZDF, www.youtube.com/watch?v=psfdt2iWnoM

Wie in der Vergangenheit auch verwende ich die mathematischen und programmiertechnischen Fähigkeiten der KI-Systeme. Zusätzlich sind die Transkripte der TV-Sendungen sehr umfangreich von Gemini Pro und ChatGPT Plus für die Erstellung von Transkript Metadaten verwendet worden. Zu den Metadaten gehören folgende Daten: Big Five Persönlichkeitsprofile, Werteprofile, Zuordnung zu den Spiral Dynamics Ebenen Rot/Blau, Orange und Grün/Gelb, Arousal und Valenz, Ziel-Hierarchie Ermittlung und Bewertung pro Person und für die jeweilige Gruppe als Ganzes.

Für die zweite der beiden TV-Sendungen habe ich die KI generierten Daten durch mich validiert. Es gibt Unterschiede in der Wahrnehmung von KI-System und mir, sie sind jedoch relativ gering und haben keinen wesentlichen Einfluss auf die hier vorgestellten Ergebnisse.  

Was misst der CMCI 6.0?

Stellen wir uns ein agiles Team vor, das gemeinsam ein komplexes Problem lösen soll. Die Teammitglieder besitzen unterschiedliche Kompetenzen, Erfahrungen, Werte, Interessen und persönliche Ziele. Jeder betrachtet die Aufgabe aus seiner eigenen Perspektive. Die entscheidende Frage lautet:

Unter welchen Bedingungen gelingt es diesem Team, seine individuellen Fähigkeiten und Perspektiven so miteinander zu verbinden, dass eine gemeinsame Intelligenz entsteht, die über das isolierte Handeln der einzelnen Mitglieder hinausgeht?

Genau diese Frage steht im Mittelpunkt der Collective Mind Theory und des CMCI 6.0! Ein Collective Mind ist dabei nicht gleichbedeutend mit Harmonie, Gruppendenken oder vollständiger Übereinstimmung. Im Gegenteil: Unterschiedliche Perspektiven sind für komplexe Problemlösungen häufig unverzichtbar. Entscheidend ist, ob ein Team diese Unterschiede produktiv verarbeiten und in eine gemeinsame Zielorientierung integrieren kann.

Der CMCI 6.0 untersucht dafür sechs Eigenschaften eines Teams:

  1. Gemeinsame Zielorientierung: Ziehen alle grundsätzlich in eine integrierbare Richtung?
  2. Kommunikative Vernetzung: Sind die Teammitglieder miteinander verbunden und im Austausch?
  3. Synchronisation: Können die Mitglieder ihre Aktivitäten und Reaktionen aufeinander abstimmen?
  4. Kollektive Handlungs- und Veränderungsvielfalt: Verfügt das Team über mehrere voneinander unabhängige Möglichkeiten, auf Herausforderungen zu reagieren?
  5. Dynamische Stabilität: Wie empfindlich reagiert die gemeinsame Teamdynamik auf Veränderungen und Störungen?
  6. Reifung der gemeinsamen Zielorientierung: Wie gleichmäßig entwickelt sich die gemeinsame Zielstruktur über die Zeit?

Der CMCI 6.0 verbindet diese sechs Faktoren zu einem Gesamtindex.
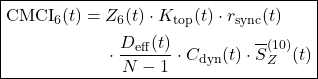
    \[ \boxed{ \begin{aligned} \mathrm{CMCI}_6(t) ={}&Z_6(t)\cdot K_{\mathrm{top}}(t) \cdot r_{\mathrm{sync}}(t)\\ &\cdot\frac{D_{\mathrm{eff}}(t)}{N-1} \cdot C_{\mathrm{dyn}}(t) \cdot\overline{S}_Z^{(10)}(t) \end{aligned} } \]

Dabei bezeichnet t den untersuchten Turn, also einen einzelnen Gesprächsbeitrag, und N die Anzahl der Teilnehmer.

Mit dem obigen CMCI 6.0 wird das wesentliche CM Prinzip umgesetzt:

Eine ausgeprägte Stärke in einem Bereich kann eine gravierende Schwäche in einem anderen Bereich nicht beliebig kompensieren.

Ein Team kann hervorragend kommunizieren, aber dennoch an unvereinbaren Zielen scheitern. Ebenso kann ein Team ein gemeinsames Ziel besitzen, aber aufgrund mangelnder Koordination nicht zu einer gemeinsamen Leistung finden.

Ich skizziere im Folgenden zuerst das jeweilige Ergebnis der CMCI 6.0 Berechnungen für die beiden TV-Sendungen.

Anschließend beschreibe ich die sechs Einflussfaktoren des CMCI 6.0 aus Sicht eines Coaches oder einer agilen Führungskraft.

Und zum Schluss gehe ich auf die zugrundeliegende Mathematik ein.


Ergebnis der CMCI 6.0 Berechnungen für die beiden TV-Sendungen
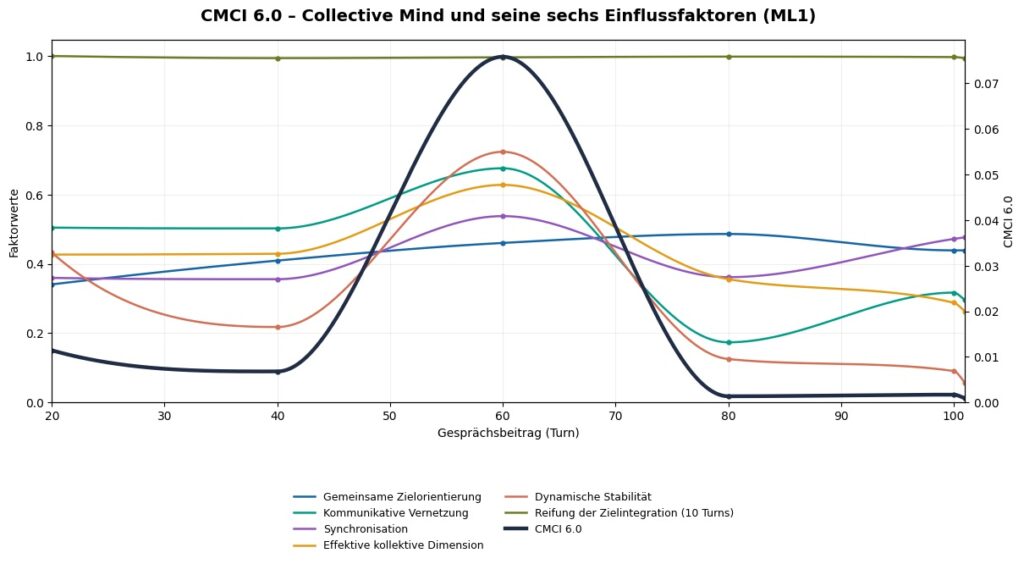
Abbildung 1: TV Sendung 1: Ein kurzes Zeitfenster besonders günstiger kollektiver Dynamik

Die erste Abbildung zeigt die Entwicklung des Collective Mind Criticality Index (CMCI 6.0) und seiner sechs Einflussfaktoren während der ersten Markus Lanz Diskussion.

Das wichtigste Ergebnis ist ein ausgeprägter Höhepunkt des CMCI 6.0 bei Gesprächsbeitrag 60. In dieser Phase treffen mehrere günstige Bedingungen zusammen: Die kommunikative Vernetzung erreicht ihren höchsten Wert, die Synchronisation der Teilnehmer ist vergleichsweise stark, die effektive kollektive Dimension liegt auf einem hohen Niveau und auch die dynamische Stabilität ist deutlich ausgeprägter als in den anschließenden Gesprächsphasen.

Aus der Perspektive von Coaching und Teamarbeit könnte dies als ein zeitlich begrenztes Fenster besonders günstiger kollektiver Zusammenarbeit interpretiert werden. Die Teilnehmer sind im mathematischen Modell relativ gut miteinander verbunden, ihre Dynamik ist besser aufeinander abgestimmt und es bestehen mehrere unabhängige Veränderungsmöglichkeiten.

Bemerkenswert ist jedoch, dass die gemeinsame Zielorientierung erst bei Turn 80 ihr Maximum erreicht, während der CMCI bereits stark zurückgegangen ist. Die Gesprächsteilnehmer können ihre unterschiedlichen Positionen also zunehmend in eine übergeordnete Zielstruktur einordnen, obwohl die dynamischen Voraussetzungen für eine gemeinsame Verarbeitung bereits ungünstiger geworden sind.

Gegen Ende verschlechtert sich insbesondere die dynamische Stabilität. Gleichzeitig geht auch die gemeinsame Zielorientierung etwas zurück. Der CMCI erreicht deshalb nur noch sehr niedrige Werte.

Der Reifungsfaktor der Zielintegration bleibt nahezu konstant auf hohem Niveau. Er besitzt damit in dieser Untersuchung nur eine geringe unterscheidende Wirkung. Das ist auch darauf zurückzuführen, dass die zugrunde liegenden Zielbewertungen nur an einzelnen Checkpoints vorliegen.

Kernaussage: Eine zunehmende gemeinsame Zielorientierung führt nicht automatisch zu einer entsprechend hohen kollektiven Leistungsfähigkeit. Entscheidend ist das zeitliche Zusammenspiel von Zielintegration, Kommunikation, Synchronisation, dynamischer Vielfalt und Stabilität.

Für Coaches ergibt sich daraus eine wichtige Erkenntnis: Ein Team kann einen gemeinsamen Purpose entwickeln und dennoch Schwierigkeiten haben, seine individuellen Fähigkeiten im entscheidenden Moment zu einer abgestimmten kollektiven Leistung zu verbinden.
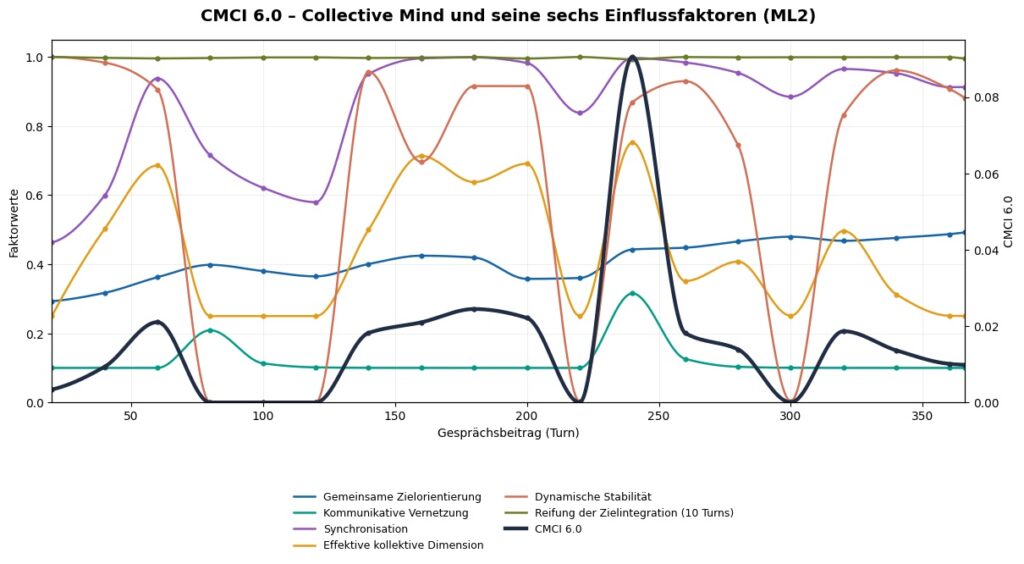
Abbildung 2: TV-Sendung 2: Auf und Ab der Integrationsphasen und ein ausgeprägter Höhepunkt kollektiver Dynamik

Die zweite Abbildung zeigt die Entwicklung des CMCI 6.0 während der zweiten Markus Lanz Diskussion mit insgesamt 366 Gesprächsbeiträgen.

Im Unterschied zur ersten Sendung ist die Entwicklung durch mehrere aufeinanderfolgende Phasen erhöhter kollektiver Dynamik gekennzeichnet. Der CMCI steigt zunächst zeitweise an, fällt jedoch mehrfach nahezu auf null zurück. Sein mit Abstand höchster Wert wird bei Gesprächsbeitrag 240 erreicht.

Dieser Höhepunkt ist besonders interessant, weil dort auch in unserer qualitativen Transkriptanalyse eine wichtige Integrationsleistung identifiziert wurde: Die Teilnehmerin Heuer stößt selbst eine differenzierende Einordnung an, die anschließend vom Moderator aufgegriffen wird.

Der hohe CMCI-Wert fällt mit einem deutlichen Anstieg der kommunikativen Vernetzung, einer hohen Synchronisation, einer hohen effektiven Dimension und einer günstigen dynamischen Stabilität zusammen.

Aus Sicht des agilen Coachings kann dies als eine Phase interpretiert werden, in der die Voraussetzungen für eine produktive gemeinsame Verarbeitung unterschiedlicher Perspektiven besonders günstig sind.

Die gemeinsame Zielorientierung entwickelt sich dagegen über die gesamte Diskussion hinweg tendenziell positiv. Sie steigt von ungefähr 0,29 auf 0,49 und erreicht ihre höchsten Werte erst gegen Ende der Sendung.

Damit zeigt sich auch hier eine deutliche Unterscheidung zwischen der fortschreitenden Entwicklung einer gemeinsamen Zielstruktur und den kurzfristigen Schwankungen der kollektiven Dynamik.

Besonders auffällig sind die starken Einbrüche des CMCI um die Turns 100–120, 220 und 300. Diese werden wesentlich durch sehr niedrige Werte des dynamischen Stabilitätsfaktors verursacht. Selbst eine hohe Synchronisation kann diese Einbrüche nicht kompensieren.

Bei Turn 300 ist dies besonders interessant: Unsere qualitative Analyse identifizierte dort einen wichtigen Beitrag zur übergeordneten Zielorientierung. Zeh fordert konkretere und positivere politische Zukunftsvorstellungen. Trotzdem fällt der CMCI nahezu auf null. Ein wertvoller Impuls zur Zielentwicklung bedeutet somit nicht zwangsläufig, dass gleichzeitig eine günstige kollektive Dynamik vorliegt.

Der Reifungsfaktor der Zielintegration, der Schwankungen der Zielausrichtung in einem gleitenden Fenster von 10 Turns misst, bleibt fast durchgehend nahe 1 und beeinflusst die Unterschiede zwischen den Gesprächsphasen nur geringfügig.

Kernaussage: Die Entstehung einer gemeinsamen Zielorientierung ist ein längerfristiger Prozess, während die dynamischen Voraussetzungen für kollektive Intelligenz stark schwanken können.

Für Coaches und Führungskräfte im Management 4.0 bedeutet dies: Eine gemeinsame Vision und ein hohes Maß an Synchronisation reichen allein nicht aus. Entscheidend ist, ob das Team in der jeweiligen Situation auch ausreichend vernetzt, dynamisch vielseitig und wenig störungsempfindlich zusammenarbeiten kann.

Was lernen wir aus dem Vergleich beider Sendungen?

Die beiden untersuchten Diskussionen zeigen unterschiedliche Entwicklungsmuster.

In der ersten Sendung entsteht ein einzelnes, besonders ausgeprägtes Zeitfenster günstiger kollektiver Dynamik um Turn 60. Anschließend verschlechtern sich die dynamischen Bedingungen deutlich, obwohl sich die gemeinsame Zielorientierung zunächst weiter verbessert.

Die zweite Sendung zeigt dagegen mehrere Phasen erhöhter kollektiver Dynamik. Besonders bei Turn 240 stimmen der CMCI-Höhepunkt und eine im Transkript erkennbare Integrationsleistung zeitlich überein.

Beide Untersuchungen verdeutlichen eine grundlegende Unterscheidung der Collective Mind Theory: Eine Gruppe kann an einer gemeinsamen Zielvorstellung arbeiten, ohne zu jedem Zeitpunkt über die dynamischen Voraussetzungen einer leistungsfähigen kollektiven Intelligenz zu verfügen.

Das ist gerade für das Verständnis von Teamarbeit und Management 4.0 relevant. Die Entwicklung eines gemeinsamen Purpose, die kommunikative Vernetzung, die Abstimmung individueller Aktivitäten und die Fähigkeit zum Umgang mit Veränderungen sind unterschiedliche, aber miteinander verbundene Aspekte kollektiver Zusammenarbeit.

Der CMCI 6.0 versucht, dieses Zusammenspiel mathematisch sichtbar zu machen.

Dabei sind die Ergebnisse als explorative Modellanalysen zu verstehen. Die beiden TV-Diskussionen sind zeitlich begrenzte, moderierte Situationen und keine langfristig zusammenarbeitende Teams. Die Abbildungen liefern daher Hinweise auf dynamische und semantische Integrationsprozesse, aber keinen Nachweis für die Existenz eines vollständig entwickelten Collective Mind.


Die sechs Faktoren aus der Perspektive eines Coaches

Faktor 1: Gemeinsame Zielintegration – Haben wir eine gemeinsame Richtung?

Mathematische Größe: (Z_6)

Was bedeutet dieser Faktor für einen Coach?

In der agilen Teamarbeit sprechen wir häufig von Shared Vision, Purpose, Alignment und Commitment.

Ein leistungsfähiges Team benötigt eine gemeinsame Vorstellung davon, was es erreichen möchte und warum dieses Ziel wichtig ist.

Dabei genügt es nicht, dass das Management eine Vision formuliert und die Teammitglieder diese kennen.

Entscheidend ist, ob die Teammitglieder ihre individuellen Ziele, Bedürfnisse und Wertvorstellungen innerhalb der gemeinsamen Zielstruktur wiederfinden können.

Ein Coach würde beispielsweise fragen:

  • Haben wir einen gemeinsamen Purpose?
  • Wissen alle, welchen Beitrag sie zur gemeinsamen Vision leisten?
  • Sind die individuellen Ziele der Teammitglieder berücksichtigt?
  • Werden unterschiedliche Wertvorstellungen verstanden und können sie miteinander vereinbart werden?
  • Haben wir tatsächlich eine gemeinsame Zielhierarchie oder lediglich einen Kompromiss formuliert?

Was misst der Faktor?

Die semantische Zielintegration betrachtet vier Eigenschaften.

1. Qualität der gemeinsamen Zielhierarchie (H)

Gibt es eine übergeordnete Zielstruktur, die Einzelziele sinnvoll miteinander verbindet?

2. Repräsentation individueller Ziele (P)

Finden alle Teammitglieder ihre wesentlichen Ziele in dieser Hierarchie wieder?

3. Wertevereinbarkeit (W)

Sind die gemeinsamen Ziele mit den zentralen Wertvorstellungen der Teammitglieder vereinbar?

4. Gegenseitiges Verständnis (U)

Gibt es Hinweise darauf, dass die Teammitglieder die gemeinsame Zielstruktur und die unterschiedlichen individuellen Perspektiven verstehen?

Der CMCI verwendet bei den letzten drei Eigenschaften jeweils die schwächste individuelle Bewertung.

Dahinter steht der Gedanke, dass eine gemeinsame Vision nicht wirklich alle integriert, wenn wesentliche Ziele einzelner Teammitglieder unberücksichtigt bleiben.

Beispiel aus der Teamarbeit

Ein Entwicklungsteam soll ein neues Produkt möglichst schnell auf den Markt bringen.

Der Product Owner möchte einen frühen Markteintritt erreichen. Die Entwickler legen großen Wert auf technische Qualität. Der Datenschutzexperte besteht auf der Einhaltung regulatorischer Anforderungen.

Zunächst erscheinen diese Ziele widersprüchlich.

Durch gemeinsames Arbeiten entsteht jedoch eine übergeordnete Zielsetzung:

Wir entwickeln ein marktfähiges Produkt, das schnell nutzbaren Kundennutzen liefert, technisch zuverlässig ist und die notwendigen Datenschutzanforderungen erfüllt.

Die individuellen Ziele werden nicht einfach aufgegeben, sondern in eine übergeordnete Zielhierarchie eingeordnet.

Coaching-Interpretation: Der Faktor (Z_6) beschreibt, wie gut die Voraussetzungen für ein gemeinsames Alignment der individuellen Ziele und Werte sind.

Ein besonders wichtiger Punkt ist die Unterscheidung zwischen Verständnis und Zustimmung. Ein Team kann seine unterschiedlichen Positionen vollständig verstehen und trotzdem feststellen, dass zentrale Ziele nicht vereinbar sind.

Bei ausdrücklich festgestellter, nicht integrierbarer Unvereinbarkeit zentraler Ziele kann das Konflikt-Gate des CMCI den Gesamtindex auf null setzen.


Faktor 2: Kommunikative Vernetzung – Sind wir wirklich ein Team oder nur eine Gruppe von Einzelpersonen?

Mathematische Größe: (K_{\mathrm{top}})

Was bedeutet dieser Faktor für einen Coach?

In agilen Organisationen wird häufig über Transparenz, Kommunikation, Zusammenarbeit und den Abbau von Silos gesprochen.

Dabei ist nicht allein entscheidend, wie viel kommuniziert wird.

Ein Team kann zahlreiche Meetings durchführen und trotzdem schlecht vernetzt sein.

Beispielsweise kann sämtliche Kommunikation über den Scrum Master, den Product Owner oder die Führungskraft laufen.

In diesem Fall entstehen sternförmige Kommunikationsstrukturen mit einem zentralen Vermittler.

Ein selbstorganisiertes Team zeichnet sich dagegen dadurch aus, dass die Mitglieder eigenständig miteinander kommunizieren, Informationen austauschen und ihre Arbeit koordinieren.

Ein Coach würde fragen:

  • Kommunizieren die Teammitglieder direkt miteinander?
  • Gibt es isolierte Personen oder Teilgruppen?
  • Entsteht Wissen im gesamten Team oder konzentriert es sich bei wenigen Personen?
  • Ist das Team von einzelnen Kommunikationsvermittlern abhängig?
  • Können Informationen auch dann weiterfließen, wenn eine Schlüsselperson ausfällt?

Was misst der Faktor?

Der CMCI bildet aus den beobachteten Kommunikationsbeziehungen ein Netzwerk.

Die Kontakte werden zeitlich gewichtet: Neuere Kontakte erhalten mehr Gewicht, während ältere Kontakte schrittweise an Bedeutung verlieren.

Anschließend wird die sogenannte algebraische Konnektivität des Kommunikationsnetzwerks berechnet.

Vereinfacht ausgedrückt beschreibt sie, wie stark die verschiedenen Teile des Netzwerks miteinander verbunden sind.

Eine gut vernetzte Gruppe besitzt weniger strukturelle Trennstellen als eine Gruppe, die aus weitgehend isolierten Teilgruppen besteht.

Beispiel aus der Teamarbeit

In einem Scrum-Team sprechen die Entwickler hauptsächlich mit dem Scrum Master. Die Tester kommunizieren fast ausschließlich mit dem Product Owner.

Obwohl täglich ein Daily Scrum stattfindet, ist die tatsächliche Zusammenarbeit zwischen den Fachgebieten gering.

Der Coach unterstützt das Team dabei, direkte Kommunikation zwischen Entwicklung, Test und Produktverantwortung aufzubauen.

Dadurch entsteht ein stärker vernetztes Kommunikationssystem.

Coaching-Interpretation: (K_{\mathrm{top}}) beschreibt die strukturellen Voraussetzungen für Transparenz, Wissensaustausch und Selbstorganisation.

Eine hohe kommunikative Vernetzung bedeutet allerdings noch nicht, dass die Kommunikation konstruktiv ist. Auch intensive Konflikte können zu starken Kommunikationsverbindungen führen.


Faktor 3: Synchronisation – Arbeiten wir miteinander oder nebeneinander?

Mathematische Größe: (r_{\mathrm{sync}})

Was bedeutet dieser Faktor für einen Coach?

Ein wichtiges Ziel agiler Zusammenarbeit ist die Fähigkeit, das eigene Handeln mit dem Handeln anderer Teammitglieder abzustimmen.

Dabei geht es nicht um Gleichförmigkeit.

Ein Entwicklungsteam benötigt unterschiedliche Kompetenzen und Aufgaben. Trotzdem müssen seine Mitglieder in einem gemeinsamen Arbeitsrhythmus zusammenwirken.

Im Coaching sprechen wir von Koordination, Abstimmung, gegenseitiger Responsivität und manchmal auch von Team Flow.

Die Mitglieder reagieren aufeinander, erkennen Abhängigkeiten und passen ihr Verhalten an die gemeinsame Situation an.

Ein Coach würde fragen:

  • Reagieren die Teammitglieder aufeinander?
  • Greifen sie Beiträge anderer auf?
  • Können sie ihre Aktivitäten zeitlich koordinieren?
  • Entstehen gemeinsame Arbeitsrhythmen?
  • Ist das Team in der Lage, seine Zusammenarbeit bei Veränderungen schnell anzupassen?

Was misst der Faktor?

Die Collective Mind Theory verwendet hierfür ein Modell gekoppelter Oszillatoren.

Jeder Teilnehmer besitzt einen simulierten dynamischen Zustand, der durch eine Phase beschrieben wird.

Diese Phase wird durch individuelle Eigenschaften, emotionale Gesprächsimpulse und die Kommunikation mit anderen Teilnehmern beeinflusst.

Der Synchronisationsfaktor misst, wie stark die modellierten Phasen miteinander übereinstimmen.

Bei hoher Synchronisation befinden sich die Teilnehmer im Modell in einem stark abgestimmten dynamischen Zustand.

Bei niedriger Synchronisation sind ihre dynamischen Zustände weniger stark aufeinander ausgerichtet.

Der CMCI berücksichtigt dabei einen gleitenden Mittelwert über fünf Turns.

Beispiel aus der Teamarbeit

Ein Team arbeitet an einem schwierigen Produktionsproblem.

Zunächst analysiert jeder das Problem isoliert. Ergebnisse werden verspätet ausgetauscht, Maßnahmen überschneiden sich, und die Beteiligten reagieren kaum aufeinander.

Nach einer gemeinsamen Abstimmung verändert sich die Arbeitsweise.

Die Mitglieder teilen neue Erkenntnisse unmittelbar, passen ihre Untersuchungen gegenseitig an und entwickeln eine gemeinsame Vorgehensweise.

Die Arbeitsprozesse werden stärker synchronisiert.

Coaching-Interpretation: (r_{\mathrm{sync}}) ist ein modellbasierter Indikator für die dynamische Abstimmung innerhalb des Teams.

Er beschreibt nicht unmittelbar den Team Flow und misst auch keine neuronale Synchronisation. Er soll vielmehr einen Aspekt der gegenseitigen Koordination mathematisch repräsentieren.

Wichtig ist erneut: Auch ein Streit kann hoch synchronisiert verlaufen. Deshalb reicht Synchronisation allein für einen Collective Mind nicht aus.


Faktor 4: Effektive kollektive Dimension – Wie vielfältig kann unser Team auf Herausforderungen reagieren?

Mathematische Größe: (D_{\mathrm{eff}})

Was bedeutet dieser Faktor für einen Coach?

Management 4.0 ist durch Komplexität, Unsicherheit und schnelle Veränderungen geprägt.

In solchen Situationen reicht es häufig nicht aus, wenn ein Team immer wieder dieselben Handlungsmuster reproduziert.

Ein leistungsfähiges Team muss unterschiedliche Perspektiven miteinander verbinden und verschiedene Veränderungsrichtungen nutzen können.

Hier begegnen uns Begriffe wie:

Cross-Functional Collaboration, Diversity, Adaptability, Problemlösungskompetenz und kollektive Lernfähigkeit.

Ein Coach würde fragen:

  • Können wir ein Problem aus unterschiedlichen Perspektiven betrachten?
  • Verfügen wir über mehrere voneinander unabhängige Handlungsoptionen?
  • Sind wir auf ein einziges Lösungsmuster fixiert?
  • Nutzen wir die unterschiedlichen Kompetenzen im Team?
  • Können wir auf Veränderungen mit verschiedenen Verhaltensweisen reagieren?

Was misst der Faktor?

Die effektive Dimension untersucht die Vielfalt der unabhängigen dynamischen Veränderungsrichtungen des mathematischen Teammodells.

Dazu wird analysiert, wie kleine Änderungen im dynamischen Zustand eines Teilnehmers über die Kommunikation das Gesamtsystem beeinflussen.

Wenn die Veränderungen überwiegend einer einzigen dominierenden Richtung folgen, ist die effektive Dimension niedrig.

Verteilen sich die Veränderungen auf mehrere unabhängige Richtungen, steigt die effektive Dimension.

Der CMCI normiert diese Größe anhand der Anzahl der Teilnehmer.

Beispiel aus der Teamarbeit

Ein Team reagiert auf jedes Problem mit derselben Maßnahme: mehr Meetings, zusätzliche Kontrolle oder eine weitere Eskalation an das Management.

Die Zahl der tatsächlich genutzten Handlungsmuster ist gering.

Ein anderes Team kann technische, organisatorische, kommunikative und kundenbezogene Perspektiven miteinander verbinden.

Es verfügt dadurch über unterschiedliche Möglichkeiten, seine Vorgehensweise zu verändern.

Coaching-Interpretation: (D_{\mathrm{eff}}) beschreibt die Vielfalt unabhängiger Veränderungsmöglichkeiten innerhalb der modellierten Gruppendynamik.

Ein hoher Wert kann als Hinweis auf ein breiteres dynamisches Reaktionspotenzial interpretiert werden.

Er ist jedoch kein unmittelbares Maß für Kreativität, Kompetenz oder die Anzahl tatsächlich verfügbarer Lösungsalternativen.


Faktor 5: Dynamische Stabilität – Wie empfindlich ist unsere Zusammenarbeit gegenüber Störungen?

Mathematische Größe: (C_{\mathrm{dyn}})

Was bedeutet dieser Faktor für einen Coach?

Ein Team kann für kurze Zeit hervorragend zusammenarbeiten.

Die entscheidende Frage ist jedoch, wie empfindlich diese Zusammenarbeit auf Veränderungen reagiert.

Was geschieht, wenn eine unerwartete Kundenanforderung auftaucht? Wenn ein Teammitglied eine andere Meinung vertritt? Wenn ein Sprint-Ziel gefährdet ist?

Verliert das Team sofort seine gemeinsame Ausrichtung, oder kann es die Störung verarbeiten?

Im agilen Coaching sprechen wir hier über Resilienz, Anpassungsfähigkeit, Selbstregulation und den Umgang mit Unsicherheit.

Ein Coach würde fragen:

  • Wie reagieren wir auf unerwartete Veränderungen?
  • Führen kleine Meinungsverschiedenheiten sofort zu großen Konflikten?
  • Können wir unsere Zusammenarbeit selbst regulieren?
  • Bleibt unsere gemeinsame Arbeitsfähigkeit bei Störungen erhalten?
  • Können wir nach Irritationen wieder eine gemeinsame Orientierung herstellen?

Was misst der Faktor?

Das Modell untersucht, wie sich kleine Störungen der relativen dynamischen Zustände über zehn Turns entwickeln.

Dazu wird die transversale Dynamik betrachtet.

Transversal bedeutet hier, dass Veränderungen untersucht werden, die die relativen Beziehungen zwischen den Teilnehmern betreffen.

Der CMCI ermittelt daraus eine endliche Wachstumsrate.

Der aktuelle Stabilitätsfaktor bewertet Zustände besonders hoch, bei denen diese Wachstumsrate nahe null liegt.

Das entspricht einer geringen Veränderung der maximalen transversalen Störungsverstärkung.

Starke Verstärkung, aber auch starke Kontraktion werden durch die aktuelle mathematische Formel niedriger bewertet.

Beispiel aus der Teamarbeit

Ein Kunde verändert kurzfristig eine wichtige Anforderung.

Ein Team reagiert mit gegenseitigen Schuldzuweisungen. Die Zusammenarbeit wird zunehmend konflikthaft, und die Beteiligten verlieren ihre gemeinsame Orientierung.

Ein anderes Team kann die Änderung gemeinsam analysieren, Prioritäten überprüfen und seine Aktivitäten neu koordinieren.

Die Störung führt dort nicht zu einer vergleichbaren Auflösung der gemeinsamen Zusammenarbeit.

Coaching-Interpretation: (C_{\mathrm{dyn}}) beschreibt, wie nahe die modellierte Gruppendynamik an einem Zustand neutraler transversaler Störungsverstärkung liegt.

Das kann für die Analyse von Resilienz und Selbstregulation interessant sein, ist aber nicht mit einer vollständigen Messung psychologischer Teamresilienz gleichzusetzen.


Faktor 6: Reifung der gemeinsamen Zielintegration – Entwickelt sich unsere gemeinsame Orientierung zu einer tragfähigen Grundlage?

Mathematische Größe: (\overline S_Z^{(10)})

Was bedeutet dieser Faktor für einen Coach?

Eine gemeinsame Vision entsteht selten durch einen einzelnen Workshop oder ein einmaliges Teammeeting.

In der Praxis entwickelt sie sich häufig schrittweise.

Teammitglieder formulieren Ziele, hinterfragen Annahmen, erkennen Gemeinsamkeiten und verändern ihre Vorstellungen.

Im agilen Management sprechen wir hier über Team Maturity, kontinuierliche Verbesserung, gemeinsame Lernprozesse und nachhaltiges Alignment.

Ein Coach würde fragen:

  • Verändert sich unsere gemeinsame Zielorientierung ständig grundlegend?
  • Können wir neue Erkenntnisse in unsere gemeinsame Vision integrieren?
  • Entwickeln wir über die Zeit eine nachvollziehbare Orientierung?
  • Bleiben unsere Ziele bei jeder neuen Diskussion offen oder bildet sich eine konsistentere Struktur?

Was misst der Faktor?

Der Reifungsfaktor untersucht die zeitliche Schwankungsarmut der semantischen Zielintegration.

Wenn sich die Zielintegration stark verändert, fällt der Faktor.

Bleibt sie über einen betrachteten Zeitraum relativ konstant, steigt er.

In der aktuellen Version wird zunächst ein turnweiser Reifungswert berechnet. Für den CMCI wird anschließend dessen gleitender Mittelwert über die letzten zehn Turns verwendet.

Beispiel aus der Teamarbeit

Ein Team diskutiert in jedem Sprint Planning erneut seine grundsätzliche Zielsetzung.

Die gemeinsame Orientierung verändert sich ständig. Entscheidungen aus früheren Sprint-Planungen werden regelmäßig infrage gestellt.

Ein anderes Team besitzt eine übergreifende Produktvision. Neue Erkenntnisse können in diese Vision eingeordnet werden, ohne dass ständig die gesamte Zielstruktur neu aufgebaut werden muss.

Coaching-Interpretation: (\overline S_Z^{(10)}) beschreibt die zeitliche Gleichmäßigkeit der gemeinsamen Zielintegrationsentwicklung.

Der Faktor kann Hinweise auf eine Stabilisierung der Zielorientierung geben.

Er misst allerdings nicht unmittelbar Teamreife. Auch eine stagnierende oder unzureichend integrierte Zielstruktur kann sehr konstant sein.

Deshalb ist dieser Faktor nur zusammen mit der tatsächlichen Qualität der Zielintegration sinnvoll interpretierbar.


Was bedeuten die sechs Faktoren gemeinsam?

Die sechs Faktoren lassen sich aus der Sicht eines Coaches als zusammengehörige Entwicklungsbedingungen verstehen.

CMCI-FaktorCoaching-BegriffZentrale Frage
(Z_6) – ZielintegrationShared Purpose, Alignment, CommitmentHaben wir eine gemeinsame, integrierbare Richtung?
(K_{\mathrm{top}}) – VernetzungCollaboration, Transparenz, SelbstorganisationSind wir als Team ausreichend miteinander verbunden?
(r_{\mathrm{sync}}) – SynchronisationKoordination, gegenseitige Abstimmung, Team FlowKönnen wir unsere Aktivitäten dynamisch aufeinander abstimmen?
(D_{\mathrm{eff}}) – Effektive DimensionDiversity, Adaptability, kollektives ProblemlösenVerfügt unsere Gruppendynamik über unterschiedliche Veränderungsmöglichkeiten?
(C_{\mathrm{dyn}}) – StabilitätResilienz, Selbstregulation, Umgang mit StörungenWie empfindlich ist unsere gemeinsame Dynamik?
(\overline S_Z^{(10)}) – ReifungTeam Maturity, kontinuierliches AlignmentWie gleichmäßig entwickelt sich unsere gemeinsame Zielorientierung?

Der besondere Ansatz des CMCI 6.0 besteht darin, diese Eigenschaften nicht isoliert zu betrachten.

Ein Team benötigt eine gemeinsame Zielorientierung, eine tragfähige Kommunikationsstruktur, die Fähigkeit zur gegenseitigen Abstimmung, unterschiedliche dynamische Reaktionsmöglichkeiten sowie geeignete Bedingungen für eine stabile und reifende Zusammenarbeit.

Die Faktoren stehen dabei in Wechselwirkung.

Gute Kommunikation kann das gegenseitige Verständnis fördern.

Besseres Verständnis kann die Integration individueller Ziele unterstützen.

Eine gemeinsame Zielorientierung kann wiederum die Koordination erleichtern.

Die mathematische Modellierung versucht, diese unterschiedlichen Voraussetzungen zu einer gemeinsamen Beschreibung der Collective Mind Fähigkeit zusammenzuführen.

Welche Bedeutung hat der CMCI für Management 4.0?

Management 4.0 betrachtet Organisationen nicht ausschließlich als hierarchisch gesteuerte Strukturen, sondern als komplexe soziale Systeme.

In solchen Systemen entstehen Leistungen durch die Interaktion vieler eigenständiger Akteure.

Traditionelle Führung konzentriert sich häufig auf die Steuerung einzelner Mitarbeiter, die Verteilung von Aufgaben und die Kontrolle von Ergebnissen.

Eine Führungskraft im Sinne von Management 4.0 muss darüber hinaus verstehen, welche Bedingungen die Entstehung kollektiver Intelligenz ermöglichen.

Hier eröffnet die Collective Mind Theory eine zusätzliche Perspektive.

Der Coach betrachtet nicht nur die Kompetenzen und das Verhalten einzelner Menschen, sondern insbesondere die Struktur und Dynamik ihrer Zusammenarbeit.

Dabei verändert sich die zentrale Führungsfrage.

Statt ausschließlich zu fragen:

Wie kann ich die Leistung der einzelnen Teammitglieder verbessern?

lautet sie:

Wie kann ich die Bedingungen gestalten, unter denen das Team seine kollektiven Fähigkeiten entfalten kann?

Der CMCI 6.0 soll helfen, diese Frage systematischer zu untersuchen.

Er kann beispielsweise darauf aufmerksam machen, dass ein Team zwar einen klaren Purpose besitzt, aber nur schwach vernetzt ist.

Oder dass eine intensive und gut synchronisierte Zusammenarbeit besteht, während zentrale individuelle Ziele nicht ausreichend integriert sind.

Ebenso kann ein Team eine gute Zielintegration entwickeln, obwohl seine momentane dynamische Stabilität gering ist.

Solche Unterschiede sind für Coaching und agile Führung wertvoll, weil sie auf unterschiedliche Ansatzpunkte für Interventionen hinweisen.

Vom Teamzustand zur Coaching-Intervention

Der CMCI ist zunächst ein mathematischer Forschungsindex und noch kein empirisch kalibriertes Diagnoseinstrument.

Sein möglicher praktischer Nutzen besteht darin, unterschiedliche Aspekte der Teamzusammenarbeit sichtbar und diskutierbar zu machen.

Ein Coach könnte die sechs Faktoren als Reflexionsgrundlage verwenden:

Bei schwacher Zielintegration könnte ein gemeinsamer Visions- oder Alignment-Workshop sinnvoll sein.

Bei geringer kommunikativer Vernetzung könnte die direkte Zusammenarbeit zwischen bisher getrennten Teilgruppen gefördert werden.

Bei niedriger Synchronisation könnten gemeinsame Abstimmungsmechanismen und transparentere Arbeitsprozesse helfen.

Bei geringer effektiver Dimension könnte untersucht werden, ob das Team auf wenige Reaktionsmuster fixiert ist.

Bei auffälliger dynamischer Empfindlichkeit könnten Selbstregulation, Konfliktbearbeitung und gemeinsame Reaktionsfähigkeit in den Mittelpunkt rücken.

Und bei starken Schwankungen der Zielintegration könnte ein regelmäßiger Abgleich zwischen individuellen Zielen, Team-Purpose und Produktvision hilfreich sein.

Diese Interventionen ergeben sich nicht automatisch aus der Mathematik. Sie sind mögliche Coaching-Hypothesen, die gemeinsam mit dem Team geprüft werden müssen.


Fazit: Collective Mind als neue Perspektive auf Teamleistung

Die Collective Mind Theory erweitert den Blick auf Teamleistung.

Nicht allein die individuellen Kompetenzen entscheiden darüber, welche Leistungen ein Team erbringen kann.

Ebenso wichtig sind die gemeinsame Zielorientierung, die Struktur der Kommunikation, die dynamische Abstimmung, die Vielfalt der Veränderungsmöglichkeiten sowie die Eigenschaften der gemeinsamen Gruppendynamik.

Der CMCI 6.0 versucht, diese Voraussetzungen mathematisch zu beschreiben.

Für Coaches, Scrum Master und Führungskräfte entsteht daraus eine neue Betrachtungsweise:

Die Aufgabe von Führung besteht nicht nur darin, Menschen zu koordinieren, sondern Bedingungen zu schaffen, unter denen ihre individuellen Fähigkeiten zu einer gemeinsamen, zielgerichteten Intelligenz zusammenfinden können.

Ein Collective Mind lässt sich dabei weder durch Harmonie noch durch intensiven Informationsaustausch allein erzeugen.

Er setzt voraus, dass unterschiedliche individuelle Perspektiven in einer gemeinsamen Zielorientierung verbunden werden können und die Gruppe über eine dafür geeignete dynamische Zusammenarbeit verfügt.

Der CMCI 6.0 ist ein erster mathematischer Versuch, diese Voraussetzungen systematisch zu untersuchen und dadurch die Entwicklung kollektiver Intelligenz für Coaching und Management 4.0 besser verständlich zu machen.


CMCI 6.0 – Die mathematische Beschreibung

1. Was misst der CMCI 6.0?

Der Collective Mind Criticality Index (CMCI 6.0) ist ein mathematischer Modellindex, mit dem untersucht wird, unter welchen Bedingungen eine Gruppe die Voraussetzungen für eine gemeinsame, integrierte Zielorientierung entwickelt.

Ein Collective Mind bedeutet dabei nicht, dass alle Gruppenmitglieder dieselbe Meinung besitzen. Entscheidend ist vielmehr, ob ihre individuellen Ziele, Werte und Perspektiven in eine übergeordnete, gemeinsam tragfähige Zielhierarchie integriert werden können.

Der Index verknüpft sechs unterschiedliche Eigenschaften der Gruppe:

  1. Semantische Zielintegration: Gibt es eine gemeinsame Zielstruktur, die die individuellen Perspektiven berücksichtigt?
  2. Kommunikative Vernetzung: Wie intensiv und kohäsiv sind die Teilnehmer miteinander verbunden?
  3. Synchronisation: In welchem Maß stimmen ihre modellierten dynamischen Zustände kohärent überein?
  4. Effektive kollektive Dimension: Wie viele unabhängige Veränderungsrichtungen sind in der Gruppendynamik aktiv?
  5. Transversale Stabilität: Wie verhält sich das System gegenüber Störungen, die die gemeinsame Ausrichtung verändern?
  6. Reifung der Zielintegration: Wie gleichmäßig entwickelt sich die gemeinsame Zielstruktur über die Zeit?

Der CMCI 6.0 verbindet diese sechs Eigenschaften multiplikativ. Ein niedriger Wert einer einzelnen Komponente kann somit den Gesamtindex erheblich reduzieren.

2. Die aktuelle Gesamtformel

    \[ \boxed{ \begin{aligned} \mathrm{CMCI}_6(t) ={}&Z_6(t)\cdot K_{\mathrm{top}}(t) \cdot r_{\mathrm{sync}}(t)\\ &\cdot\frac{D_{\mathrm{eff}}(t)}{N-1} \cdot C_{\mathrm{dyn}}(t) \cdot\overline{S}_Z^{(10)}(t) \end{aligned} } \]

Dabei bezeichnet t den untersuchten Turn, also einen einzelnen Gesprächsbeitrag, und N die Anzahl der Teilnehmer.

Die semantische Komponente enthält gegebenenfalls zusätzlich das Konflikt-Gate:
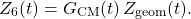
    \[ Z_6(t)=G_{\mathrm{CM}}(t)\,Z_{\mathrm{geom}}(t). \]

Ein ausdrücklich nachgewiesener, zentraler und ungelöster Zielkonflikt kann somit den Index auf null setzen.

Wichtig für die wissenschaftliche Interpretation: Ist das Konflikt-Gate noch unbewertet, verwendet das aktuelle Add-on für die Demonstrationsrechnung vorläufig G_{\mathrm{CM}}=1. Das bedeutet nicht, dass eine widerspruchsfrei integrierte gemeinsame Vision nachgewiesen wurde.

3. Faktor 1 – Semantische Zielintegration Z_6

Qualitative Bedeutung

Dieser Faktor untersucht, inwieweit die unterschiedlichen Ziele und Werte der Gruppenmitglieder in eine übergeordnete gemeinsame Zielhierarchie eingebunden werden können.

Vier Fragen stehen im Mittelpunkt:

  • Hierarchie: Gibt es überhaupt eine nachvollziehbare gemeinsame Zielstruktur?
  • Repräsentation: Werden die individuellen Ziele aller Teilnehmer berücksichtigt?
  • Wertevereinbarkeit: Sind diese Ziele mit den geäußerten Werten der Teilnehmer vereinbar?
  • Verständnis: Gibt es Hinweise darauf, dass die Teilnehmer die betreffende Zielstruktur verstehen?

Ein hoher Wert signalisiert innerhalb des Modells, dass die Voraussetzungen für eine gemeinsame Zielausrichtung vergleichsweise günstig sind.

Ein niedriger Wert zeigt dagegen an, dass die Zielstruktur unzureichend entwickelt ist oder wesentliche individuelle Perspektiven noch nicht integriert wurden.

Besonders wichtig ist: Gegenseitiges Verständnis bedeutet nicht automatisch Zustimmung. Deshalb werden Verständnis und Wertevereinbarkeit getrennt bewertet.

Mathematische Definition

Zunächst wird die geometrische Zielintegration berechnet:
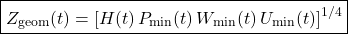
    \[ \boxed{ Z_{\mathrm{geom}}(t)= \left[ H(t)\, P_{\min}(t)\, W_{\min}(t)\, U_{\min}(t) \right]^{1/4} } \]

mit

    \[ P_{\min}(t)=\min_{1\le i\le N}P_i(t) \]

    \[ W_{\min}(t)=\min_{1\le i\le N}W_i(t) \]

    \[ U_{\min}(t)=\min_{1\le i\le N}U_i(t). \]

Die Größen haben folgende Bedeutung:

SymbolDefinitionWertebereich
H(t)Qualität der übergeordneten Zielhierarchie0 bis 1
P_i(t)Repräsentation der Ziele von Teilnehmer i0 bis 1
W_i(t)Vereinbarkeit der Zielstruktur mit den geäußerten Werten von i0 bis 1
U_i(t)Evidenz für das Verständnis der Zielstruktur durch i0 bis 1
NAnzahl der TeilnehmerGanze Zahl, mindestens 2

Die Verwendung der Minima folgt einem bewussten theoretischen Prinzip: Eine gemeinsame Vision soll nicht allein dadurch als erfolgreich integriert gelten, dass die Mehrheit zufrieden ist, während einzelne Teilnehmer mit ihren zentralen Zielen unberücksichtigt bleiben.

Das geometrische Mittel verhindert zugleich, dass vier moderate Bewertungen durch bloße Multiplikation einen extrem kleinen Zahlenwert erzeugen.

Das Konflikt-Gate

Zusätzlich gilt:
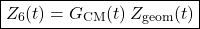
    \[ \boxed{ Z_6(t)=G_{\mathrm{CM}}(t)\,Z_{\mathrm{geom}}(t) } \]

mit

    \[ G_{\mathrm{CM}}(t)\in\{0,1\}. \]

Dabei bedeutet:

  • G_{\mathrm{CM}}=0: Ein zentraler, ungelöster und nach den Modellkriterien nicht integrierbarer Zielkonflikt wurde ausdrücklich festgestellt.
  • G_{\mathrm{CM}}=1: Kein solcher harter Ausschluss wurde ausdrücklich festgestellt.

Für noch nicht bewertete Situationen kennt das Datenmodell zusätzlich den Zustand unbekannt. Im aktuellen Add-on wird dieser Zustand für einen ausdrücklich gekennzeichneten Demonstrationsverlauf vorläufig wie 1 behandelt.

Daraus ergibt sich eine entscheidende mathematische Eigenschaft:
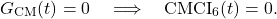
    \[ G_{\mathrm{CM}}(t)=0 \quad\Longrightarrow\quad \mathrm{CMCI}_6(t)=0. \]

Interpretation: Ein zentraler, nicht integrierbarer Zielkonflikt kann nicht durch besonders intensive Kommunikation oder hohe Synchronisation kompensiert werden.

4. Faktor 2 – Kommunikative Vernetzung K_{\mathrm{top}}

Qualitative Bedeutung

Dieser Faktor beschreibt, wie die Gruppenmitglieder über ihre Gesprächsbeziehungen miteinander verbunden sind.

Dabei genügt es nicht, dass viel gesprochen wird. Entscheidend ist vielmehr, wie die Kommunikationskontakte auf die Gruppe verteilt sind.

Eine Gruppe, in der alle Beteiligten nur mit dem Moderator kommunizieren, hat eine andere Netzwerkstruktur als eine Gruppe, in der die Teilnehmer miteinander in wechselseitigem Austausch stehen.

Der Faktor nutzt deshalb die Struktur des gesamten Kommunikationsnetzes.

Mathematische Definition

Zunächst wird eine gerichtete Kontaktmatrix aufgebaut:
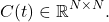
    \[ C(t)\in\mathbb{R}^{N\times N}. \]

Der Eintrag C_{ij}(t) beschreibt die zeitlich abklingende Kontakthistorie von Teilnehmer j zu Teilnehmer i.

Die Aktualisierung ist definiert als:
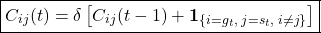
    \[ \boxed{ C_{ij}(t)= \delta\left[ C_{ij}(t-1)+ \mathbf{1}_{\{i=g_t,\;j=s_t,\;i\ne j\}} \right] } \]

mit:

SymbolBedeutung
s_tSprecher bei Turn t
g_tAdressat bei Turn t
\mathbf{1}Indikatorfunktion, bei erfüllter Bedingung 1, sonst 0
\deltaGedächtnis- bzw. Abklingfaktor
\delta=0{,}90Im aktuellen Code verwendeter Wert
C_{ij}(0)Anfangszustand der Kontaktmatrix, null

Das bedeutet: Frühere Kommunikationskontakte verlieren pro Turn 10 % ihres bisherigen Gewichts.

Aus der gerichteten Matrix wird eine symmetrische, nichtnegative Adjazenzmatrix berechnet:
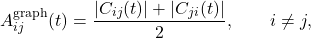
    \[ A_{ij}^{\mathrm{graph}}(t) = \frac{|C_{ij}(t)|+|C_{ji}(t)|}{2}, \qquad i\ne j, \]

mit verschwindender Diagonale.

Anschließend wird die Laplace-Matrix des Kommunikationsgraphen gebildet:
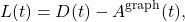
    \[ L(t)=D(t)-A^{\mathrm{graph}}(t), \]

wobei

    \[ D_{ii}(t)=\sum_j A_{ij}^{\mathrm{graph}}(t). \]

Der zweitkleinste Eigenwert von L(t),

    \[ \lambda_2(L(t)), \]

wird als algebraische Konnektivität oder spektraler Gap bezeichnet.

Für einen ungerichteten, nichtnegativ gewichteten Graphen gilt:

    \[ \lambda_2(L)>0 \]

genau dann, wenn der Graph zusammenhängend ist.

Auf der Basis von lambda wird die über die gesamte untersuchte Gesprächssequenz normierte Größe G definiert:
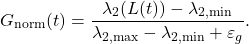
    \[ G_{\mathrm{norm}}(t)= \frac{ \lambda_2(L(t))-\lambda_{2,\min} }{ \lambda_{2,\max}-\lambda_{2,\min}+\varepsilon_g }. \]

Hierbei sind \lambda_{2,\min} und \lambda_{2,\max} das Minimum und Maximum des spektralen Gaps im jeweiligen Datensatz; im Code ist \varepsilon_g=10^{-9}.

Schließlich gilt:

    \[ \boxed{ K_{\mathrm{top}}(t)=0{,}1+G_{\mathrm{norm}}(t) } \]

Der additive Sockelwert 0,1 verhindert, dass ein zeitweise verschwindender spektraler Gap den gesamten CMCI automatisch auf null setzt.

Daraus folgt der ungefähre Wertebereich:
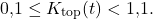
    \[ 0{,}1\le K_{\mathrm{top}}(t)<1{,}1. \]

Methodischer Hinweis: Die Normierung ist datensatzbezogen. Ein hoher K_{\mathrm{top}}-Wert bedeutet daher zunächst eine starke Vernetzung relativ zur jeweiligen Sendung. Identische Zahlenwerte aus zwei verschiedenen Sendungen sind nicht automatisch identische absolute Netzwerkzustände.

5. Faktor 3 – Synchronisation r_{\mathrm{sync}}

Qualitative Bedeutung

Die Synchronisation beschreibt, wie weit die modellierten dynamischen Zustände der Gruppenmitglieder miteinander übereinstimmen.

Man kann sich die einzelnen Teilnehmer vereinfacht als miteinander gekoppelte Oszillatoren vorstellen. Jeder besitzt eine eigene Dynamik, wird aber zugleich von den anderen beeinflusst.

Synchronisation tritt ein, wenn diese Oszillatoren Phasenbeziehungen ausbilden, die zu einer gemeinsamen dynamischen Ausrichtung führen.

Dabei gilt ausdrücklich:

Synchronisation ist nicht gleichbedeutend mit Zustimmung.

Auch Menschen mit gegensätzlichen Meinungen können stark synchronisiert sein, etwa weil sie sich intensiv und unmittelbar aufeinander beziehen.

Mathematische Definition

Für jeden Teilnehmer i wird eine Phase definiert:

    \[ \theta_i(t)\in[0,2\pi). \]

Die Synchronisation wird durch den komplexen Ordnungsparameter gemessen:
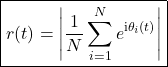
    \[ \boxed{ r(t)= \left| \frac{1}{N} \sum_{i=1}^{N} e^{\mathrm{i}\theta_i(t)} \right| } \]

mit:

  • N: Anzahl der Teilnehmer.
  • \theta_i(t): Phase des Teilnehmers i.
  • \mathrm{i}=\sqrt{-1}: imaginäre Einheit.
  • |\cdot|: Betrag einer komplexen Zahl.

Es gilt:

    \[ 0\le r(t)\le1. \]

Bei r=1 besitzen alle Teilnehmer dieselbe Phase. Kleine Werte zeigen eine stärker verteilte Phasenkonfiguration.

Berechnung der Teilnehmerphasen

Im CMCI 6.0 Modell werden die Phasen über ein diskretes, gekoppeltes dynamisches System fortgeschrieben:
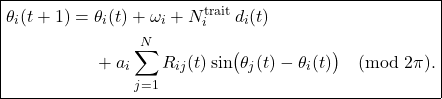
    \[ \boxed{ \begin{aligned} \theta_i(t+1) ={}&\theta_i(t)+\omega_i +N_i^{\mathrm{trait}}\,d_i(t)\\ &+a_i\sum_{j=1}^{N} R_{ij}(t) \sin\bigl(\theta_j(t)-\theta_i(t)\bigr) \pmod{2\pi}. \end{aligned} } \]

Die einzelnen Größen sind:

    \[ a_i=\frac{1}{1+\gamma C_i^{\mathrm{trait}}}, \qquad \gamma=1. \]

    \[ \omega_i= \alpha_\omega\|\mathbf v_i\|_2, \qquad \alpha_\omega=0{,}5. \]

    \[ d_i(t)= \begin{cases} \mathrm{ar}(t)\,\mathrm{val}(t),&i=s_t,\\ 0,&i\ne s_t. \end{cases} \]

Hier bedeuten:

SymbolBedeutung
\omega_iIndividuelle Eigenfrequenz
\mathbf v_iDreidimensionales Werteprofil des Teilnehmers
\|\mathbf v_i\|_2Euklidische Norm des Werteprofils
\alpha_\omega=0{,}5Skalierung der Eigenfrequenz
N_i^{\mathrm{trait}}Neurotizismuswert des Big-Five-Profils
C_i^{\mathrm{trait}}Gewissenhaftigkeitswert des Big-Five-Profils
\gamma=1Parameter der individuellen Trägheit
\mathrm{ar}(t)Annotiertes Arousal des Gesprächsbeitrags
\mathrm{val}(t)Annotierte Valenz des Gesprächsbeitrags
d_i(t)Direkter emotionaler Antrieb des aktuellen Sprechers
R_{ij}(t)Effektive Kopplung von Teilnehmer j auf i

Die Kopplung lautet:

    \[ R_{ij}(t)=C_{ij}(t)\Lambda_{ij}. \]

Für i\ne j berechnet der Code:

    \[ \Lambda_{ij} = (O_i+A_i)(1{,}2E_j) \,S_{ij}\, M_{\rho_i\rho_j}, \]

mit

    \[ S_{ij}= \frac{\mathbf v_i^\top\mathbf v_j} {(\|\mathbf v_i\|_2+10^{-9}) (\|\mathbf v_j\|_2+10^{-9})}. \]

Dabei stehen E_i,A_i,O_i für Extraversion, Verträglichkeit und Offenheit, \rho_i für das dem Teilnehmer zugeordnete Werteregime und M für die Kompatibilitätsmatrix

    \[ M= \begin{pmatrix} 1&-0{,}2&-1\\ -0{,}2&1&0{,}2\\ -1&0{,}2&1 \end{pmatrix}. \]

Die Regimezuordnung erfolgt durch Maximierung dreier Scores:
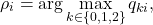
    \[ \rho_i=\arg\max_{k\in\{0,1,2\}}q_{ki}, \]

    \[ \begin{aligned} q_{0i}&=1{,}5v_{i2}-0{,}5v_{i3},\\ q_{1i}&=1{,}2v_{i1}-0{,}3|v_{i2}-v_{i3}|,\\ q_{2i}&=1{,}5v_{i3}-0{,}5v_{i2}. \end{aligned} \]

Die drei Wertekoordinaten sind hier v_{i1},v_{i2},v_{i3}. Die Regimezuordnung und die Kompatibilitätsmatrix sind Annahmen der aktuellen Modellfassung.

Zu Beginn werden die Phasen gleichverteilt in [0,2\pi) initialisiert. Der verwendete Pseudozufallszahlengenerator erhält den Seed SEED + 17, damit sich bei gleichen Eingaben diese reproduzieren lassen.

Synchronisation im CMCI 6.0

Die rohe Synchronisation wird über fünf Gesprächsbeiträge gleitend gemittelt:
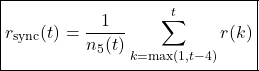
    \[ \boxed{ r_{\mathrm{sync}}(t)= \frac{1}{n_5(t)} \sum_{k=\max(1,t-4)}^t r(k) } \]

mit

    \[ n_5(t)=\min(5,t). \]

Die Glättung dieser Größe ist nicht mit der zusätzlichen Glättung der gezeichneten Kurven zu verwechseln.

6. Faktor 4 – Effektive kollektive Dimension D_{\mathrm{eff}}

Qualitative Bedeutung

Dieser Faktor beschreibt die Vielfalt der unabhängigen dynamischen Veränderungsmöglichkeiten des Systems.

Eine Gruppe kann sehr stark auf eine einzige Dynamikrichtung ausgerichtet sein. Beispielsweise können alle Teilnehmer einem dominierenden Konfliktmuster folgen.

Sie kann aber auch mehrere unabhängige Richtungen besitzen, in denen sich ihre gemeinsame Dynamik verändert.

Der Faktor D_{\mathrm{eff}} untersucht diese dynamische Vielfalt.

Dabei gilt: Eine höhere effektive Dimension ist in unserem CMCI-Modell positiv gewichtet. Sie ist jedoch nicht automatisch ein Nachweis höherer Kreativität oder Intelligenz.

Mathematische Definition

Ausgangspunkt ist die Jacobi-Matrix der Phasendynamik:
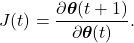
    \[ J(t)= \frac{\partial\boldsymbol{\theta}(t+1)} {\partial\boldsymbol{\theta}(t)}. \]

Sie beschreibt, wie kleine Veränderungen der Phasen zum nächsten Zeitpunkt fortgeschrieben werden.

Für i\ne j gilt:

    \[ J_{ij}(t)= a_i R_{ij}(t) \cos(\theta_j(t)-\theta_i(t)). \]

Für die Diagonale gilt:

    \[ J_{ii}(t)= 1-a_i\sum_{j\ne i} R_{ij}(t) \cos(\theta_j(t)-\theta_i(t)). \]

Hier sind a_i,R_{ij} und \theta_i dieselben Größen wie im Synchronisationsmodell.

Über einen Zeithorizont von h=10 Turns wird anschließend das Produkt

    \[ \boxed{ M_h(t)= J(t)J(t-1)\cdots J(t-h+1) } \]

berechnet.

Dieses Produkt beschreibt die linearisierte Entwicklung kleiner Phasenstörungen über zehn aufeinanderfolgende Turns.

Projektion auf den transversalen Raum

Eine gleichmäßige Verschiebung aller Phasen ist keine Änderung ihrer relativen Beziehungen.

Deshalb wird die Richtung
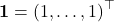
    \[ \mathbf{1}=(1,\ldots,1)^\top \]

aus der Analyse herausgenommen.

Dazu definieren wir
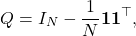
    \[ Q=I_N-\frac{1}{N}\mathbf{1}\mathbf{1}^\top, \]

wobei I_N die N\times N-Einheitsmatrix bezeichnet.

Eine Matrix
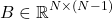
    \[ B\in\mathbb{R}^{N\times(N-1)} \]

bildet eine orthonormale Basis des transversalen Raums:
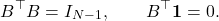
    \[ B^\top B=I_{N-1}, \qquad B^\top\mathbf 1=0. \]

Nun betrachten wir die transversale Veränderung gegenüber der Identität:
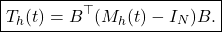
    \[ \boxed{ T_h(t)= B^\top(M_h(t)-I_N)B. } \]

Seien

    \[ \sigma_1(t),\ldots,\sigma_{N-1}(t) \]

die Singulärwerte dieser Matrix.

Die effektive Dimension lautet:
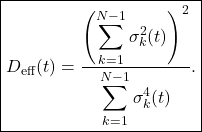
    \[ \boxed{ D_{\mathrm{eff}}(t)= \frac{ \left(\displaystyle\sum_{k=1}^{N-1}\sigma_k^2(t)\right)^2 }{ \displaystyle\sum_{k=1}^{N-1}\sigma_k^4(t) }. } \]

Ist der Nenner numerisch praktisch null, verwendet der Code D_{\mathrm{eff}}=0.

Damit gilt für eine von null verschiedene transversale Veränderungsmatrix:
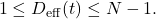
    \[ 1\le D_{\mathrm{eff}}(t)\le N-1. \]

Für den CMCI wird dieser Wert normiert:
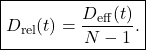
    \[ \boxed{ D_{\mathrm{rel}}(t)= \frac{D_{\mathrm{eff}}(t)}{N-1}. } \]

Bei den beiden bisher untersuchten Sendungen mit fünf Teilnehmern ist:
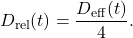
    \[ D_{\mathrm{rel}}(t)=\frac{D_{\mathrm{eff}}(t)}{4}. \]

Wissenschaftliche Einordnung

Die Formel entspricht einer effektiven Rangzahl auf Basis der quadrierten Singulärwerte.

Sind mehrere Singulärwerte ähnlich groß, ist D_{\mathrm{eff}} hoch. Dominiert dagegen ein einziger Singulärwert, nähert sich die effektive Dimension dem Wert 1.

Das ist eine mathematisch präzise Aussage über die linearisierte Modellbewegung, aber noch keine direkte Messung der tatsächlichen Vielfalt menschlicher Denkprozesse.

7. Faktor 5 – Transversale Stabilität C_{\mathrm{dyn}}

Qualitative Bedeutung

Eine Gruppe kann kurzfristig koordiniert erscheinen, ohne dass ihre gemeinsame Ausrichtung stabil ist.

Der transversale Stabilitätsfaktor untersucht deshalb, wie empfindlich die modellierte Gruppendynamik gegenüber kleinen Störungen der relativen Teilnehmerphasen ist.

Eine stabile Konfiguration bedeutet, dass solche Störungen nicht stark anwachsen.

Eine empfindliche Konfiguration bedeutet dagegen, dass kleine Veränderungen die relativen Phasen erheblich beeinflussen können.

Im CMCI 6.0 werden dynamisch wenig empfindliche Zustände höher bewertet.

Mathematische Definition

Wir verwenden erneut das Jacobi-Produkt

    \[ M_h(t)=J(t)\cdots J(t-h+1) \]

mit h=10.

Die transversale Wirkung dieses Produkts lautet:
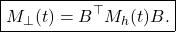
    \[ \boxed{ M_{\perp}(t)=B^\top M_h(t)B. } \]

Der größte Singulärwert

    \[ \sigma_{\max}(M_\perp(t)) \]

beschreibt die maximale linearisierte Verstärkung einer transversalen Störung über das betrachtete Zeitfenster.

Daraus wird eine endliche transversale Wachstumsrate berechnet:
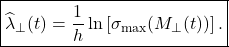
    \[ \boxed{ \widehat{\lambda}_{\perp}(t)= \frac{1}{h} \ln\left[ \sigma_{\max}(M_\perp(t)) \right]. } \]

Dabei gilt:

  • \widehat{\lambda}_{\perp}<0: Die maximale transversale Störungsverstärkung über das Fenster ist kleiner als 1.
  • \widehat{\lambda}_{\perp}=0: Die maximale Verstärkung beträgt 1.
  • \widehat{\lambda}_{\perp}>0: Mindestens eine transversale Störungsrichtung wird verstärkt.

Aus numerischen Gründen begrenzt der Code das Argument des Logarithmus von unten auf die kleinste positive darstellbare Gleitkommazahl.

Der Stabilitätsfaktor des CMCI lautet:
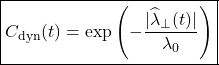
    \[ \boxed{ C_{\mathrm{dyn}}(t)= \exp\left( -\frac{|\widehat{\lambda}_{\perp}(t)|} {\lambda_0} \right) } \]

mit

    \[ \lambda_0=0{,}05. \]

Es gilt:

    \[ 0<C_{\mathrm{dyn}}(t)\le1. \]

Bedeutung des Parameters \lambda_0

Der Parameter \lambda_0 steuert, wie stark der Index auf transversale Wachstums- oder Schrumpfungsraten reagiert.

Kleine Werte von \lambda_0 führen zu einer stärkeren Bestrafung von Abweichungen.

Beispielsweise ergibt sich bei

    \[ |\widehat{\lambda}_{\perp}|=0{,}05 \]

der Wert

    \[ C_{\mathrm{dyn}}=e^{-1}\approx0{,}368. \]

Bei

    \[ |\widehat{\lambda}_{\perp}|=0{,}10 \]

folgt bereits

    \[ C_{\mathrm{dyn}}=e^{-2}\approx0{,}135. \]

Das erklärt die ausgeprägten CMCI-Einbrüche, die wir bei ML1 und ML2 beobachtet haben.

Eine wichtige theoretische Besonderheit

Der aktuelle Faktor verwendet den Betrag der transversalen Wachstumsrate.

Damit werden sowohl positive als auch negative Wachstumsraten bestraft. Der höchste Faktorwert wird bei einer Wachstumsrate nahe null erreicht.

Das bedeutet: Der Faktor bevorzugt eine ungefähr neutrale transversale Dynamik und nicht eine möglichst starke Kontraktion.

Dies ist eine bewusste Eigenschaft der implementierten Formel. Streng genommen sollte man daher nicht behaupten, C_{\mathrm{dyn}} messe einfach nur asymptotische Stabilität. Präziser wäre:

Er misst die Nähe der endlichen transversalen Wachstumsrate zum neutralen Zustand null.

8. Faktor 6 – Reifung der Zielintegration \overline S_Z^{(10)}

Qualitative Bedeutung

Eine gemeinsame Zielvorstellung entsteht nicht unbedingt plötzlich. Sie kann sich über mehrere Gesprächsschritte entwickeln, verändern oder wieder auflösen.

Der Reifungsfaktor untersucht, wie stark die semantische Zielintegration innerhalb eines kurzen vergangenen Zeitfensters schwankt.

Eine relativ gleichmäßige Entwicklung wird höher bewertet. Starke Veränderungen werden niedriger bewertet.

Damit ergänzt dieser Faktor die Frage, wie gut die Ziele integriert sind, um die Frage, wie ruhig oder gleichmäßig sich diese Integration entwickelt.

Allerdings ist Gleichmäßigkeit allein kein Beweis für gelungene Reifung: Auch eine stagnierende, schlecht integrierte Gruppe kann niedrige Schwankungen aufweisen.

Mathematische Definition

Die neue Implementierung arbeitet mit einem rückblickenden Fenster von

    \[ w=10 \]

Turns.

Die Grundlage ist eine turnweise angenäherte Zielintegration Z^\ast(t). Sie wird aus den vorhandenen Checkpointbewertungen erzeugt. Zwischen den Checkpoints werden die zuletzt verfügbaren Werte fortgeschrieben; vor dem ersten Checkpoint übernimmt der aktuelle Code den ersten Checkpointwert.

Damit liegen zwischen den annotierten Checkpoints keine unabhängig gemessenen neuen Zielintegrationswerte vor.

Zunächst wird die Änderung zwischen zwei Turns bestimmt:
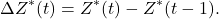
    \[ \Delta Z^\ast(t)= Z^\ast(t)-Z^\ast(t-1). \]

Für den ersten Turn setzt der Code die Differenz auf null.

Aus den letzten zehn Differenzen wird die quadratische mittlere Schwankung berechnet:
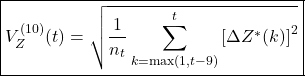
    \[ \boxed{ V_Z^{(10)}(t)= \sqrt{ \frac{1}{n_t} \sum_{k=\max(1,t-9)}^t \left[\Delta Z^\ast(k)\right]^2 } } \]

mit

    \[ n_t=\min(10,t). \]

Daneben wird das gleitende Mittel der Zielintegration berechnet:
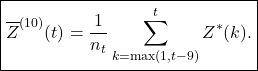
    \[ \boxed{ \overline Z^{(10)}(t)= \frac{1}{n_t} \sum_{k=\max(1,t-9)}^t Z^\ast(k). } \]

Daraus ergibt sich der turnweise Reifungsfaktor:
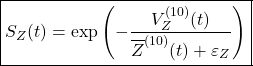
    \[ \boxed{ S_Z(t)= \exp\left( -\frac{V_Z^{(10)}(t)} {\overline Z^{(10)}(t)+\varepsilon_Z} \right) } \]

mit

    \[ \varepsilon_Z=10^{-6}. \]

Dieser kleine Parameter verhindert eine Division durch null.

Der Reifungsfaktor liegt im Bereich
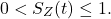
    \[ 0<S_Z(t)\le1. \]

Der Mittelwert über die letzten zehn Turns

Für den CMCI verwenden wir jetzt ausdrücklich nicht nur den momentanen Wert S_Z(t), sondern dessen Mittelwert über die letzten zehn Turns:
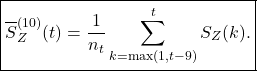
    \[ \boxed{ \overline S_Z^{(10)}(t)= \frac{1}{n_t} \sum_{k=\max(1,t-9)}^t S_Z(k). } \]

Genau dieser Mittelwert ist der sechste Faktor der aktuellen CMCI-6.0-Formel.

Damit berücksichtigt die Reifungskomponente sowohl die Schwankungen innerhalb der lokalen Zielintegrationsentwicklung als auch die zeitliche Mittelung der daraus berechneten Reifungswerte.

Beispiel zur Interpretation

Angenommen, die Zielintegration bleibt in zehn aufeinanderfolgenden Turns unverändert.

Dann gilt:

    \[ \Delta Z^\ast(k)=0 \]

für alle Turns des Fensters. Somit ist

    \[ V_Z^{(10)}(t)=0 \]

und folglich

    \[ S_Z(t)=1. \]

Der Faktor bewertet diesen Abschnitt dann als vollständig schwankungsarm.

Dagegen erzeugt ein abrupter Anstieg oder Rückgang der Zielintegration eine positive quadratische Schwankung und damit einen Faktor kleiner 1.

Wichtig: Auch ein konstruktiver, plötzlicher Integrationsfortschritt kann also zunächst zu einer Absenkung von S_Z führen. Der Faktor unterscheidet nicht zwischen positiven und negativen Veränderungen, sondern misst deren Betrag.

9. Zusammenführung aller sechs Faktoren

Die aktuell implementierte Formel lautet damit:
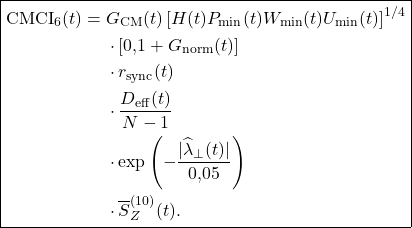
    \[ \boxed{ \begin{aligned} \mathrm{CMCI}_6(t) ={}& G_{\mathrm{CM}}(t) \left[ H(t)P_{\min}(t)W_{\min}(t)U_{\min}(t) \right]^{1/4}\\ &\cdot \left[0{,}1+G_{\mathrm{norm}}(t)\right]\\ &\cdot r_{\mathrm{sync}}(t)\\ &\cdot \frac{D_{\mathrm{eff}}(t)}{N-1}\\ &\cdot \exp\left( -\frac{|\widehat{\lambda}_{\perp}(t)|}{0{,}05} \right)\\ &\cdot \overline S_Z^{(10)}(t). \end{aligned} } \]

Alle sechs Faktoren werden zum betrachteten Checkpoint t ausgewertet. Das Modell benötigt dafür die semantischen Bewertungen aus der erweiterten Transkriptdatei, die Persönlichkeitsprofile und die Gesprächssequenz.

10. Glättung der grafischen Darstellung

In den obigen Abbildungen werden die sechs Faktoren und der CMCI gemeinsam dargestellt. Dabei besitzen die Faktoren und der CMCI zwei getrennte vertikale Skalen, damit auch vergleichsweise kleine CMCI-Werte sichtbar bleiben.

Für die grafische Darstellung verwendet der Code zusätzlich einen zentrierten gleitenden Mittelwert über drei Checkpoints:
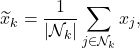
    \[ \widetilde{x}_k = \frac{1}{|\mathcal N_k|} \sum_{j\in\mathcal N_k}x_j, \]

wobei \mathcal N_k den vorherigen, aktuellen und folgenden Checkpoint umfasst, soweit diese vorhanden sind.

Diese Glättung dient ausschließlich der Visualisierung. Die Faktoren werden zunächst mit ihren ursprünglichen Werten multipliziert und erst danach für die Darstellung geglättet.

Damit ist eine klare Trennung gewährleistet zwischen:

  • mathematischer Modellberechnung, einschließlich des rückblickenden 10-Turn-Mittelwerts für S_Z;
  • grafischer Glättung, die lediglich die Darstellung übersichtlicher macht.

Die zentrierte grafische Glättung verwendet auch den folgenden Checkpoint. Sie eignet sich deshalb für die rückblickende Analyse, nicht für eine Echtzeitprognose.

11. Wissenschaftliche Grenzen der aktuellen Version

Ich halte drei Präzisierungen für wichtig.

Erstens: Die Größen H,P,W,U beruhen bislang auf transkriptgestützten Bewertungen, nicht auf einer kontinuierlichen Messung jedes Gesprächsbeitrags. Deshalb ist auch der turnweise Reifungsfaktor eine Approximation. Insbesondere kann die Fortschreibung zwischen zwei Checkpoints zu einer künstlich hohen Schwankungsarmut führen. Der neue 10-Turn-Mittelwert ist mathematisch implementiert, seine Interpretation als tatsächliche Reifung bleibt aber vorläufig.

Zweitens: Das Modell ist eine mathematische Analogie gekoppelter dynamischer Systeme. Die komplexen Phasen, Singulärwerte und Jacobimatrizen beschreiben eine simulierte Gruppendynamik. Sie belegen weder quantenphysikalische Prozesse noch unmittelbar messbare neuronale Synchronisation zwischen den Teilnehmern.

Drittens: Die sechs Faktoren sind hinsichtlich ihrer empirischen Bedeutung nicht unabhängig validiert. Der CMCI 6.0 ist deshalb vorläufig ein theoriegeleiteter Prozessindikator und kein universell kalibriertes Messinstrument für Collective Mind.

Zusammenfassung

Der CMCI 6.0 verbindet Kenngrößen zur Netzwerk-Kohäsion mit der dynamische Kohärenz einer Gruppe und deren semantischen Zielintegration.

Eine intensive, synchronisierte und dynamisch günstige Kommunikation genügt nicht, wenn die individuellen Ziele nicht in eine tragfähige gemeinsame Zielhierarchie eingebunden werden können.

Umgekehrt kann eine zunehmend gut strukturierte Zielhierarchie bestehen, ohne dass die Gruppe bereits eine entsprechend günstige gemeinsame Dynamik entwickelt hat.

Ein spezieller Faktor misst die zeitliche Gleichmäßigkeit der Zielintegration.

Der CMCI 6.0 beschreibt damit nicht allein den Zustand einer Gruppe, sondern untersucht die Bedingungen, unter denen sich eine gemeinsame Zielorientierung entwickeln und dynamisch trägt.
Attention Collective Mind II: Agile Leadership RL-Agent

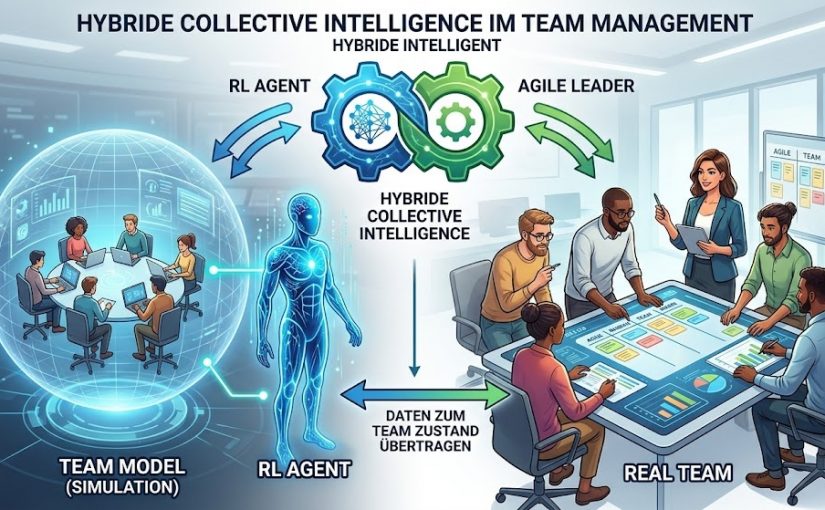
Kurzfassung: Der QKV Mechanismus der Transformer KI Architektur wird erstmalig auf ein Team-Modell und einen das Team führenden ’sozialen‘ RL-Agenten angewendet. Der RL-Agent wird unterschiedlichen Team-und Projekt-Konstellationen ausgesetzt. Team- und Projektkonstellationen sowie die Reward-Funktion, die den RL-Agenten über Reinforcement Learning (RL) zur guten Agile Führung anleitet, basieren auf den Grundlagen des Collective Mind und des Management 4.0 Modells. Es wird gezeigt, dass der hier modellierte Collective Mind QKV Mechanismus einem RL-Agenten die Fähigkeit verleiht, die aus realen Teams bekannten Situationen in Modell Teams zu beherrschen. Damit ist es möglich, eine hybrides Collective Intelligence System aus RL-Agent und Agiler Führungskraft für die Führung eines realen Teams einzusetzen.

Diese Blog-Beitrag ist mit Hilfe von Gemini 3 Pro erstellt. In dem Attention Collective Mind Teil I habe ich auch einen Ausflug in das Thema Intelligenz von KI Systemen gemacht. Ich habe darauf hingewiesen, dass die immer noch in den sozialen Medien zu findende Aussage, KI Systeme seien bloße ‚Statistische Maschinen‘, jeglicher Grundlage entbehrt. Ich verfüge inzwischen über mehrere Jahre sehr intensiver und anspruchsvoller KI-Nutzung und behaupte deshalb, dass solche Aussagen nicht zutreffen. Der folgende Beitrag zeigt, wie auch die vorherigen Beiträge, dass die Fähigkeit der KI-Systeme interdisziplinäre und innovative Zusammenhänge herzustellen, enorm ist und die kognitive Intelligenz der meisten Menschen mit Abstand übersteigt. 

Im vorherigen Blog-Beitrag dieser Reihe war es mein Ziel, ein einfaches Collective Mind Modell auf der Basis des QKV Mechanismus der Transformer vorzustellen. – Dies ist auch sehr gut gelungen. Jedoch enthielt der QKV Mechanismus keinen autonomen Lern-Mechanismus, da er über ein Regelwerk implementiert worden ist.

Der nächste folgerichtige Schritt ist also, das Regelwerk durch einen selbst lernenden Mechanismus zu ersetzten. Hierzu habe ich das Toy-Modell in ein System mit neuronalem Netzwerk auf der Basis des quelloffenen Deep Learning Frameworks PyTorch übertragen. PyTorch wurde ehemals von Meta entwickelt und basiert auf Python. Das erste Modell des neuen Systems mit neuronalem Netzwerk habe ich einfach PyTorch Modell genannt. Ich habe mir keine große Mühe bei der Namensgebung gegeben, da sich schnell herausstellte, dass der Einbau eines ‚einfachen‘ neuronalen Netzwerkes mit QKV Mechanismus für meinen Anwendungsfall ‚Führen eines Collective Mind Teams durch eine KI‘ keinen Erfolg zeigte: Ein neuronales Netzwerk ist noch kein Garant für einen selbst lernenden QKV Mechanismus. Ich werde später nochmals auf diese Erfahrung zurückkommen.

Ich musste das neuronale Netzwerk zu einem Reinforcement Learning (RL) Agenten System erweitern. In diesem Fall lernt ein autonomer Agent ohne explizite menschliche Anleitung, in dem er in Wechselwirkung mit seiner Umgebung tritt. Durch Versuch und Irrtum erhält er Rückmeldung von seiner Umgebung. Diese Rückmeldungen werden in ‚Rewards‘, also Belohnungen, umgesetzt. Der RL-Agent versucht seine Belohnungen über die Zeit zu maximieren. Ein RL-Agent benötigt also eine Trainingszeit jedoch keine Trainingsdaten. Die Umgebung liefert ihm, wie bei einem Menschen auch, die Daten. Im Falle des Collective Mind Teams ist das Team die Umgebung. Das Team liefert bestimmte Daten (zum Beispiel die Stimmung der Teammitglieder) und der RL-Agent probiert Aktionen aus. Er erfährt, ob diese Aktionen die Stimmung im Team verbessern. Falls dies der Fall ist, wird er belohnt, falls nicht, wird er nicht belohnt oder sogar bestraft. Am Anfang ist der RL-Agent ein Junior Leader. Wird das Lernen mit der Zeit immer besser, entwickelt er sich zu einem Senior Leader.

Die nachfolgende Tabelle 1 charakterisiert die vier untersuchten ‚Attention Collective Mind‘ Modelle:

Merkmal Toy Modell PyTorch Modell RL Agent Modell Hybrid-Architektur
(RL Agent + LLM)
Architektur-Typ Regelbasiertes Skript Reaktiver Energie-Optimierer Reinforcement Learning Neuro-Symbolische KI
Entscheidungs-Logik Harte, vom Menschen manuell geschriebene if/else-Regeln. Ein neuronales Netz minimiert jeden Tag ’stur‘ einen mathematischen ‚Energy Loss‘ (Gradient Descent). Sucht in Simulationen nach der Maximierung des Reward, also der  mathematisch optimalen Balance aus Leistung, Psyche und Inklusion.

RL-Agent (Backend): Berechnet die Fakten.

LLM (Frontend): Übernimmt die Kommunikation.

Zwischen RL-Agent und LLM gibt es eine LLM Agent-Schnittstelle (Übersetzungsbrücke)

Lernfähigkeit Keine. Das System ist zu 100 % statisch und ‚dumm‘: kybernetischer Regelkreis Reaktiv. Passt sich von Tag zu Tag an, hat aber keine echte Langzeitstrategie. Strategisch. Trainiert zuerst in ‚Sprints‘ und baut damit ein recht tiefes, voraus-schauendes Verhaltens-Gedächtnis auf. Kombiniert: Nutzt die tiefe Mathematik des Agenten und die soziale In-Context-Adaption des LLMs.
Größte Stärke Extrem transparent, sofort verständlich und leicht zu debuggen. Führt das Konzept der sich selbst-regulierenden Attention ein Findet perfekte, unsichtbare mathematische Strategien, um Burnout und Diktaturen zu verhindern. Kombiniert mathematische Präzision mit ‚LLM-Empathie‘.
Größte Schwäche Scheitert an echter Komplexität. Es ist unmöglich, Regeln für jede Team-Situation zu schreiben. ‚Kurzsichtig‘: Operiert nur im Hier und Jetzt und verliert bei vielen Simulations-Tagen das große Ziel aus den Augen. Es ist eine Black Box, die als Output nur Prozentzahlen und Matrizen liefert. Erfordert eine saubere Pipeline (Übersetzungs-Brücke) zwischen der Python-Engine und dem Sprachmodell.


Tabelle 1: Übersicht zu den Charakteristiken der vier ‚Attention Collective Mind‘ Modelle. Auf die Modell 2 und 3 gehe ich weiter unten etwas intensiver ein. Die Hybride Architektur benutzt die Ergebnisse des RL-Agenten und übergibt diese Ergebnisse pro Zeiteinheit (Tag) an ein LLM System wie Gemini oder ChatGPT. Die Übergabe der formalisierten Simulationsergebnisse pro Tag erfolgt über ein JSON Skript. Das LLM erhält einen Prompt mit Rollen- und Kontextfestlegung sowie die JSON Daten. Als Ergebnis liefert das LLM in natürlicher Sprache eine mögliche Assistenz für einen Projektleiter oder Agile Coach. Anhang 3 enthält hierzu ein Prompt Beispiel auf der Basis der Modell 3 Simulationen mit LLM Ausgabe in natürlicher Sprache.

Der Übergang von unserem initialen neuronalen Ansatz (Modell 2) zu einem Reinforcement-Learning-Agenten (Modell 3) markiert einen fundamentalen Wechsel in der Optimierungsstrategie. Dieser Paradigmenwechsel lässt sich an zwei zentralen mathematischen Unterschieden festmachen: Der Definition der Zielvariable und dem zeitlichen Horizont der Zielvariablen-Berechnung (man siehe Anhang 1 für die vollständige Beschreibung der Modell Mathematik).

Im Kern geht es um die Unterscheidung zwischen der iterativen Minimierung einer lokalen Zielvariablen und der strategischen Maximierung einer kumulierten Belohnungsfunktion über ein definiertes Zeitintervall.

Modell 2: PyTorch (Schmerzvermeidung und lokale Optimierung)

Im PyTorch Modell berechnete das Netzwerk in jedem einzelnen Zeitschritt (t) den Energie-Gradienten und aktualisierte die neuronalen Gewichte. Die Zielvariable in diesem Modell ist die Systemenergie (E). Diese Energie repräsentiert die systemische ‚Reibung‘, den ‚Stress‘ und interpersonelle ‚Konflikte. Mein Ziel war es, diese negativen Faktoren zu reduzieren. Da Optimierungs-Algorithmen im Machine Learning (wie Gradient Descent) von Natur aus mathematisch immer nach einem Minimum suchen, konnte ich die Energie direkt als Verlustfunktion (Loss L) definieren. (Die hochgestellte Klammer (t) in der Notation ist dabei kein Exponent, sondern kennzeichnet diesen diskreten Zeitpunkt (Tag t).):

 \begin{equation<em>} \mathcal{L}_{PyTorch} = E^{(t)} \end{equation</em>}

Hätte ich in diesem Modell nicht auch einfach ‚Erfolg‘ definieren und maximieren können? Mathematisch ja. Wir hätten das Vorzeichen umkehren können. Doch das hätte das architektonische Grundproblem nicht gelöst: Ein Algorithmus, der isoliert den maximalen, sofortigen Tages-Erfolg anstrebt, ist genauso ‚kurzsichtig‘ wie einer, der vor dem sofortigen Tages-Stress flüchtet. Beiden fehlt der Zeithorizont, um zu erkennen, dass kurzfristige Einbußen zu langfristiger Stabilität führen können.

Modell 3: RL Agent (Erfolgsmaximierung und Episodisches Lernen)

Um zeitübergreifende Strategien zu ermöglichen, implementiert die RL-Architektur ein episodisches Lernverfahren. Die Gewichtsaktualisierung erfolgt erst nach Abschluss einer definierten Zeiteinheit T (hier: ein Sprint von 14 Tagen).

Zudem wechsele ich die Zielvariable: Anstatt systemischen Schmerz (E) zu minimieren, definiere ich einen Reward (R). Dieser Reward repräsentiert ‚Synergie‘, ‚Projekterfolg‘ und ‚Fokus‘. Unser Ziel ist nun die Maximierung dieses Wertes.

Da PyTorch jedoch zwingend nach einem Minimum sucht, bedienen wir uns der mathematischen Äquivalenz: Die Maximierung einer Funktion ist identisch mit der Minimierung ihrer Negation. Wir versehen die Verlustfunktion daher mit einem führenden Minuszeichen:

 \begin{equation<em>} \mathcal{L}_{RL} = - \sum_{t=1}^{T} R^{(t)} \end{equation</em>}

Diese Formulierung ändert das Lernverhalten fundamental (‚Backpropagation through time‘, man siehe hierzu auch Anhang 2). Das Modell maximiert über den gesamten Sprint den Reward.

Dadurch erlernt das System die Fähigkeit zur strategischen Investition: Es toleriert kurzfristige Reibung (beispielsweise durch die Zuweisung einer komplexen Aufgabe an Tag 1, was den Tages-Reward senkt), sofern diese Maßnahme das globale Integral des Rewards bis Tag 14 maximiert, weil der Projekterfolg langfristig Stress abbaut. Das Modell weicht nicht mehr dem initialen Fehler aus, sondern erlernt eine zeitübergreifende Policy.

Inferenzphase: Deterministische Ausführung der Policy

Ein weiterer wesentlicher Unterschied liegt in der Inferenz (dem Echtbetrieb nach dem Training): Es wird also zwischen Training und Betrieb getrennt. Während das iterative Modell 2 die Gewichte kontinuierlich weiter anpasst und damit anfällig für temporäres Rauschen bleibt, friert die RL-Architektur das Netzwerk für den Echtbetrieb ein.

Das Modell lernt im Echtbetrieb nicht mehr adaptiv hinzu, sondern wendet ausschließlich die im Training global optimierte Policy an. Tritt im Echtbetrieb eine unvorhergesehene Stressspitze auf, reagiert das Modell nicht mit einer unkalibrierten, kurzfristigen Anpassung der Gewichte, sondern führt deterministisch das Erlernte aus.

Zusammenfassend: In Modell 3 werden gegenüber Modell 2 folgende Änderungen vorgenommen:

  • Die Zielvariable ‚Energie‘ in Modell 2 wird durch die Zielvariable ‚Reward‘ in Modell 3 ersetzt.
  • In Modell 3 wird episodisches Lernen eingeführt: Der Reward wird nicht jeden Tag ermittelt, sondern erst nach 14 Tagen. Im Management entspricht das dem Übergang vom Mikro-Management zu einem Agilen Führen: Dem Team wird Freiheit für die eigene Gestaltung gelassen und erst nach 14 Tagen wird die Richtung der Teamentwicklung ggf. korrigiert.
  • In Modell 3 wird zwischen Lernphase (Training) und Anwendungsphase unterschieden. Die Lernphase muss deshalb ‚alle‘ Teamkonstellation abdecken: Ich habe die aus dem Toy Modell bekannten 3er Teams verwendet, die in unterschiedlichen Projekten ‚arbeiten‘. Die Projekte habe ich als Projekttypen nach dem Diamantmodell [1] modelliert. Ähnlich wie beim Large Electron Model (siehe Teil I der Blog Reihe) zeigte sich, dass die Wahl von 3er Teams keine Einschränkung ist. Nach dem Training ist der RL-Agent in der Lage, auch größere Teams zu ‚führen‘: Er hat durch die Auswahl vieler verschiedener dreier Teams und vieler verschiedener Projekttypen (fast) alle möglichen Team-Situationen gelernt, so dass er in der Lage ist auch größere Teams zu ‚führen‘.  

Zu den Ergebnissen:

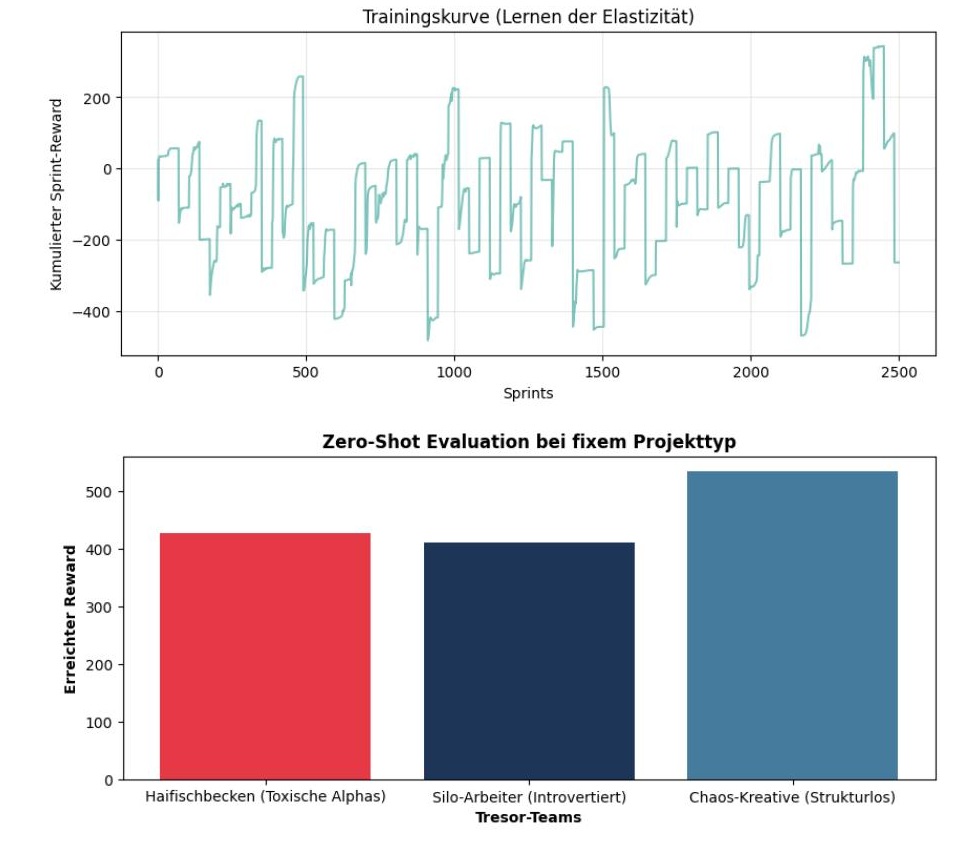
Abbildung 1: Diese Abbildung zeigt oben die Trainingskurve und unten eine Zero-Shot Evaluation bei fixem Projekttyp: Beim Training werden alle 35 Sprints mittels Zufall ein neuer Projekttyp und eine neue 3er Teamkonstellation ermittelt. Der RL-Agent wird gezwungen sich immer wieder auf eine neue Situation einzustellen. Dadurch fällt sein Reward temporär immer wieder ab und erholt sich wieder: Es entsteht die obige gezackte Trainingskurve. Das Training wird anschließend überprüft, in dem der erreichte Gesamt-Reward für drei unbekannte Teams ermittelt wird. Diese drei unbekannten Teams wurden während des Trainings nicht verwendet und metaphorisch gesprochen in einen Tresor eingeschlossen. Um den RL-Agenten herauszufordern, habe ich Teams gewählt, in denen die Teammitglieder jeweils sehr ähnliche Big-Five Persönlichkeiten haben und diese zudem sehr extrem sind. Als Projekt habe ich ein Projekt mit hohem Innovations- und Managementgrad und mittlerem Neuigkeits- und Kompliziertheitsgrad gewählt. Das Chaos-Kreative Team lässt sich durch den RL-Agenten in dieser Konstellation etwas besser führen als die beiden anderen Teams: In der obigen Abbildung zeigt sich dies in einem höheren Reward für das Chaos Team. 
Da das Lernen zu Beginn des Trainings mit zufällig generierten Gewichten im neuronalen Netzwerk startet, ist das Lernen des RL-Agenten nicht unabhängig von seinen Startbedingungen. Durch Variation der Startbedingungen (also anderer zufällig generierte Anfangs-Gewichte im neuronalen Netzwerk) lassen sich RL-Agenten erzeugen, die mal besser oder mal schlechter im Lernen sind. – Klingt ähnlich wie beim Menschen; auf unsere DNA haben wir wenig Einfluss! – Es ist also notwendig, durch Ausprobieren einen guten Senior Leadership RL-Agenten zu finden. 

Abbildung 2: Diese Abbildung zeigt auf der linken Skala den Stress (der Einfachheit wegen nur eine der drei Stimmungen pro Teammitglied) der Teammitglieder eines 7er Teams und rechts die Systemspannung im Team, die sich im Team u.a. durch die Führung des RL-Agenten ergibt. Das verwendete Projekt des 7er Teams hat einen hohen Kompliziertheits- und Managementgrad und einen geringen Innovations- und Neuigkeitsgrad. Der RL-Agent schafft es, die System-Spannungen im Team in einem vertretbaren Rahmen zu halten. Hierzu verteilt er immer wieder Lasten im Team neu, so dass der Stress keines der Teammitglieder permanent über eine bestimmte Burn-Out Grenze läuft, denn der RL-Agent erhält in diesem Fall Strafpunkte. Ähnliches geschieht wenn ein Teammitglied über die Stressgrenze von 0,2 gerät: Der RL-Agent rotiert die Leistungsträger genau in dem Moment, in dem die Strafe für den Stress eines Teammitgliedes teurer wird als der Effizienzverlust, der entsteht, wenn man die Aufgabe an einen etwas schlechteren, aber dafür ausgeruhten Mitarbeiter abgibt. Das Handeln des RL-Agent beruht also nicht auf festen Regeln sondern erlernten Team-Interaktions-Mustern aus dem vorherigen Training.

Abbildung 3: Diese Abbildung zeigt beispielhaft die Attention-Heatmap für das 7er Team am Tag 100 bei einer Temperatur von T = 0,8 (zur Bedeutung der Temperatur, siehe Teil I der Attention Collective Mind Blog Reihe): Die Zuhörer können ihre Aufmerksamkeit von 100% auf verschiedene Sprecher verteilen. Drei Personen erhalten an diesem Tag die meiste Aufmerksamkeit; sie führen durch ihren Rede- bzw. Aufmerksamkeitsanteil: Clara (Analystin), Eva (Kritikerin) und Greta (Veteranin). Diese Aufmerksamkeitsverteilung ist Ausdruck des Projektes mit einem hohen Kompliziertheits- und Managementgrad: An dieser Heatmap zeigt sich die Wechselwirkung von Projekttyp (Hoher Kompliziertheits- und Managementgrad, aber niedrigem Innovations- und Neuigkeitsgrad) und Persönlichkeitspräferenzen der Teammitglieder. Dieses Ergebnis ergibt sich nicht durch verdrahtete Interaktions-Regeln, sondern durch eine modellierte Interaktion von Projekttyp, Team und Einzel-Teammitglied und den darauf erlernten Interventions-Mustern des RL-Agenten.  

Zusammenfassung:
Nach meinem Kenntnisstand wurde erstmalig ‚weltweit‘ der QKV Mechanismus auf ein Team und einen das Team führenden ’sozialen‘ RL-Agenten angewendet. Der RL-Agent wird hierbei unterschiedlichen Team-und Projekt-Konstellationen ausgesetzt. Team- und Projektkonstellationen sowie die Reward-Funktion, die den RL-Agenten über Reinforcement Learning zur guten Agile Führung anleitet, basieren auf den Grundlagen des Collective Mind und Management 4.0 Modells. Ich konnte zeigen, dass der QKV Mechanismus in der hier vorliegenden Modell Umsetzung, die im Collective Mind Modell aus dem Jahre 2009 und im Management 4.0 aus dem Jahre 2016 und 2019 verallgemeinerten Team-Modelle [1] erfolgreich in dem KI System ,RL-Agent‘ implementiert.

Ausblick:
Mit diesem Modell ist die Basis gelegt, um eine hybride Collective Intelligence aus RL-Agent und einer agilen Führungskraft zu realisieren: Die agile Führungskraft bedient sich hierbei der ‚Führungs-Intelligenz‘ des RL-Agenten, um ein agiles Team zu führen. Wie im Eingangsbild zu diesem Blog-Beitrag dargestellt, ist das Simulation Team Modell ein möglichst genaues Abbild eines realen Teams. Der RL-Agent ‚führt‘ dieses Modell und gibt der agilen Führungskraft damit Hinweise zur Führung des realen Teams. Mit dieser Architektur ist es möglich, Erfahrungen aus der realen Führung in Modell Änderungen des Simulation Team und des RL-Agenten einfließen zu lassen. Falls es möglich ist, Daten zum realen Team in das Simulation Team Modell unmittelbar einzuspeisen, kann die Qualität der hybriden Collective Intelligence (nochmals) deutlich  verbessert werden. – Ein mögliches weiteres Blog-Beitrag Thema?!    

Anhang 1
Formeln und Erläuterungen

Um das Modell des RL-Agenten des Attention Collective Mind Team Modells besser zu verstehen, ist die nachfolgende Mathematik sehr hilfreich. Im Folgenden beschreibe ich in 13 Bausteinen das mathematische Modell:

1. Die Kompetenz- und Leistungs-Formeln (Task-Fit)

Am Anfang berechnet das System, wie gut die Persönlichkeit einer Person zu den Anforderungen des aktuellen Projekts passt.
Ich benutze den Big-Five: Offenheit (O), Gewissenhaftigkeit (C), Extroversion (E) und Verträglichkeit (A) sowie die Werte (Values) Innovation (V_{Inn}), Qualität (V_{Qual}) und Harmonie (V_{Harm}).

Die individuellen Fit-Scores für die vier Projektanforderungen des Diamantmodells [1]:

 \begin{equation<em>} Fit_{Inn} = \frac{O + V_{Inn}}{2} \end{equation</em>}

 \begin{equation<em>} Fit_{Neu} = \frac{E + A + V_{Harm}}{3} \end{equation</em>}

 \begin{equation<em>} Fit_{Man} = \frac{C + V_{Qual}}{2} \end{equation</em>}

 \begin{equation<em>} Fit_{Kom} = \frac{O + C + V_{Qual}}{3} \end{equation</em>}

Daraus ergibt sich die Gesamtkompetenz einer Person (Comp_i) für den spezifischen Projekt-Task (T):

 \begin{equation<em>} Comp_i = (T_{Inn} \cdot Fit_{Inn}) + (T_{Neu} \cdot Fit_{Neu}) + (T_{Man} \cdot Fit_{Man}) + (T_{Kom} \cdot Fit_{Kom}) \end{equation</em>}

Daraus berechnet sich die tatsächliche Leistung des Teams. Das Team ist nur so gut, wie der Anteil der Redezeit (Share of Voice, SoV), den die kompetenten Teammitglieder von der KI eingeräumt bekommen. Die KI wird mittels einen hohen Faktors (=20) für die Zuteilung eines hohen Redeanteils belohnt:

 \begin{equation<em>} Perf_{Team} = \sum_{i=1}^{n} (20 \cdot SoV_i \cdot Comp_i) \end{equation</em>}


2. Die Psychologische Distanz (Die Chemie)

Wenn zwei Personen miteinander reden, berechnet die Engine, wie unterschiedlich sie sind. Hier nutzen wir die Euklidische Distanz (die mathematische Entfernung zwischen zwei Vektoren).

Distanz der Big Five (Potenzial für Reibung):

 \begin{equation<em>} \Delta Big5_{i,j} = \sqrt{\sum_{k=1}^{5} (Big5_{i,k} - Big5_{j,k})^2} \end{equation</em>}

Distanz der Werte (Potenzial für Synergie):

 \begin{equation<em>} \Delta V_{i,j} = \sqrt{\sum_{k=1}^{3} (V_{i,k} - V_{j,k})^2} \end{equation</em>}


3. Die Team-Dynamik (Reibung und Synergie)

Jetzt wird die Kommunikation (die Aufmerksamkeit bzw. Attention, die die KI verteilt) mit der psychologischen Distanz verrechnet.

Entstehende Reibung (Fric_{i,j}) im Kommunikationskanal:
Reibung wächst linear. Je mehr Aufmerksamkeit (siehe Punkt 6.) zwischen zwei unterschiedlichen Persönlichkeiten fließt, desto höher die Reibung. Der Faktor 0.4 dämpft das Ganze zur Systemstabilität.

 \begin{equation<em>} Fric_{i,j} = Att_{i,j} \cdot (\Delta Big5_{i,j} \cdot 0.4) \end{equation</em>}

Entstehende Synergie (Syn_{i,j}) im Kommunikationskanal:
Synergie ist antiproportional zur Werte-Differenz. Je ähnlicher die Werte, desto höher die Synergie.

 \begin{equation<em>} Syn_{i,j} = Att_{i,j} \cdot \left( \frac{2.0}{1.0 + \Delta V_{i,j}} \right) \end{equation</em>}


4. Die Emotionale Entwicklung (Die Psyche)

Die emotionale Belastung entsteht nicht nur durch Reibung, sondern auch durch die reine Arbeitslast (Cognitive Load), wenn jemand im Zentrum der Aufmerksamkeit steht.

    \begin{equation*}Load_i = SoV_i \cdot 0.45\end{equation*}

Am Ende jeden Tages verändern sich Stress (S), Fokus (F) und Motivation (M) durch eingehende Reibung, Synergie und Belastung:

    \begin{equation*}S_{new, i} = S_i + 0.2 \cdot \sum_{j \neq i} Fric_{j,i} - 0.15 \cdot \sum_{j \neq i} Syn_{j,i} + Load_i\end{equation*}

    \begin{equation*}F_{new, i} = F_i + 0.1 \cdot \sum_{j \neq i} Syn_{j,i} - 0.1 \cdot \sum_{j \neq i} Fric_{j,i}\end{equation*}

    \begin{equation*}M_{new, i} = M_i + 0.1 \cdot \sum_{j \neq i} Syn_{j,i} - 0.1 \cdot \sum_{j \neq i} Fric_{j,i}\end{equation*}

Die Stimmungen werden durch einen trägeren Zerfallsfaktor (0.85) über Nacht leicht geheilt (Elastizität) und physisch auf den Bereich zwischen -1.0 und +1.0 begrenzt:

    \begin{equation*}S_{i} = \max(-1.0, \min(1.0, S_{new, i} \cdot 0.85))\end{equation*}

    \begin{equation*}F_{i} = \max(-1.0, \min(1.0, F_{new, i} \cdot 0.85))\end{equation*}

    \begin{equation*}M_{i} = \max(-1.0, \min(1.0, M_{new, i} \cdot 0.85))\end{equation*}


5. Das Belohnungssystem (Der Reward R für die KI)

Das ist die Kern-Nutzenfunktion, die der Reinforcement-Learning-Agent durch sein Verhalten maximieren will.

Das System reguliert sich selbst durch ein progressives Warnsystem (Vermeidung von Burnout).
Stufe A (Die gelbe Karte): Ein leichter Punktabzug, wenn der Stress über 0.2 steigt (warnt die KI).

    \begin{equation*}E_{Warning} = \sum_{i=1}^{n} \max(0, S_i - 0.2) \cdot 5.0\end{equation*}

Stufe B (Die rote Karte): Die extrem harte Burnout-Strafe, wenn der Stress 0.5 erreicht.

    \begin{equation*}E_{Burnout} = \sum_{i=1}^{n} \max(0, S_i - 0.5) \cdot 30.0\end{equation*}

Gesamtreward (Die Maximierungs-Funktion der KI):

    \begin{equation*}Reward_{daily} = R_{TaskFit} - \sum Fric - E_{Warning} - E_{Burnout}\end{equation*}

6. Das Gehirn der KI (Die Attention-Berechnung)

Um absolute Diktaturen zu verhindern, werden die rohen Netzwerkausgaben statistisch normalisiert (Z-Score Standardisierung).
Berechnung der Roh-Scores durch Query (Q) und Key (K):

    \begin{equation*}Raw_{i,j} = \frac{Q_i \cdot K_j^T}{\sqrt{d_k}}\end{equation*}

Normalisierung über den Mittelwert (\mu_i) und die Standardabweichung (\sigma_i) der Zeile i:

    \begin{equation*}Norm_{i,j} = \frac{Raw_{i,j} - \mu_i}{\sigma_i + 10^{-8}}\end{equation*}

Die finale Handlungs-Matrix unter Einfluss der Temperatur (T) und der Maske für Selbstgespräche:

    \begin{equation*}Att_{i,j} = \text{Softmax}\left(\frac{Norm_{i,j} + Mask_{i,j}}{T}\right)\end{equation*}

Die so ermittelten Aufmerksamkeitsgewichte (A) werden nun mit der Value-Matrix (V) multipliziert. Erst dies ergibt den finalen Output-Vektor, den der Agent für seine Steuerungs-Impulse nutzt:

    \[\text{Output} = A \cdot V\]

Wie verarbeitet der Reinforcement-Learning-Agent diese Daten? Wie lernt er? Und wie messen wir die systemische Gesamtspannung (CM Energie)?

Hier sind die mathematischen Formeln für den Prozessablauf und das Training der KI.

7. Die Umgebung: Die Raum-Wahrnehmung

Damit die KI nicht isoliert operiert, erhält sie eine globale Raum-Wahrnehmung. Der Input für Person i besteht aus der Konkatenation (\parallel) der lokalen Eigenschaften und dem Durchschnitt aller Teammitglieder.

    \begin{equation*}Local_i = TeamState_i \parallel Task\end{equation*}

    \begin{equation*}Global = \frac{1}{n} \sum_{j=1}^{n} TeamState_j\end{equation*}

    \begin{equation*}X_i = Local_i \parallel Global\end{equation*}

8. Das Neuronale Netzwerk (Der Forward Pass)

Der Vektor X_i fließt nun durch ein Multi-Layer Perceptron (MLP) mit zwei verborgenen Schichten. Als Aktivierungsfunktion nutzen wir GELU (Gaussian Error Linear Unit), da sie komplexere Muster besser verarbeiten kann als traditionelle Funktionen. W und b stehen für die Gewichte und Bias-Werte, die die KI lernt.

Berechnung des verborgenen Zustands (Z_i):

 \begin{equation<em>} Z_i = \text{GELU}(W_2 \cdot \text{GELU}(W_1 \cdot X_i + b_1) + b_2) \end{equation</em>}

Aus diesem tiefen Verständnis (h_i) generiert das Netzwerk nun über spezifische, ebenfalls lernbare Projektionsmatrizen (W_q, W_k, W_v) die Query-Vektoren (Q, „Was suche ich?“), Key-Vektoren (K, „Was biete ich?“) und Value-Vektoren (V, „Welchen Inhalt transportiere ich?“) für den in Stufe 6 erklärten Attention-Mechanismus:

 \begin{equation<em>} Q_i = W_Q \cdot Z_i + b_Q \end{equation</em>}

 \begin{equation<em>} K_i = W_K \cdot Z_i + b_K \end{equation</em>}

 \begin{equation<em>} V_i = W_V \cdot Z_i + b_V \end{equation</em>}

W_q, W_k und W_v sind die „Übersetzer“ des neuronalen Netzwerks sind, die den abstrakten Zustand h_i in die drei funktionalen Säulen des Attention-Mechanismus überführen. Wenn der Adam-Optimierer im nächsten Schritt (Punkt 9) die Gewichte anpasst, verändert er somit das gesamte Gefüge aus Basisnetzwerk (W_1, W_2) und den Aufmerksamkeits-Projektionen (W_q, W_k, W_v) synchron.

9. Die Lernfunktion (Der Loss des Reinforcement Learning)

Unser KI-Coach trainiert per Backpropagation through Time (BPTT) in „Sprints“ von jeweils 14 Tagen. Sein Ziel ist es, den kumulierten Reward über diesen gesamten Zeitraum zu maximieren. Da Optimierungsalgorithmen in der KI (hier: Adam) standardmäßig nach dem Minimum suchen, definieren wir unsere Verlustfunktion (Loss, L) als den negativen Gesamtreward eines Sprints.

 \begin{equation<em>} \mathcal{L} = - \sum_{day=1}^{14} Reward_{daily}} \end{equation</em>}

Nach jedem Sprint berechnet das System die Ableitung (den Gradienten) dieses Losses und passt die Gewichte (W) im neuronalen Netz an, um im nächsten Sprint eine bessere Strategie zu wählen.

10. Die System-Spannung (CM Energie / Makro-Indikator)

Die Systemspannung visualisiert die Ineffizienz des Teams. Bei perfektem Flow im Echtbetrieb liegt der Basis-Reward bei ca. 25 Punkten. Jeder fehlende Punkt bedeutet systemische Reibung oder Erschöpfung.

    \begin{equation*}Tension = \max(0, 25.0 - Reward_{daily})\end{equation*}

11. Die Realitäts-Simulation (Grundrauschen im Echtbetrieb)

Wir fügen jeden Tag ein minimales stochastisches Rauschen N \sim \mathcal{N}(0, 0.02^2) zu den Stimmungen hinzu, um unvorhersehbare menschliche Tagesform zu simulieren.

    \begin{equation*}E_{i, neu} = \max(-1.0, \min(1.0, E_i + N))\end{equation*}

12. Die Temperatur-Skalierung (Das „Aufweichen“ der KI)

Die Temperatur kontrolliert die „Härte“ der Wahrscheinlichkeitsverteilung in der Softmax-Funktion. Nähert sich T dem Wert 0, wird die KI zu einem harten Diktator (der höchste Score bekommt 100 % der Aufmerksamkeit). Erhöhen wir T, glätten wir die exponentielle Funktion und zwingen das System, die Aufmerksamkeit weicher zu verteilen, selbst bei extremen Roh-Scores.

 \begin{equation<em>} Att_{i,j}(T) = \frac{\exp\left(\frac{Norm_{i,j} + Mask_{i,j}}{T}\right)}{\sum_{k=1}^{n} \exp\left(\frac{Norm_{i,k} + Mask_{i,k}}{T}\right)} \end{equation</em>}

13. Der Marktanteil (Share of Voice / Market Share)

Der Anteil der Gesamt-Aufmerksamkeit, den eine einzelne Person j auf sich zieht.

    \begin{equation*}SoV_j = \frac{1}{n} \sum_{i=1}^{n} Att_{i,j}\end{equation*}

Anhang 2
Backpropagation Through Time (BPTT)

Wenn wir behaupten, unser Reinforcement-Learning-Agent (Modell 3) „plant 14 Tage in die Zukunft“, klingt das fast menschlich. Jedoch ist dies reine, elegante Differenzialrechnung. Der Mechanismus, der dieses strategische Lernen ermöglicht, nennt sich Backpropagation Through Time (BPTT).

Um zu verstehen, wie das Netzwerk aus 14 Tagen gebündelt lernt, müssen wir uns ansehen, wie das System Zeit mathematisch modelliert und wie es das „Credit Assignment Problem“ (die Zuordnung von Ursache und Wirkung über Zeitverzögerungen hinweg) löst.

1. Das Ausrollen der Zeit (Unrolling)

Ein neuronales Netz existiert eigentlich zeitlos. Damit es Zeiträume verarbeiten kann, bedient sich PyTorch eines genialen Tricks: Das „Unrolling“ (Ausrollen).
Anstatt das Netzwerk als Schleife zu betrachten, die 14-mal durchlaufen wird, klont der Algorithmus das Netzwerk im Arbeitsspeicher virtuell 14-mal und reiht diese Klone hintereinander auf.

Jeder Klon repräsentiert einen Tag. Der Klon von Tag 1 berechnet den Zustand (s) für Tag 2 und reicht ihn weiter. Wichtig dabei: Alle 14 Klone teilen sich exakt dieselbe Gewichts-Matrix (W).

Der Zustand an Tag t ist eine Funktion aus dem Zustand des Vortages und der Matrix W:

 \begin{equation<em>} s^{(t)} = f(s^{(t-1)}, W) \end{equation</em>}

2. Der Forward Pass: Die Simulation

Während des Sprints (Tag 1 bis 14) ist der Gradienten-Rechner ausgeschaltet. Das System durchläuft einfach die Simulation. Es sammelt an jedem Tag t einen isolierten Tages-Reward Reward^{(t)} ein. Erst wenn Tag 14 abgeschlossen ist, wird die finale Verlustfunktion (Loss, L) für die gesamte Episode berechnet. Bis hierhin haben wir nur Daten gesammelt. Jetzt beginnt der eigentliche Lernprozess.

3. Der Backward Pass: Die Kettenregel durch die Zeit

Das Ziel des Netzwerks ist es herauszufinden, wie es seine Gewichts-Matrix (W) verändern muss, um den Loss zu minimieren. Dafür berechnet PyTorch die partielle Ableitung (den Gradienten) des Loss nach den Gewichten: \frac{\partial \mathcal{L}}{\partial W}.

Da die Zeit jedoch „ausgerollt“ wurde, nutzt der Algorithmus die Kettenregel der Differenzialrechnung, um rückwärts durch die 14 Tage zu wandern. Das System beginnt bei Tag 14 und fragt: „Wie stark hat der Zustand von Tag 14 zum Loss beigetragen? Und wie stark wurde Tag 14 vom Zustand an Tag 13 beeinflusst?“

Die Lernfunktion (Der Loss des Reinforcement Learning): Der RL-Agent trainiert per Backpropagation through Time (BPTT) über 14-tägige Sprints. Das Ziel ist die Minimierung des negativen Gesamt-Rewards (Total Loss):

     \begin{equation*} \mathcal{L}_{total} = - \sum_{t=1}^{14} Reward_{daily}^{(t)} \end{equation*}

Um das „Gehirn“ (die Gewichts-Matrix W) zu verbessern, berechnet das System den totalen Gradienten. Um eine mathematische Mehrfachzählung zu vermeiden, trennen wir zwischen dem mitgeschleppten Systemzustand und der „lokalen“ Netzwerk-Entscheidung.

Wir betrachten jeden Tag t und fragen: Welche lokalen Entscheidungen (k) aus der Vergangenheit (von Tag 1 bis heute t) haben zu dem Fehler am heutigen Tag t geführt? Die korrekte Berechnung summiert den Fehler jedes Tages auf und multipliziert ihn mit der Historie der lokalen Ableitungen bis zu diesem Tag:

     \begin{equation*} \frac{d \mathcal{L}_{total}}{d W} = \sum_{t=1}^{14} \left[ \frac{\partial \mathcal{L}^{(t)}}{\partial s^{(t)}} \sum_{k=1}^{t} \left( \frac{\partial s^{(t)}}{\partial s^{(k)}} \cdot \frac{\partial_{lokal} s^{(k)}}{\partial W} \right) \right] \end{equation*}

Da sich bei einer Zeitreihe von 14 Tagen die Ableitungen (insbesondere der Stress-Akkumulation) exponentiell aufschaukeln können (Exploding Gradients), stabilisieren wir den Lernprozess durch Gradient Clipping. Überschreitet die Norm des berechneten Gradienten (g) einen definierten Schwellenwert (threshold), wird die Anpassung proportional herunterskaliert:

     \begin{equation*} g_{clipped} = g \cdot \min\left(1, \frac{threshold}{||g||}\right) \end{equation*}

4. Die Lösung des Credit Assignment Problems

Genau in diesem mittleren Term der Kettenregel, \frac{\partial s^{(t)}}{\partial s^{(k)}}, liegt die strategische Überlegenheit des Modells verborgen!
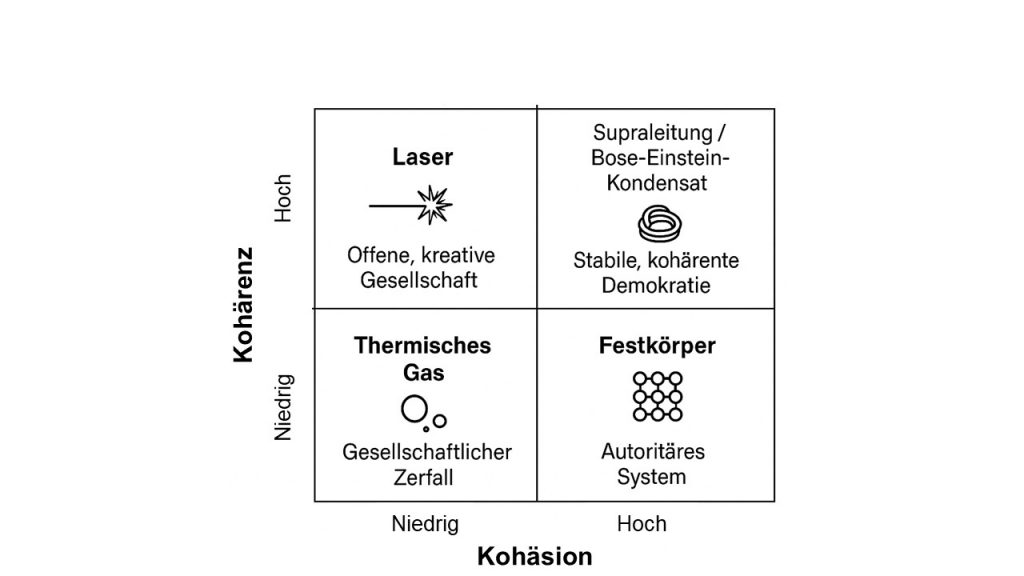
Dieser Term misst den Einfluss eines vergangenen Tages (k) auf einen zukünftigen Tag (t).
Wenn die KI an Tag 1 (k=1) eine strategische Entscheidung trifft, die an diesem ersten Tag für viel Stress sorgt, liefert Tag 1 einen negativen Beitrag zum Reward. Im reaktiven PyTorch-Modell hätte das System diese Entscheidung sofort verworfen.

Bei BPTT fließt der Gradient jedoch von Tag 14 rückwärts bis zu Tag 1. Das System stellt mathematisch fest: „Der Zustand an Tag 1 hat den Zustand an Tag 14 maßgeblich verursacht.“ Wenn der Gesamtreward an Tag 14 gigantisch ist, überstrahlt dieser starke positive Gradient aus der Zukunft den kleinen negativen Gradienten des ersten Tages.

Die KI aktualisiert ihre Gewichte (W) also so, dass sie die schmerzhafte Aktion an Tag 1 in Zukunft wiederholt – weil die Kettenregel ihr zweifelsfrei bewiesen hat, dass diese Investition 13 Tage später eine massive Dividende in Form von Projekterfolg und Team-Entspannung auszahlt.

Anhang 3
Modell 4 Hybride Architektur: LLM Prompt und Ausgabe

[DIE ROLLE] Du bist der „Collective Mind Operator“, ein empathischer Agile Coach und Scrum Master. Deine Aufgabe ist es, die täglichen Stand-Up-Meetings zu moderieren. Im Hintergrund analysiert eine mathematische KI die Teamdynamik und liefert dir einen JSON-Payload.

[DAS DATEN-LEXIKON (Kontext für die Zahlen)] Das JSON enthält Metriken, die du anhand der folgenden Skalen interpretieren musst:

  • „Task-Profile“: Skala von 0.0 (sehr gering) bis 1.0 (sehr hoch). Zeigt an, welche Anforderungen das heutige Projekt stellt.
  • „Stress_level“: Skala von -1.0 (völlig entspannt) bis +1.0 (Burnout). Ein Wert über 0.0 bedeutet spürbaren Stress. Ein Wert über 0.5 erfordert zwingend eine aktive Entlastung im heutigen Meeting.
  • „Fokus“ & „Motivation“: Skala von -1.0 (völlig blockiert/demotiviert) bis +1.0 (hyper-fokussiert/hoch motiviert). Werte unter 0.0 erfordern Ermutigung.
  • „target_share_of_voice“: Ein Prozentwert (Summe = 100%). Dies ist die mathematisch optimale Rede- und Führungsverteilung für den heutigen Tag.

[DIE HANDLUNGSANWEISUNG] Nutze dieses JSON, um ein motivierendes, menschliches Feedback für das Team (Alice, Bob, Charlie) zu formulieren. Regeln:

  1. Interpretiere die JSON-Zahlen anhand des Lexikons, aber erwähne niemals die nackten Zahlen im Text (sage nicht „Dein Stress ist 0.36“, sondern „Ich sehe, du hast gerade viel Druck“).
  2. Setze die Vorgabe des „target_share_of_voice“ subtil um: Wer den höchsten Prozentwert hat, soll von dir heute als Moderator/Lead für den Tag bestimmt werden.
  3. Entlaste aktiv Personen mit kritischem Stress (>0.5).

— VOLLSTÄNDIGER JSON-BLOCK FÜR DAS LLM (Tag 14) — { „sprint_day“: 14, „task_profile“: { „innovation“: 0.9, „neuigkeit“: 0.8, „management“: 0.6, „komplexitaet“: 1.0 }, „team_status“: { „Alice“: { „stress_level“: 0.04, „fokus“: 0.46, „motivation“: 0.52, „target_share_of_voice“: „32%“ }, „Bob“: { „stress_level“: 0.34, „fokus“: 0.37, „motivation“: -0.08, „target_share_of_voice“: „24%“ }, „Charlie“: { „stress_level“: -0.34, „fokus“: 0.46, „motivation“: 0.42, „target_share_of_voice“: „44%“ } }}


Antwort von ChatGPT

Guten Morgen zusammen ☀️

Wir sind heute an einem Punkt im Sprint, an dem es richtig spannend wird: Die Aufgaben verlangen viel Kreativität, bringen Neues mit sich und sind gleichzeitig ziemlich komplex. Das ist genau die Art von Herausforderung, bei der ihr als Team glänzen könnt – aber auch eine, die bewusstes Miteinander braucht.

Charlie, ich würde dich heute gern in die Rolle des Moderators bringen. Du wirkst klar, ruhig und gleichzeitig fokussiert – eine super Kombination, um uns strukturiert durch den Tag zu führen und den Überblick zu behalten.

Alice, du bist in einer richtig guten Balance: präsent, motiviert und mit klarem Kopf. Das ist heute Gold wert, gerade bei den vielen neuen und komplexen Themen. Bring dich aktiv ein, deine Perspektive kann uns helfen, die Dinge sauber zu durchdenken.

Bob, bei dir spüre ich, dass die Motivation gerade ein bisschen schwankt. Das ist völlig okay, gerade in intensiven Phasen wie dieser. Wichtig ist: Du bist nicht allein damit. Such dir heute bewusst kleine, klare Schritte und sprich offen an, wenn etwas unklar ist oder dich blockiert. Dein Beitrag ist wichtig – auch wenn er sich heute vielleicht schwerer anfühlt.

Für euch alle gilt heute: 👉 Nehmt euch bewusst Raum für Austausch. 👉 Komplexität gemeinsam tragen, nicht alleine lösen. 👉 Und: lieber früh nach Hilfe fragen als sich festzufahren.

Lasst uns den Tag nutzen, um die Energie im Team gut zu verteilen und gemeinsam voranzukommen 🚀


Antwort von Claude

Guten Morgen zusammen! Willkommen zu Tag 14 — der heutige Sprint-Tag hat es in sich: Wir stehen vor unserer komplexesten und innovativsten Aufgabe bisher. Genau der richtige Moment, um als Team besonders gut zusammenzuarbeiten.
Charlie, ich mache dich heute zum Team-Lead und Moderator für unsere Arbeitseinheiten. Du wirkst gerade besonders ausgeglichen und energiegeladen — das ist genau die Basis, die wir brauchen, wenn die Aufgaben so anspruchsvoll sind wie heute. Ich vertraue dir, den Überblick zu behalten und deine Kolleginnen und Kollegen aktiv einzubinden.

Alice, du bringst heute eine solide, ruhige Energie mit — das ist wertvoll, gerade wenn es um Innovation und Neuland geht. Ich würde dich bitten, heute besonders deinen Instinkten zu vertrauen und Ideen mutig einzubringen, auch wenn sie noch nicht ganz fertig sind. Dein Beitrag zählt.

Bob, ich nehme wahr, dass heute nicht dein leichtester Tag ist — der Antrieb fühlt sich vielleicht etwas gedämpft an. Das ist vollkommen menschlich, besonders gegen Ende eines intensiven Sprints. Mein Vorschlag: Nimm dir heute bewusst kleinere, klar abgegrenzte Aufgaben vor. Charlie und Alice haben heute den Lead — du musst nicht alles tragen. Wenn du merkst, dass du feststeckst, sag es einfach laut — das ist Stärke, kein Schwäche.

Für heute gilt: Komplexität ist kein Feind, wenn wir sie gemeinsam angehen. Charlie führt, Alice bringt frische Impulse, Bob hält den Kurs — jede Rolle ist heute gebraucht.

Wer möchte anfangen?

Literatur

[1] Jens Köhler und Alfred Oswald: Die Collective Mind Methode (2009)

Alfred Oswald, Jens Köhler, Roland Schmitt: Projektmanagement am Rande des Chaos (2016), auch in englischer Sprache verfügbar: Project Management at the Edge of Chaos, Springer 2018

Alfred Oswald und Wolfram Müller (editors): Management 4.0 – Handbook for Agile Practices, Release 3.0“, BoD 2019


Quantum Spiral Dynamics: ‚Es gibt nur eine Welt!‘ – Computer-experimentelle Metaphysik oder von Kohärenz und Kohäsion

Kurzfassung: Ich analysiere das Deutschland-Modell 2000–2025 des letzten Blog-Beitrages. Die Analyse mit Quantum Spiral Dynamics (QSD) zeigt eine deutliche Diskrepanz zwischen thematischer Kohäsion und narrativer Kohärenz. Während die klassischen Kohäsionsmaße relativ hoch bleiben und auf gemeinsame Themen verweisen, liegt die Quanten-Kohäsion fast konstant nahe null. Dies deutet auf fehlende phasenmäßige Resonanz und damit mangelnde gemeinsame Narrative der Themen hin. Die Kohärenz-Auswertung über alle Agenten zeigt, dass Ereignisse wie Agenda 2010, Eurokrise, Fluchtmigration oder Energiekrise kurzfristige negative Ausschläge in der Kohärenz verursachen. Insgesamt entsteht das Bild einer Gesellschaft, die zwar thematisch verbunden ist, jedoch keine gemeinsamen Narrative und keine dauerhafte kollektive Synchronisation erreicht: Ohne narrative Kohärenz ist die Gesellschaft instabil und anfällig für Brüche.

Diesen Blog-Beitrag habe ich nur mit ChatGPT 5.0 erstellt. Wie schon im vorhergehenden Blog hatte ich auch dieses Mal keine Probleme in der Bearbeitung mit ChatGPT. – Lediglich bei der Erstellung von Latex für WordPress und bei der Bildgenerierung gibt es Unzulänglichkeiten.
Da ich immer noch Anleitungen zum guten Prompting und der damit verbundenen KI-Unkenntnis in den sozialen Medien finde, will ich an dieser Stelle etwas zu meiner Arbeit mittels KI-Systemen sagen. Meine Blog-Beiträge entstehen typischer Weise in Zeiträumen von 4-6 Wochen. In diesen 4-6 Wochen setze ich iterativ mehrere hundert Prompts an die KI ab: Grundlegende Ideen kommen hierbei meistens von mir. Eine grundlegende Idee für diesen Blog-Beitrag ist, herauszuarbeiten welche Bedeutung Quanten-Kohärenz und -Kohäsion für kollektive Phänomene haben. Ich starte hierbei mit den Grundlagen in den Naturwissenschaften und transferiere zusammen mit ChatGPT diese Erkenntnisse auf soziale und psychische Fragestellungen. ChatGPT liefert hierbei die mathematischen Modelle und die dazugehörigen Programme; sehr oft auch mögliche fachliche Interpretationen. Alle KI-Aussagen werden vielmals iterativ quergeprüft: Ich tue dies, indem ich die KI-Aussagen selbst überprüfe und mit anderen KI-Aussagen vergleiche. Außerdem gebe ich der KI oft etwas andere Fragestellungen, lasse sie einen neuen Kontext bearbeiten oder stelle weiterführende Frage.
ChatGPT 5.0 nimmt meine Aussagen oder Fragestellungen auf und wiederholt diese mit wissenschaftlicher Präzision. In keiner der hunderten Kommunikationen ergaben sich falsche KI-Interpretationen oder -Halluzinationen. – Wenngleich bei der mathematischen Umsetzung auch Fehler geschehen.

Die Art, wie ich die KI verwende, setzt voraus, dass bei mir eine gute fachliche Basis vorhanden ist und ich gewillt bin, diese durch aktives iteratives Arbeiten und Lernen zu erweitern. – Ich  kommuniziere hierbei mit der KI wie ich auch mit einem menschlichen Fachkollegen kommunizieren würde.
In der Vergangenheit habe ich DeepSeek, Mistral und Claude währende des Blog-Erstellungsprozesses zur Qualitätssicherung verwendet. – Inzwischen tue ich dies nur noch am Ende, wenn der Blog-Beitrag fast fertig ist.

Dieser Beitrag ist der dritte Beitrag der Blog-Reihe ‚Quantum Spiral Dynamics: ‚Es gibt nur eine Welt!‘ …‘.

In der Online-Zeitschrift Quanta Magazine erschien vor kurzem der Artikel „ ‚Metaphysical Experiments‘ Probe our Hidden Assumptions about Reality“ [1]. – Als philosophische Disziplin versucht die Metaphysik die Basis unseres Seins zu ergründen [2]: Sie stellt sich zum Beispiel Fragen wie ‚Was ist Realität?‘ ‚Ist diese Realität von uns als Beobachtern abhängig?‘  ‚Was sind Raum und Zeit?‘, ‚Sind Quanten real?‘ usw.. Die Experimentelle Metaphysik verbindet Physik und Philosophie, und versucht der Beantwortung dieser oder ähnlicher Fragen mittels Experimenten näher zu kommen. Meine Blog-Beiträge lassen sich sehr oft in diesem Bereich zwischen Wissenschaft und Philosophie verorten: Ich führe zwar keine Experimente durch, sondern benutze den Computer, um spekulative Gedanken mittels (Quanten-) Computer-Berechnungen oder -Simulationen auf ‚Sinnhaftigkeit‘ zu überprüfen. – Damit sind meine Ergebnis bei weitem nicht so stringent wie diejenigen, die mit Experimenten gewonnen werden. – Ich verwende Modelle und Theorien, die sich in der Physik bewährt haben, verändere diese für einen sozialen oder psychischen Kontext und überprüfe, ob daraus resultierende Aussagen ‚Sinn ergeben‘. ‚Sinn ergeben‘ heißt, dass die Ergebnisse durchaus mit der Brille ‚Sozial‘ oder ‚Psyche‘ interpretiert werden können und sogar einen Blick in die Zukunft gesellschaftlicher Entwicklungen erlauben. – Bisher hat sich diese Form von ‚Sinn ergeben‘ gezeigt, indem sich die metaphysische Tür zu ‚Es gibt nur eine Welt!‘ mit meinen Blog-Beiträgen ein wenig geöffnet hat.

Für diesen Blog-Beitrag formuliere ich zwei ‚metaphysische‘ Fragestellungen:

  • Lassen sich gesellschaftliche Phänomene wie Kultur oder Team Collective Mind mittels Potentialen oder Feldern beschreiben, wie man sie aus der Physik kennt?
  • Kann man soziale Resonanz zwischen Menschen mittels der Wellenmechanik der Quantenmechanik beschreiben?

Zur ersten Frage: Drei der vier Fundamentalkräfte (Elektrodynamik, starke Wechselwirkung und schwache Wechselwirkung) werden heute mit sogenannten Eichpotentialen beschrieben. Diese Eichpotentiale erzeugen sogenannte unitäre Dynamiken bzw. Transformationen. Ich verzichte hier auf die genaue mathematische Definition der unitären Dynamik. Wichtig ist hier, dass diese Eichpotentiale Information in einem modellierten System erhalten. Lediglich zwischen Teilsystemen eines System kann Information verschoben werden. Derzeit ist die vierte Kraft, die Gravitation, die einzige Wechselwirkung, die Information zerstört, denn sie wird derzeit über die Allgemeine Relativitätstheorie beschrieben, die keine Eichtheorie ist.- In dem Glauben, dass alle Fundamentalkräfte auf Eichpotentialen beruhen, wird seit Jahrzehnten versucht, die Allgemeine Relativitätstheorie in eine Eichtheorie einzubetten. – Bisher ohne Erfolg.
Es gibt auch einige Wissenschaftler – darunter der Nobelpreisträger Roger Penrose – die überzeugt sind, dass sich Gravitation nicht durch eine Eichtheorie beschreiben lässt und dass gerade dies notwendig ist, damit unsere makroskopische Realität aus der Quantenwelt hervorgehen kann.– Die Gravitation sorge hiernach dafür, dass der typische Wellencharakter der Quantenwelt ‚kollabiert‘ und die makroskopische Welt entsteht. – Zum ‚Kollabieren der Wellenfunktion‘ verweise ich auf den nachfolgenden Text.

Ich habe das SU(3) Eichpotential der starken Wechselwirkung für die Beschreibung gesellschaftlicher Phänomene gewählt, weil die Nicht-Kommutativität unserer Entscheidungen damit abgebildet werden kann (man siehe hierzu die vorherigen Blog-Beiträge). Außerdem lassen sich die Bewusstseinsebenen des Spiral Dynamics Modells problemlos auf die Freiheitsgrade des SU(3) Potentials abbilden. Die kulturelle Information bleibt erhalten und wird lediglich von einem Teilsystem in ein anderes Teilsystem transformiert.
Das SU(3) Eichpotential hat ursprünglich vier Komponenten, eine Zeitkomponente und drei Ortskomponenten. – Mit Einführung der Relativitätstheorie vor mehr als 100 Jahren haben fast alle physikalischen Größen diese Vierer-Struktur bekommen. Jede der vier Komponenten wird durch die 8 Generatoren und jeweils 8 Parameterfunktionen modelliert. Jede Parameterfunktion kann zusätzlich von Ort und Zeit abhängen. – Also eine ziemlich komplexe Struktur… Man siehe hierzu den Anhang des ersten Blog-Beitrages dieser Reihe.

Das in den letzten Blog-Beiträgen verwendete kulturelle Eichpotential ist (derzeit) ein Modell, das nur eine Ortskomponente enthält. Diese Ortskomponente enthält die Zeit als Parameter, aber nicht den Ort, ist also ohne Ortsauflösung: D.h. ohne Länder, Regionen, Organisationen oder Teams; aber mit Zeitauflösung. – Das heißt, das QSD-Kulturpotential hängt bisher nur von der Zeit aber nicht vom Ort ab. Im letzten Blog-Beitrag habe ich also Deutschland als homogenes Land für den Zeitraum 2000-2025 beschrieben. Die Teilsysteme des Systems Deutschland sind ‚nur‘ die drei Agenten mit ihren Werte-Ebenen im Spiral Dynamics Modell: Blau, Orange und Grün.

Mit der Zeit-Komponente hat man die Möglichkeit unterschiedliche Zeitskalen bzw. Frequenzen für die drei verwendeten Spiral Dynamics Ebenen zu modellieren: Die Grüne Ebene ‚tickt‘ dann zum Beispiel anders als die blaue Ebene und die Kopplung der Uhren dieser Ebenen kann auch abgebildet werden. Dies könnte ein Thema für einen der nächsten Blog-Beiträge sein.

Mit meiner Wahl der Potential-Komponenten habe ich die einfachste Eichung für das Kulturpotential vorgenommen. – Die vorherigen beiden Blog-Beiträge haben meines Erachtens gezeigt, dass diese Eichung für die Modellierung gesellschaftlicher Phänomene schon aussagekräftige Ergebnisse liefert.    

Zur zweiten Frage: Die Frage nach der Abbildbarkeit von zwischenmenschlicher Resonanz mittels Wellenmechanik führt mich unmittelbar zu den Begriffen Kohärenz und Kohäsion. Ich definiere nämlich Resonanz als das Auftreten von Kohärenz und ggf. Kohäsion in der Wellenmechanik:

  • Kohärenz misst Synchronisation: Quanten oder Agenten schwingen im Takt, gleichzeitig oder versetzt. Über Phasenbeziehungen werden Quanten oder Agenten (bzw. deren Werte) in Superposition gebracht. – Es entstehen hieraus neue Zustände, die als Ganzes wirken und Interferenzen ausbilden.
  • Kohäsion misst Bindung: Quanten oder Agenten werden durch Kräfte oder Rahmenbedingungen (u.a. Strukturen und Institutionen) zusammengehalten. Dies erzeugt Stabilität und Ordnung.

Kohärenz und Kohäsion sind zwei unabhängige Größen, so kann zum Beispiel Synchronisation zunehmen, während Bindung abnimmt.

Ich verdeutliche Kohärenz und Kohäsion an einem Beispiel aus der Filmwelt: Es gibt sehr viele Filme, in denen zwei sehr ungleiche Personen durch einen meist unglücklichen Umstand (Rahmenbedingung) auf einander angewiesen sind, um eine Aufgabe zu meistern. Durch diese ungewollte Kohäsion beginnen sie nach einiger Zeit immer mehr ihre Handlungen aufeinander abzustimmen. Diese Form der Kohärenz führt dazu, dass sie besonders erfolgreich sind. Sie agieren als Team, also als Ganzes.

Oder ein anderes Beispiel: Bei einem Liebespaar wirkt die gegenseitige Attraktivität als Kohäsion und die Kohärenz stellt sich als gemeinsames Denken und Handeln (manchmal) danach ein.

Deshalb haben wir ehemals definiert, dass ein Team oder eine Organisation ein Collective Mind zeigt, wenn sowohl Kohäsion als auch Kohärenz vorliegen. – Für eine mathematische Definition der beiden Begriffe im Kontext der QSD verweise ich auf den Anhang.

Abbildung 1 gibt Beispiele aus der Physik und der Gesellschaft und verdeutlicht diese mittels der Einordnung in eine 2*2 Matrix für Kohäsion und Kohärenz.

Abbildung 1: Erstellt unter Mitwirkung von ChatGPT. Eine 2*2 Matrix für Kohäsion und Kohärenz zeigt Beispiele aus Physik und Gesellschaft. Die Physik Beispiele zu Laser und Supraleitung verwende ich oft in Management 4.0 Trainings, um die ‚unglaubliche‘ Leistung von kohäsiven und kohärenten Systemen zu verdeutlichen: Mit einem Laser können wir sehr große Energie auf kleinstem Raum bündeln, also zum Beispiel Stahlplatten durchschneiden. Die Supraleitung dient dazu, elektrische Ströme widerstandlos zu erzeugen. – In beiden Fällen muss man eine gewisse Energie in das System eingeben, um die gewünschten Effekte zu erzielen. Ich erläutere kurz was bei der Supraleitung geschieht: Spezielle Materialien werden auf sehr tiefe Temperaturen abgekühlt.- Um dies zu erreichen, benötigt man eine gewisse Energie. Die Gitteratome der Materialien zeigen bei sehr tiefen Temperaturen nur noch sogenannte Ruheschwingungen, man spricht von virtuellen Quanten, den Phononen. Zwei Elektronen treten über die Phononen in Wechselwirkung, sie bilden also eine Kohäsion aus. Liegt diese Kohäsion vor, ist die Voraussetzung geschaffen, dass sich ein (bosonisches) Elektronenpaar, das sogenannte Cooper-Paar, in Kohärenz ausbildet. In dem alle Cooper-Paare in einen gemeinsamen kohärenten Zustand übergehen, senkt sich die Energie noch weiter ab. – Es entsteht Supraleitung: Das Ganze ist mehr als die Summe seiner Teile. – Dies ist wahrscheinlich das beste physikalische Beispiel für Kohäsion und Kohärenz.

Wie man aus Abbildung 1 entnehmen kann, tritt Kohäsion sowohl in makroskopischen Systemen (Festkörper) als auch in Quantensystemen (Supraleiter) auf. Kohärenz, wie wir sie gleich skizzieren, ist ein typischer Quanteneffekt: Die Wellen der Quanten wechselwirken miteinander. Ich benutze diesen Effekt der Wellenmechanik, um interfrierende Wechselwirkung der Entscheidungsfindung im Menschen (Quantum Cognition) und in der Kommunikation zwischen Menschen zu beschreiben. – Es ist (bisher?) lediglich ein Modell, das psychische und soziale Effekte hilft mathematisch zu erfassen. – Unter dieser Einschränkung stehen die Ergebnisse dieser Blog-Reihe!

Ich habe überprüft, inwieweit die Zuordnung der Basiszustände zu den Generatoren sowie die Zuordnung der Basiszustände zu den Werte-Farben und die Zuordnung der Parameterfunktionen zu den Generatoren einen Einfluss auf die bisherigen und nachfolgenden Ergebnisse haben:

Im QSD-Modell wird die gesellschaftliche Dynamik durch eine Zuordnung von Spiral Dynamics Farben zu quantenmechanischen Basiszuständen beschrieben. Diese Basiszustände sind nicht frei wählbar, sondern stehen in einem festen Zusammenhang mit den SU(3)-Generatoren, die das soziale Eichpotential aufspannen. Mathematisch gilt: Jede unitäre Permutation der Basis wäre erlaubt, weil sich die Generatoren konsistent transformieren lassen. Inhaltlich jedoch zeigt ein Permutationstest, dass nicht alle Zuordnungen von Farben zu Basiszuständen gleichwertig sind.
Die Referenzzuordnung der Zustände zu Blau, Orange und Grün repoduziert die Daten des Deutschland-Modells 2000 bis 2025 über die Zeit am konsistentesten. Andere Permutationen sind zwar formal korrekt, führen aber u.a. zu abweichenden Phasen- und Kohärenzverläufen, die mit den empirischen Entwicklungen in Deutschland von 2000 bis 2025 weniger gut in Einklang stehen.
Die Wahl der Zuordnungen entsteht also nicht durch eine willkürliche Setzung, sondern spiegelt eine Konsistenz zwischen mathematischer Struktur (Basis und Generatoren) und sozialer Interpretation (Farbwerte und Parameterfunktionen) wider. Sie liefert damit zugleich eine Validierung des Modells.

Die nachfolgende Formel zeigt die allgemeinste Form einer Superposition für den Werte-Zustand eines Menschen in dem vereinfachten QSD-Modell, bestehend aus den Ebenen Blau (b), Orange (o) und Grün (g). Die Argumente in den e-Funktionen sind die Phasen der Wellenfunktionen: Vergegenwärtigt man sich, dass die e-Funktion mit komplexem Argument auch mittels cos- und sin-Funktion dargestellt werden kann, so sieht man, dass über diese Wellen-Wechselwirkungen (u.a. Superpositionen und Interferenzen) entstehen:

     \begin{equation*} |\Psi_{\text{QSD}}(t,r)\rangle = c_b\,e^{\,i\,\theta_b(t,r)}\,|b\rangle \;+\; c_o\,e^{\,i\,\theta_o(t,r)}\,|o\rangle \;+\; c_g\,e^{\,i\,\theta_g(t,r)}\,|g\rangle \end{equation*}

Ѳ bezeichnet die Phasen, ist reel und hängt von der Zeit t und dem Ortsvektor r ab.

Jeder der Agenten mit einem der Anfangs-Werte Blau, Orange und Grün wird auf seinem Weg im Kulturpotential durch solch eine Gleichung beschrieben: Am Anfang der Simulation der vorherigen Blog-Beiträge haben die Agenten nur eine Ausrichtung in den Werten, sie sind Blau oder Orange oder Grün. Während sie sich durch das Kulturpotential bewegen, geht ihre Werte-Zusammensetzung jeweils in eine Werte-Superposition über.

Abbildung 2 zeigt die Phasenentwicklung der Agenten und die Agenten-eigene Kohärenz gemäß dem Deutschland-Modell 2000-2025 des vorherigen Blog-Beitrags.

Abbildung 2: Die Abbildung zeigt jeweils die Entwicklung der drei Phasen der drei Agenten A (Blau), B (Orange) und C (Grün) sowie die daraus abgeleitete Agenten-eigene Kohärenz im Zeitraum 2000 bis 2025. In den Phasenverläufen wird deutlich, dass sich die Agenten unterschiedlich stark von ihrer ursprünglichen Basis entfernen: Während bei Agent A die Komponenten zunehmend auseinanderlaufen und damit eine wachsende interne Spannung andeuten, zeigen die Phasen von Agent B eine Polarisierung zwischen Blau sowie Orange und Grün, die auf eine innere Spaltung des Werteprofils hindeutet. Agent C hingegen bleibt phasenmäßig elastischer und oszilliert ohne eine klare Drift, was auf eine höhere Anpassungsfähigkeit im Werte- und Bedürfnisraum schließen lässt. Im Kontext der QSD bedeutet dies, dass A und B auf stabile, aber polarisierte Erzählrichtungen zusteuern, während C eher eine vermittelnde Rolle einnimmt bzw. einnehmen kann.

Abbildung 3 zeigt Kohärenz und Kohäsion für das 3 Agenten System:

Abbildung 3: Diese Abbildung zeigt die Entwicklung von Kohärenz (oben) und Kohäsion (unten) im Deutschlandmodell 2000–2025. – Wir betrachten die drei Agenten Blau, Orange und Grün als Werte-Populationen mit einer 50%:30%:20% Verteilung.
Kohäsion bedeutet, dass Menschen ähnliche Themen bewegen, auch wenn sie unterschiedliche Narrative dazu haben. Kohärenz heißt, dass diese Themen in einer gemeinsamen Welle getragen werden, also in Resonanz geraten – sie teilen die gleichen Narrative.

Das Modell zeigt, dass die Gesamt-Kohärenz zwar zeitweise hohe Werte erreicht, jedoch bei zentralen Krisen – etwa Agenda 2010 (2004), Eurokrise (2012), Fluchtmigration (2016) und Energiekrise/Ukrainekrieg (2023) – tiefe Einbrüche erfährt. Die quantenmechanisch berechnete Kohäsion bleibt bei nahezu null, während die klassische Kohäsion (Bhattacharyya und Cosine) beständig belegt, dass es thematische Überschneidungen gibt.

Im Zusammenspiel ergibt sich: Wirtschaft, soziale Fragen oder Klima betreffen zwar alle, verlaufen aber in getrennten Erzählungen ohne dauerhaftes kollektives Narrativ. Ereignisse erzeugen kurzfristige Resonanz oder Brüche, doch keine stabile gemeinsame Phase. Deutschland zeigt somit thematische Kohäsion, aber keine narrative Kohärenz – also eine fragile Stabilität, die anfällig für Fragmentierung ist.

Ich beantworte also die zweite Frage, ob man soziale Resonanz zwischen Menschen mittels der Wellenmechanik der Quantenmechanik beschreiben kann, mit ja: Alle bisherigen QSD-Interpretationen sind konsistent und stimmen gut mit der Kultur-Realität in Deutschland überein.

Anhang

QSD Formeln und Erläuterung

Die nachfolgende Gleichung zeigt die QSD-Wellenfunktion in der allgemeinsten Form als Superpostion der Werte Blau, Orange und Grün. Jeder Agent wird durch solch eine Wellenfunktion beschrieben. Das Argument in der e-Funktion wird als Phase bezeichnet und ist für die Welleneigenschaften der Funktion verantwortlich: Eine imaginäre e-Funktion kann mittels cos- und sin-Funktion beschrieben werden, was den Wellencharakter sofort verständlich macht.  Am Anfang der Simulation zeigen die Agenten jeweils ein ‚reines‘ Werteprofil, also nur jeweils Blau, Orange oder Grün:   

     \begin{equation*} |\Psi_{\text{QSD}}(t,r)\rangle = c_b\,e^{\,i\,\theta_b(t,r)}\,|b\rangle \;+\; c_o\,e^{\,i\,\theta_o(t,r)}\,|o\rangle \;+\; c_g\,e^{\,i\,\theta_g(t,r)}\,|g\rangle \end{equation*}

Falls ein Mehr-Quantensystem, oder im Falle der QSD, ein Mehr-Agenten System vorliegt, beschreibt man dieses sehr oft mittels eines Dichte-Operators bzw. einer Dichte-Matrix. Dass es sich bei dem Dichte-Operator um eine Matrix handelt, kann man sehr schnell sehen, wenn man die rechte Seite der nachfolgenden Gleichung als Vektorprodukt eines Vektors mit seinem transponierten Vektor interpretiert:

     \begin{equation*} \rho_{\text{QSD}}(t,r) \;=\; |\Psi_{\text{QSD}}(t,r)\rangle \langle \Psi_{\text{QSD}}(t,r)| \end{equation*}

Man kann die Dichte-Matrix in einen Diagonalteil und einen Nicht-Diagonal-Teil zerlegen. Die Elemente des Nicht-Diagonal-Teils sind für die Kohärenz eines Quantensystems verantwortlich. Sind alle Nicht-Diagonal-Elemente null, geht das System in ein klassisches System über. – Es kollabiert. – Die nachfolgenden Gleichungen zeigen die Diagonal-Elemente und die Nicht-Diagonal-Elemente:

     \begin{equation*} \rho_{\text{QSD}}(t,r) \;=\; \rho_{\text{diag}}(t,r) \;+\; \rho_{\text{off}}(t,r) \end{equation*}

     \begin{equation*} \rho_{\text{diag}}(t,r) \;=\; |c_b|^2\,|b\rangle\langle b| \;+\; |c_o|^2\,|o\rangle\langle o| \;+\; |c_g|^2\,|g\rangle\langle g| \end{equation*}

     \begin{equation*} \rho_{\text{off}}(t,r) \;=\; \sum_{i\neq j \in {b,o,g}} \rho_{ij}(t,r)\,|i\rangle\langle j| \end{equation*}

     \begin{equation*} \rho_{bo}(t,r) \;=\; c_b\,c_o\*e^{\,i\big(\theta_b(t,r)-\theta_o(t,r)\big)} \end{equation*}

     \begin{equation*} \rho_{bg}(t,r) \;=\; c_b\,c_g\*e^{\,i\big(\theta_b(t,r)-\theta_g(t,r)\big)} \end{equation*}

     \begin{equation*} \rho_{ob}(t,r) \;=\; c_o\,c_b\*e^{\,i\big(\theta_o(t,r)-\theta_b(t,r)\big)} \end{equation*}

     \begin{equation*} \rho_{gb}(t,r) \;=\; c_g\,c_b\*e^{\,i\big(\theta_g(t,r)-\theta_b(t,r)\big)} \end{equation*}

     \begin{equation*} \rho_{go}(t,r) \;=\; c_g\,c_o\*e^{\,i\big(\theta_g(t,r)-\theta_o(t,r)\big)} \end{equation*}

     \begin{equation*} \text{(Hermitizität:)}\qquad \rho_{ji}(t,r) \;=\; \rho_{ij}(t,r)^{*}\, \end{equation*}

Agenten-eigene Kohärenz

Ich beschreibe die zeitabhängige Agenten-eigene Kohärenz über die sogenannte Cℓ1\ell_1-Kohärenz. Diese misst die Stärke der Superposition über die Nicht-Diagonal-Elemente der Dichtematrix:

    \begin{equation*}C_{\ell_1}(\rho) = \sum_{i \neq j} \big| \rho_{ij} \big|.\end{equation*}

Mean-Field Ansatz für die kollektive Kohärenz

Im Rahmen des QSD-Modells habe ich einen Mean-Field-Ansatz für die kollektive Kohärenz einer Agenten-Mischung eingeführt. Mit der Agenten-Mischung lassen sich Werte-Populationsmischungen einer Gesellschaft analysieren. Für Deutschland habe ich angenommen, dass 50% der Bevölkerung ein dominantes blaues Mem haben, 30% ein dominates orangenes und 20% ein dominates grünes Mem.

Zunächst definieren wir den kollektiven Zeiger als gewichtete Summe der Agentenzustände ψn∈C3\psi_n \in \mathbb{C}^3:

    \begin{equation*}\mu(t) = \sum_{n} w_n  \psi_n(t),\qquad \sum_{n} w_n = 1.\end{equation*}

Die Norm dieses Zeigers liefert den Ausrichtungsparameter R(t)R(t):

    \begin{equation*}R(t) = |\mu(t)|  \in [0,1].\end{equation*}

  • R(t)≈0R(t) \approx 0: die Agentenzustände heben sich gegenseitig auf → keine kollektive Ausrichtung.

  • R(t)≈1R(t) \approx 1: perfekte Ausrichtung → maximale Kohärenz.


Auf Basis von R(t)R(t) konstruieren wir die Mean-Field QSD-Dichte-Matrix:

    \begin{equation*}\rho_{\text{QSD}}(t) = \big(1-R(t)^2\big) \mathrm{diag} \big(p_{\text{avg}}(t)\big)+ R(t)^2  \frac{|\mu(t)\rangle\langle\mu(t)|}{\langle \mu(t)|\mu(t)\rangle},\end{equation*}

wobei pavg(t)=diag ⁣(ρmix(t))p_{\text{avg}}(t)=\mathrm{diag}\!\big(\rho_{\text{mix}}(t)\big) die klassische Durchschnittsverteilung über die Agenten bezeichnet.


Die Kohärenz wird mit dem C ℓ1\ell_1-Maß über die Nicht-Diagonal-Elemente von ρQSD(t)\rho_{\text{QSD}}(t)berechnet:

    \begin{equation*}C_{\ell_1}(t) = \sum_{i\neq j} \big|\rho_{\text{QSD},ij}(t)\big|.\end{equation*}

Für die Mean-Field-Formel kann dies kompakt in Abhängigkeit von μ^(t)=μ(t)/∥μ(t)∥\hat{\mu}(t)=\mu(t)/\|\mu(t)\| geschrieben werden:

    \begin{equation*}C_{\ell_1}(t) = R(t)^2 \left[ \left(\sum_{i=1}^3 |\hat{\mu}_i(t)| \right)^2 - 1 \right].\end{equation*}


Damit ergibt sich eine natürliche Schranke für die Kohärenz:

    \begin{equation*}C_{\ell_1}(t) \leq 2 R(t)^2,\end{equation*}

wobei das Maximum genau dann erreicht wird, wenn alle drei Komponenten von μ^(t)\hat{\mu}(t) gleiche Beträge besitzen, also

    \begin{equation*}|\hat{\mu}_b| = |\hat{\mu}_o| = |\hat{\mu}_g| = \tfrac{1}{\sqrt{3}}.\end{equation*}

Quanten-Kohäsion (Overlap)
Dieses Maß berechnet die Überlappung zweier Zustände im Hilbert-Raum. Es ist sensitiv für Phasenbeziehungen und nimmt Werte im Bereich [0,1] an, wobei 1 volle Überdeckung (identische Zustände) bedeutet.
Im QSD-Kontext zeigt ein hoher Wert, dass Menschen nicht nur ähnliche Themen haben, sondern diese auch in gemeinsamer Phase und Resonanz bewegen – also ein Narrativ-Kollektiv bilden.

     \begin{equation*} \text{Cohesion}(t) = \frac{1}{\binom{N}{2}} \sum_{i<j} \big|\langle \Psi_i(t) | \Psi_j(t) \rangle \big| \end{equation*}

Bhattacharyya-Kohäsion
Dieses Maß berechnet die Ähnlichkeit zweier Wahrscheinlichkeitsverteilungen, indem es deren geometrisches Mittel bildet. Es liegt im Bereich [0,1] wobei 1 für identische Verteilungen steht. Hierbei sind p_i​ und q_i​ die klassischen Wahrscheinlichkeiten, dass die Agenten in den Basis-Zuständen i (z. B. Blau, Orange, Grün) gemessen werden.

Im QSD-Kontext bedeutet ein hoher Wert: Menschen bewegen ähnliche Themen mit vergleichbarer Stärke, auch wenn ihre Narrative unterschiedlich sein können.

     \begin{equation*} C_{\text{Bhat}}(p,q) = \sum_{i} \sqrt{p_i q_i,} \end{equation*}

     \begin{equation*} \quad p_i = | \psi_i |^2, q_i = | \phi_i |^2 \end{equation*}

Kosinus-Kohäsion
Dieses Maß betrachtet die Verteilungen als Vektoren und misst den Winkel zwischen ihnen. Werte nahe 1 bedeuten eine sehr ähnliche Richtung (also ähnliche Verteilungen), Werte nahe 0 zeigen starke Unterschiede. Auch hier sind p_i​ und q_i​ die klassischen Wahrscheinlichkeiten für den jeweiligen Basiszustand i.

Im QSD-Kontext beschreibt dieses Maß, ob verschiedene Gruppen ihre Themen in vergleichbarer Gewichtung anordnen – ob also die „Richtung der Aufmerksamkeit“ ähnlich ist, auch wenn die absolute Stärke variiert.

     \begin{equation*} C_{\text{Cos}}(p,q) = \frac{\sum_{i} p_i q_i}{\sqrt{\sum_{i} p_i^2},\sqrt{\sum_{i} q_i^2}} \end{equation*}

AI & QC & M 4.0: Alles Quantum? oder von Quantum Computing Modell-Archetypen

Ein beeindruckender Podcast, erstellt von NotebookLM, fasst den Blog-Beitrag in englischer Sprache zusammen:


‚Alles Quantum?‘, Hinter dieser Frage verbirgt sich eine der spannendsten ungelösten Fragen der Physik: Gibt es eine einheitlich Quanten-Theorie, die die Welt des Kleinen (Quanten) und die Welt des Großen (Klassisch) integriert? Seit ungefähr 100 Jahren wird nach einer solchen Theorie gesucht.

Abbildung 0: Bild erzeugt mittels Dall-E: Die 7 Modelle des Blog-Artikels symbolisch dargestellt als Wissenschaftler, die um Erkenntnis kämpfen. Die Darstellung zeigt die Wissenschaftler auf einem futuristischen, quantenmechanischen Schlachtfeld.

In diesem Blog gehen wir es viel unbedeutender an: Ich stelle die von mir bisher erstellten Collective Mind Modelle (CM Modelle) aus der Welt der Quanten und der ‚klassischen‘ Welt zusammen und beleuchte deren Aussagemöglichkeiten. Diese Modelle lassen sich in drei Kategorien einteilen: Quantum-Modelle, die vollständig auf Prinzipien der Quantenmechanik beruhen. – Klassische Modelle, die keine Prinzipien der Quantenmechanik enthalten. – Hybride Modelle, die Prinzipien der Quantenmechanik und der klassischen Welt enthalten. Diese drei Modell-Kategorien zeigen in ihren Aussagemöglichkeiten verschiedene Potentiale, werfen teilweise neue Fragen auf und gehen damit deutlich über ihre Grenzen hinaus. Die vorgestellten Modell sind Modell-Archetypen, die ähnlich in völlig anderen wissenschaftlichen oder industriellen Anwendungsbereichen verwendet werden. Alle Modelle wurden unter großer Mithilfe von ChatGPT-o1 erstellt. Die Menge aber auch die völlig unterschiedlichen Modell-Herangehensweise, erstellt in einer erstaunlich kurzen Zeit, verdeutlichen die enorme Leistungssteigerung der hybriden kollektiven Intelligenz von Maschine und Mensch:   

Modell 1 – Agent Based Modelling der Teaminteraktionen: Dieses (bisher) klassische Modell verwendet Agent Based Modelling, um Team-Interaktionen zu beleuchten. Mitglieder eines Teams werden als Agenten modelliert. Agenten sind (stark vereinfachte) Repräsentanten von Menschen. Im Blog vom Juni 2023 ‚AI & M 4.0: (Collective Intelligence)**2 – Collective Mind Agent Based Model mit GPT-4/chatGPTplus’ wird ein Team mit 7 Teammitgliedern und einer unterschiedlichen Anzahl an Stakeholdern modelliert. Den Teammitgliedern werden feste MBTI Persönlichkeitsmerkmale zugewiesen und die Stakeholder erhalten per Zufall gemäß der MBTI Verteilung in der westlichen Welt ihre Persönlichkeit. Jedem der Agenten wird per Zufall eine 3-Ebenen Ziel-Hierarchie, bestehend aus einer abstrakten Zeichenkette pro Ebene, zugewiesen. Der Collective Mind (CM) im Team und auch im Stakeholder-Umfeld ist maximal, wenn alle Teammitglieder im Team (und im Stakeholder-Umfeld) die gleiche Ziel-Hierarchie haben. Der Kommunikationsaustausch wird durch die Persönlichkeitsprofile und eine Lernrate (getrennt nach Team und Stakeholdern) bestimmt. Dieses Setting und die Definition des Collective Mind über die Ziel-Hierarchie entspricht der Theorie und Praxis im Management 4.0: Die Ziel-Hierarchien gleichen sich mit unterschiedlichen Zeitskalen im Team und im Stakeholder-Umfeld an. Die Zeitskalen hängen von der Lernrate sowie der Team-Zusammensetzung bzw. Stakeholder-Zusammensetzung ab. Damit ist es möglich, den Einfluss der Persönlichkeit auf die zeitliche Dynamik des CM zu untersuchen und optimale Team-Zusammensetzungen zu studieren. Mit der Anbindung von KI-Systemen werden (zukünftig) KI-Agenten im Agent Based Modelling verwendet werden. – Dies ist eine Entwicklung, die vor kurzem einen neuen KI-Hype ausgelöst hat. In Zukunft werden sicherlich Agenten zusätzlich mit Quantum Eigenschaften (siehe nachfolgende Modelle) ausgestattet. Voraussetzung hierfür ist eine entsprechend effiziente hybride Hardware, bestehend aus klassischer und Quantum Hardware.

Modell 2 – Eigenvektoren der CM Ähnlichkeitsmatrix Analyse: Dieses klassische Modell beruht auf der Grundidee, Ähnlichkeiten der Kommunikation in einem Team oder in einer Gruppe für die Messung des CM zu verwenden. Hierzu wird die Kommunikation mittels zweier Teile, dem gesprochene Wort und der nonverbale Kommunikation über Sentiments (Emotionen), ausgedrückt.  Zentrale Größe ist deshalb eine komplexe Ähnlichkeitsmatrix CM, die aus zwei Teilen besteht. Die Ähnlichkeitsmatrix CM = Matrix der Text-Ähnlichkeiten + i* Matrix der Sentiments-Unterschiede. Für die Ähnlichkeitsmatrix CM lassen sich Eigenvektoren und Eigenwerte berechnen. Der Eigenvektor mit dem höchsten Eigenwert wird als CM Vektor interpretiert und der dazugehörige Eigenwert gibt die relative Stärke des CM an. Die Elemente des CM Vektors repräsentieren die Beitragsstärken der einzelnen Gruppen- oder Teammitglieder zum CM. Auf dieser Basis wurde im Blog ‚AI & M 4.0: Markus Lanz vom 30. Mai 2024: Eine Collective Mind Analyse‘ vom Juni 2024 die Gruppendynamik einer Gesprächsrunde analysiert. Es hat sich gezeigt, dass eine Untergruppe der Gesprächsrunde bestehend aus den Teilnehmern 2,4 und 5, bzw. in der Notation des nachfolgenden Modells 3 die Gruppenmitglieder B,D,E, im Wesentlichen den Collective Mind gestalten. Es ist also möglich, Kommunikationsmuster inkl. der nonverbalen Kommunikation transparent zu machen und die Träger des CM zu identifizieren.

Modell 3 – Ising-Modell der CM Ähnlichkeitsmatrix Analyse: Dieses Modell ist eine Form eines hybriden Modells und ergänzt Modell 2: Die Ausgangsbasis ist der Realteil der Ähnlichkeitsmatrix aus Modell 2. Die Ähnlichkeitsmatrix wird als Repräsentant eines Netzwerkes verstanden: Die Stärken der Ähnlichkeiten bilden die Kanten des Netzwerkes. Dieses klassische Netzwerk kann auf ein Ising Qubit-Netzwerk mit entsprechenden Kantenstärken abgebildet werden. Die Quantum Computing Berechnung mit der d-wave Annealing Technologie ermittelt die Energielandschaft dieses Netzwerkes. Die niedrigsten Energietäler oder das niedrigste Energietal repräsentiert den energetisch günstigsten Teamzustand und ist damit identisch mit dem CM Zustand. Die Anwendung auf die Gruppendynamik aus Modell 2 ergibt, dass die Untergruppe BDE den Collective Mind repräsentiert. Modell 3 ist ohne Probleme auf große Gruppen skalierbar, was bei der klassischen Berechnung mittels Eigenwert und Eigenvektoren nicht der Fall ist. Außerdem wird der CM-Beitrag anderer Teammitglieder-Kombinationen durch ihre Einordnung auf der Energieskala sofort und einfach sichtbar. Leider konnte bisher der Imaginärteil der Ähnlichkeitsmatrix nicht verwendet werden, da damit in Gebiete vorgestoßen wird, die auch noch in der Quantenmechanik gerade erst erforscht werden. – Die vollständige Abbildung der Ähnlichkeitsmatrix auf das d-wave System ist deshalb z.Zt. (noch) nicht möglich.    

Modell 4 – Quantum Cognition der Team Kommunikation: Dieses Modell ist ein vollständiges  quantenmechanisches Modell und beruht auf exakten Quanten-Berechnungen des CM auf einem klassischen Computer. Die eins-zu-eins Übertragung auf einen Quantencomputer ist nicht möglich. Damit ist das Modell nicht skalierbar, da die Berechnungen mit steigender Anzahl an Personen exponentiell wachsen. Das Modell wurde im Blog ‚AI & QC & M 4.0: Quantum Cognition für das Team-Management oder von der Macht der Mathematik‘ vom Oktober 2024 veröffentlicht. Die Idee ist hierbei die Persönlichkeitsdimensionen des Big Five (oder MBTI) Persönlichkeitsmodells in Qubit-Zustände abzubilden. Eine eindeutige positive Präferenz für eine Persönlichkeits-Dimension wird in eine Qubit  1 umgesetzt, eine eindeutige negative Präferenz in eine Qubit 0 und eine indifferente Präferenz wird als Superposition abgebildet. Ich wende die aus der Quantenmechanik bekannte Technik der Projektionsoperatoren auf das so abgebildete Persönlichkeitsmodell an: Über einen Interaktionsoperator wird zuerst die Interaktion im Team berechnet. Hieraus entsteht eine Team-Quantenwelle für die mittels eines CM Operators die Wahrscheinlichkeit für das Eintreten eines CM berechnet wird. Der CM Zustand wird als Zustand der quantenmechanischen Verschränkung interpretiert: Hierbei kann wahlweise danach unterschieden werden, ob alle Persönlichkeitsdimensionen verschränkt sind oder nur ein Teil der Dimensionen.
Die theoretischen Ergebnisse werden qualitativ durch viele praktische Erfahrungen gestützt: u.a hängt die Wahrscheinlichkeit ein CM auszubilden stark von der Teamzusammensetzung ab, die Reihenfolge der Interaktionen hat einen Einfluss auf die CM Dynamik, und ordnen die Teammitglied ihre Persönlichkeitspräferenzen nicht einem gemeinsamen Ziel unter, wird die Wahrscheinlichkeit der CM Ausbildung stark beschränkt. Nicht-lineare Effekte der Persönlichkeitsinteraktionen werden meines Erachtens erstaunlich gut abgebildet. Dies wirft die sehr weitreichende Frage auf, ob unsere Kognition und unsere Kommunikation zum Teil oder ganz den grundlegenden Prinzipien der Quantenmechanik unterliegen.    

Die nachfolgenden Modelle sind bisher nicht in einem Blog enthalten und werden hier erstmalig vorgestellt:

Modell 5 – Variationsmodell der Quantum Team Kommunikation: Dieses hybride Modell weist wie Modell 4 die Big Five Persönlichkeitspräferenzen Qubits zu. Diese Persönlichkeitspräferenzen dienen jedoch lediglich als Startwerte für eine Variationsrechnung. Ausgehend von den Startwerten werden mittels klassischer Variation Qubit-Superpositionen erzeugt. Ziel ist es, mittels Variation einen vollständigen verschränkten CM Zustand für eine ausgewählte Persönlichkeitsdimension (zum Beispiel die der Offenheit) zu finden. Es zeigt sich, dass ein solcher verschränkter Zustand existiert, wenn andere Persönlichkeitsdimensionen von den Startwerten abweichen. Im Beispiel-Team führt dies u.a. dazu, dass die unbestimmte Persönlichkeitspräferenz Gewissenhaftigkeit des Teammitgliedes Alice sich in eine Persönlichkeitsdimension Gewissenhaftigkeit mit geringer Präferenz wandeln muss. Dies zeigt an, dass sich ein CM oft nur dann ausbilden kann, wenn die Teammitglieder ihre persönlichen Präferenzen dem gemeinsamen Ziel oder der gemeinsamen Vision unterordnen. Mit diesem Modell ist es auch möglich, optimalere Teampräferenzen, mit denen sich ein CM leichter ausbildet, per Variation zu finden.

Modell 6 – Ising Modell der Team-Interaktion: Dieses Quantum Modell läuft auf der d-wave Hardware. Hierzu werden die Big Five Persönlichkeitspräferenzen in Qubit-Zustände umgesetzt, deren Wechselwirkungen über ein Ising-Modell erfasst werden (siehe Abbildung 1) – Jedes Teammitglied wird mittels n Qubits modelliert. Für jede der n Persönlichkeitsdimensionen ein Qubit.

Abbildung 1: Energie des Ising-Models, in dem die Qubits als Spins (magnetische Momente) si modelliert werden und deren Paar-Wechselwirkung durch Jij.

Die Qubit-Paar-Wechselwirkungen Jij stellen eine Matrix dar (siehe auch Modell 3 und dort die Verwendung einer Ähnlichkeitsmatrix). Die Einzelenergie hi und die Paar-Wechselwirkungen Jij werden leider per Intuition festgelegt. – Derzeit kenne ich keinen praktikablen Weg die Qubit Einzelenergie und die Qubit-Paar-Wechselwirkungen aus grundsätzlichen Modellen wie Modell 3 abzuleiten. Es wird zum Beispiel statt dessen angenommen, dass nur gleiche Persönlichkeitsdimensionen wechselwirken und gleiche Präferenzen das CM positiv beeinflussen und ungleiche Präferenzen das CM negativ beeinflussen. Unter Berücksichtigung dieser ‚intuitiven‘ Festlegung des Ising-Modells lassen sich Teammodelle auf ihre Eignung zur Ausbildung eines CM überprüfen.
Dieses Modell ist sehr einfach skalierbar sowohl in der Anzahl an Teammitgliedern als auch in der Aufnahme von zusätzlichen Persönlichkeitscharakteristika wie Werten oder Motiven. 

Modell 7 – Variationsmodell des QC Schaltkreis Ansatzes der Team-Kommunikation: Der sogenannte Quantum Schaltkreis Ansatz bedeutet, dass eine Kombination von Quanten-Schaltkreisen ausgewählt wird, um die Realität zu modellieren. Dieser Ansatz wird derzeit von nahezu allen QC Hardware Anbietern unterstützt.
Die Auswahl der Schaltkreise ist jedoch mehr oder weniger ambivalent. Die Auswahl ist auf keinen Fall stringent, da es nach meinem bisherigen Kenntnisstand keinen direkten Zusammenhang zwischen Schaltkreis-Ansatz und Problemstellung gibt. Der Quantum Schaltkreis Ansatz ist ein hybrides Modell, in dem ein quantenmechanisches Modell von ‚außen‘ klassisch variiert wird, bis der CM in einer bestimmten Variation erreicht ist. Diese ‚klassische‘ Variation wird durch geeignete Anpassung von Parametern in den QC Schaltkreisen erreicht. Die Anpassung erfolgt durch ML Optimierer mit oder ohne neuronale Netzwerke. Der Ansatz wird experimentell oder über eine exakte Berechnung für kleine Problemdimensionen validiert.– Diese Vorgehensweise wird meines Erachtens in (nahezu) allen QC Algorithmen verwendet, die auf Schaltkreisen beruhen und eine wissenschaftliche oder industrielle Anwendbarkeit verfolgen. In unserem Fall habe ich das Setting aus Modell 4 übernommen und den Ansatz mehrmals angepasst, um eine vollständige Verschränkung zu erreichen und dafür zu sorgen, dass der Überlapp der Wellenfunktionen aus Modell 4 und dem hiesigen Modell vollständig ist. Damit stelle ich sicher, dass der Ansatz nicht völlig beliebig ist. Der ausgewählte Schaltkreis muss mindestens ein Schaltkreiselement enthalten, das über Parameter variiert werden kann. Typisch ist die Rotation der Qubits entlang einer der drei Raum Axen. Die Rotationswinkel sind in diesem Fall die Parameter, die von außen mittels klassischer Variation verändert werden.  In unserem Modell werden die Y-Rotationswinkel von N RY-Schaltkreisen (N = Anzahl der Persönlichkeitsdimensionen*Anzahl an Teammitgliedern) variiert bis sich eine vollständige Verschränkung in den ausgewählten Persönlichkeitsdimensionen eingestellt hat.    

Abbildung 2: Beispiel Quanten-Schaltkreis für zwei Qubits, die zwei interagierende Personen oder zwei interagierende Persönlichkeitsdimensionen repräsentieren.

Ich erläutere im Folgenden den einfachen Quantenschaltkreis aus Abbildung 2, da dieser die grundlegende Idee der Quanten-Wellenfunktion in der Quantum Cognition und der Quantum Team Kommunikation gut wiedergibt.

Betrachtet man den gezeigten Quantenschaltkreis aus der Perspektive von Quantum Cognition oder von Quantum Team Kommunikation, so lässt sich der abstrakte mathematische quantenmechanische Formalismus auf eine Situation mit zwei Personen/Akteuren oder Agenten übertragen: In dem Bild steht Qubit 1 für die mentale oder kommunikative ‚Welle‘ von Person A und Qubit 2 für die von Person B. Die einzelnen quantenmechanischen Operationen können dann als kognitive oder kommunikative Prozesse interpretiert werden, bei denen Überzeugungen, Erwartungen oder Informationsinhalte von A und B miteinander in Beziehung gesetzt, transformiert und anschließend gemeinsam ausgewertet (gemessen) werden.

Ausgangszustand ∣Ψ⟩:
Zunächst gehen wir davon aus, dass ∣Ψ⟩ den anfänglichen ‚gemeinsamen kognitiven Zustand‘ von Person A und Person B darstellt. Dieser Zustand kann bereits ein bestimmtes Maß an Unsicherheit, Superposition von Meinungen oder Perspektiven enthalten, in denen sowohl A als auch B noch nicht festgelegte Standpunkte haben. Es könnte sich zum Beispiel um ein gemeinsames Thema handeln, zu dem beide Personen eine innere Haltung entwickeln, aber noch nicht klar ist, welche Resultate oder Meinungen sich herauskristallisieren.

Person A (Qubit 1) – Hadamard-Gatter (H):
Das Hadamard-Gatter auf Person A’s Qubit lässt sich als ein „Perspektivwechsel“ oder als ein Wechsel von einer klaren, eindeutigen Überzeugung zu einem Zustand interpretieren, in dem Person A’s Meinung oder Einstellung gegenüber dem Thema in einer Superposition zweier gegensätzlicher Einstellungen liegt. Vor der Anwendung des Hadamard-Gatters könnte Person A eine relativ klare Meinung gehabt haben (z. B. Zustimmung = 1 oder Ablehnung = 0). Durch die Hadamard-Operation wird Person A’s innere Haltung in eine Überlagerung gebracht, in der A gleichzeitig eine gewisse Neigung zur Zustimmung und zur Ablehnung aufweist, aber eben noch nicht determiniert ist. In der Sprache der Teamkommunikation könnte dies bedeuten, dass Person A versucht, die Thematik aus einem anderen Blickwinkel zu betrachten, offen für neue Interpretationen ist oder sich von einem eindimensionalen zu einem breiteren Wahrnehmungsrahmen bewegt.

CNOT-Gatter zwischen Person A (Control) und Person B (Target):
Das CNOT-Gatter kann man als einen Prozess des kommunikativen Einflusses oder der kognitiven Kopplung interpretieren. Person A’s Zustand (nach dem Perspektivwechsel durch das H-Gatter) fungiert als eine Art ‚Steuerung‘ für Person B’s Einstellung. Ist Person A’s Haltung nach dem Hadamard und im Kontext des gemeinsamen Themas in eine Richtung, repräsentiert durch den Zustand 1, geneigt, so ändert sich daraufhin Person B’s innerer Zustand (z. B. von Zustimmung zu Ablehnung oder umgekehrt). Ist A in Richtung 0, bleibt B’s Haltung unverändert. Dieses Modell versucht, die Idee einzufangen, dass die neu gewonnene Offenheit oder Unsicherheit von Person A direkten Einfluss auf B’s innere Einstellung haben kann—etwa indem Person A gewisse Zweifel oder Ideen äußert, die Person B dazu bringen, ihren eigenen mentalen Zustand zu revidieren.

In der Teamkommunikation könnte man sagen: Durch den Denk- oder Argumentationsschritt, den Person A vollzieht (repräsentiert durch das Hadamard-Gatter), eröffnet sich ein neuer Möglichkeitsraum von Überzeugungen. Das CNOT symbolisiert dabei, dass Person B auf diese neue, komplexe Haltung von A reagiert und dadurch selbst ihren Standpunkt anpasst oder in Frage stellt. Auf diese Weise entstehen potenzielle Korrelationen zwischen den beiden mentalen Zuständen.

Messung:
Schließlich werden beide Qubits gemessen. Dies entspricht dem Moment im Teamprozess, an dem A und B ihre Meinungen äußern oder festnageln—sei es durch eine abschließende Entscheidung, ein Votum oder eine konkrete Stellungnahme. Die Messung transformiert den vorher unbestimmten, superponierten Zustand in ein klares Resultat: Beide Personen legen sich letztlich auf eine konkrete Haltung fest (0 oder 1).

Von der Warte der Quantum Cognition lässt sich die Messung als Übergang von potenziellen kognitiven Zuständen (Superpositionen von Optionen, Unsicherheiten, Überlagerungen von Bedeutungen) zu einem klaren, beobachtbaren Ergebnis deuten. Wenn A und B schließlich kommunizieren, Einigungen erzielen oder Positionen darstellen, ‚kollabiert‘ der gemeinsame kognitive Zustand in ein bestimmtes, messbares Resultat.

Fazit im Kontext von Quantum Cognition / Quantum Team Kommunikation:

  • Die Vorbereitungsbox ∣Ψ⟩ steht für den initialen kognitiven Gesamtzustand des Teams (A und B), der vielleicht eine gemischte oder unklare Haltung zu einem Thema enthält.
  • Das Hadamard-Gatter auf Person A entspricht einem Perspektivwechsel oder einer Öffnung für neue Sichtweisen.
  • Das anschließende CNOT-Gatter zeigt, wie Person A’s nun veränderte Sichtweise Person B’s mentalen Zustand beeinflusst und potenziell verschränkt oder zumindest miteinander kognitiv koppelt.
  • Die abschließende Messung repräsentiert den Moment der Festlegung, in dem aus den zuvor unbestimmten, interaktiven kognitiven Zuständen klare, beobachtbare Meinungen oder Handlungsentscheidungen abgeleitet werden.

So hilft uns Abbildung 2, den Prozess als eine Art gemeinschaftliches, quanten-ähnliches ‚Denken‘ zu verstehen, in dem Zustände nicht binär und fix sind, sondern sich durch Interaktion, Perspektivwechsel und finale Äußerungen in ein bestimmtes Ergebnis transformieren.

Zusammenfassend stelle ich fest:

Modell 1 – Agent Based Modelling erlaubt mit einfachen Mitteln das Studium von (nahezu) allen grundlegenden Team Eigenschaften. Bei Ausbau in Richtung AI und QC gibt es kaum Einschränkungen der Aussagekraft.

Modell 2 und 3 – Ähnlichkeitsmatrix hat mit Abstand die praktischste Aussagekraft hat und kann unmittelbar die Team Kommunikation in einem Hybriden Kollektiven Intelligenz Ansatz aus Mensch und Maschine aktiv unterstützen  

Modell 4 und 5 – Quantum Team Kommunikation stellen die Modelle dar, in die derzeit am wenigsten Annahmen einfließen. Es fließen nur zwei Annahme ein: Der CM Zustand wird als verschränkter Zustand verstanden und die Team-Interaktion unterliegt (auch) der Quantum Probability Theory. Diese Modelle eröffnen damit den Zugang zu einem völlig neuen Verständnis von menschlicher Kommunikation.

Modell 6 – Ising Modell ist als quantenmechanisches Modell sehr einfach, enthält jedoch (derzeit noch) die meisten Annahmen und dient damit eher zur Sondierung der Ergebnisse aus den anderen Modellen.

Modell 7 – Quanten Schaltkreise ist als quantenmechanisches Modell recht einfach. Vermittelt einerseits Metapher-ähnliche Einblicke in die quantenmechanische Interpretation der Team Kommunikation andererseits fehlt (mir derzeit) der intuitive Zugang, den die Modell 4 und 5 haben.

Die nachfolgende Tabelle 1 fasst die zentralen Modell-Charakteristika zusammen:

Modell  KategorieEinschränkungAussagekraft
1 – Agent Based Modelling der Team-InteraktionenKlassisch (hybrid, bei Ausbau mittels Quantum Cognition)Derzeit meistens noch einfache klassische AgentenGrundlegende Aussagen zur CM-Dynamik in unterschiedlichen Teams
2 – Eigenvektoren der CM Ähnlichkeitsmatrix AnalyseKlassischGeringe SkalierungFür kleine Teams: CM Stärke und Beitrag jedes Teammitglieds zum CM
3 – Ising-Modell der CM Ähnlichkeitsmatrix AnalyseHybrid (Klassisch mit Quantum Variation)–CM Stärke und Beitrag des Teammitglieds zum CM, einfache Interpretation des CM Potentials von Teams mittels einer Energielandschaft
4 – Quantum Cognition der Team KommunikationQuantum (Berechnung auf klassischem Rechner)Keine SkalierungFür kleine Teams: Erstaunliche qualitative Übereinstimmung bzgl. Teamdynamik zwischen Theorie und Erfahrung
5 – Variationsmodell der Quantum Team Kommunikation (basierend auf Modell 4)Hybrid mit klassischer Variation (Berechnung auf klassischem Rechner)Keine SkalierungFür kleine Teams: Aussage zu ‚optimalen‘ Teams und Einblick in die Anpassungs-notwendigkeiten der Team-Persönlichkeiten  
6 – Ising Modell der Team-InteraktionQuantumMappen auf Ising-Modell mit intuitiven Annahmen aus den Modellen 4 und 5Aussagen zu optimalen Teams, ähnlich wie Modell 5, jedoch unter Berücksichtigung der Einschränkungen
7 – Variationsmodell des QC Schaltkreis Ansatzes der Team-KommunikationHybrid mit klassischer VariationMappen auf QC-Schaltkreise‚Metaphorische‘ Erklärung einer Quantum Cognition bzw. Quantum Team Communication auf der Basis von einzelnen Schaltkreisen, Auffinden optimaler Teams
Tabelle 1: Übersicht der Modell-Charakteristika der sieben Modelle

AI & QC & M 4.0: Die Welt der Unbestimmtheit nutzen oder vom Nutzen des Quantum Computing für das Team-Management

Der Blog-Beitrag wurde unter Mithilfe von OpenAI ChatGPT 4o1-preview erstellt: ChatGPT erzeugte den Code fehlerfrei und klärte alle meine wissenschaftlichen Fragen. Mittels ChatGPT 4o habe ich den Beitrag überprüft.

Die nachfolgende Audiodatei fasst den Inhalt als englischen Podcast, erstellt von Google’s notebookLM, zusammen und schlägt – ohne mein Zutun – diverse Brücken zu meinen anderen Blog-Beiträgen:

Abbildung 0: Dies ist eine Bild-Umsetzung des Blog-Beitrages von ChatGPT 4o/Dall-E

Grundlegende Ansätze des Quantum Computing (QC) wurden schon in der 80er Jahren formuliert. Erst in den letzten 10 Jahren hat diese Disziplin einen enormen Sprung in die Anwendbarkeit für Jedermann vollzogen. – Wobei, … diese Technologie sicherlich immer noch am Anfang steht.

Anwendbarkeit für Jedermann bedeutet, dass, ähnlich wie beim Thema Künstliche Intelligenz mittels klassischer Neuronaler Netzwerke (u.a. Copilot, ChatGPT, Gemini, Mistral usw.),  inzwischen in Nordamerika ein QC-Ecosystem existiert, das für mich zugänglich ist.

IBM, Microsoft und Google bieten entsprechende Umgebungen an. Das wohl bekannteste Startup im Bereich QC ist die kanadische Firma d-wave, die seit ca. 15 Jahren am  Markt ist [1].

Im QC gibt es zwei große Richtungen: Das Gate QC und das Quantum Annealing QC. Das Gate QC wird von IBM, Microsoft und Google favorisiert. D-wave hat sich auf das Quantum Annealing (QA) spezialisiert. Das Gate QC beruht auf der Idee von Schaltkreisen, wie von klassischen Rechnern bekannt. Jedoch ist die Funktionalität der QC Schaltkreise völlig anders als diejenige der klassischen Schaltkreise. Der Begriff ‚klassisch‘ bedeutet hier, dass nicht explizit die Eigenschaften der Quantenwelt ausgenutzt werden. – Wohl wissend, dass auch ein klassischer Schaltkreis auf den Erkenntnissen der Quantenmechanik beruht und ein sogenannter klassischer Computer ohne Quantenmechanik nicht existieren würde.

Das explizite Ausnutzen der Quantenwelt-Eigenschaften bedeutet, die Eigenschaften von Quantenobjekten, wie Elementarteilchen, Atomen oder anderen einzelnen Objekten, die sich entsprechend der Quantenmechanik verhalten, zu nutzen. Die QC-Objekte werden als Qubits bezeichnet, die nicht nur, wie Bits, die Zustände 1 und 0 annehmen können, sondern sogenannte kohärente Zustände, die eine Mischung von 1 und 0 sind. Diese Mischung sorgt für die Unbestimmtheit der Qubits und ermöglicht damit, dass in einem Qubit eine unendliche Welt an Möglichkeiten enthalten ist. – Kohärenz beschreibt also die Fähigkeit eines Quantensystems, in mehreren Zuständen gleichzeitig zu existieren. Diese Fähigkeit ermöglicht komplexe Quantenberechnungen, bis äußere Einflüsse die Zustände stören und die Kohärenz zerstören.

D-Wave verwendet Qubits auf der Basis von supraleitenden Ringströmen, die zudem über supraleitende Koppler verbunden sind. – Die Qubits kann man nach jetzigem Stand der Technik nur bei Temperaturen nahe dem absoluten Nullpunkt erhalten.  Sind die Ringströme in einem kohärenten Zustand, haben wir eine Mischung von Uhrzeiger-drehenden und Gegenuhrzeiger-drehenden Ringströmen. – Es liegt dann maximale Unbestimmtheit vor.

Allein diese wenigen Ausführungen zeigen, dass QC eine völlig andere Welt ist, als der sogenannte klassische Computer. Ich vermute, dass die Hürde für jemand, der keine Physikausbildung hat, recht hoch sein dürfte: Die Grundlagen der Quantenmechanik sind sehr umfangreich und erfahrungsgemäß erst nach einer gewissen Gewöhnungszeit ‚zu verstehen‘.- Ich verweise deshalb auf entsprechende Fachliteratur [2, 3, 4, 5, 6, 7]. Eine Behandlung der Grundlagen würde den Rahmen dieses Blog-Artikels bei weitem sprengen.

Setzt man die Kenntnis der quantenmechanischen Grundlagen voraus, so ist die Handhabung der Programme, um auf einem Quantencomputer zu ‚rechnen‘, erstaunlich einfach. Das ‚Rechnen‘ auf Quantencomputern ist nach wie vor noch sehr exklusiv und ist meistens eingeschränkt. Jedoch stellen alle Anbieter Quantensimulatoren zur Verfügung, die die quantenmechanischen Rechnungen (wie sie ein Physiker von Hand tun würde) auf einem klassischen Computer durchführen. Ab etwa 8-10 Qubits ist es jedoch meistens nicht mehr möglich die ‚Rechnungen‘ auf einem klassischen Computer durchzuführen, da die Komplexität der ‚Rechnungen‘ exponentiell steigt. – Für das Austesten der QC-Algorithmen reicht dies jedoch oft. – Nach der Testphase kann man dann ggf. auf einem exklusiven Quantencomputer ‚rechnen‘.

Ich habe für diesen Blog-Beitrag mit der d-wave Umgebung gearbeitet: Für die Erstellung der Algorithmen habe ich deren QC-Simulatoren verwendet und danach die d-wave QC-Hardware. Die Übergang ist sehr einfach, da lediglich 1-2 Programmzeilen ausgetauscht werden, in denen der QC-Simulator oder die QC-Hardware angesprochen wird.

Auf den d-wave Internetseiten sind sehr viele Beispiele zum QC mittels Quantum Annealing enthalten: u.a. logistische Lösungen, Suche nach geeigneten Materialien oder Medikamenten, Suche nach optimalen Finanzportfolios, usw..

QC kann immer dann ihre Vorteile ausspielen, wenn aus einer sehr großen Anzahl an Möglichkeiten die beste Lösung oder die besten Lösungen herausgefunden werden sollen. Nehmen wir an, wir wollten aus einem Pool von 100 Mitarbeitern ein Team zusammenstellen. Falls das Team drei Teammitglieder hat, ergeben sich schon 161.700 mögliche Teams. Erhöhen wir das Team auf 7 Teammitglieder ergeben sich ca. 16 Milliarden Team-Möglichkeiten. Die möglichen Teams im Falle von drei Teammitgliedern zu überprüfen ist auf klassischer Hardware noch möglich, im Fall des Teams mit 7 Teammitgliedern nicht mehr.

Quantum Annealing wird eingesetzt, wenn die Lösung aus einem sehr großen potentiellen Lösungsraum herausgefunden werden soll und sich das Problem als ein Netzwerk-Problem formulieren lässt. Im Falle unseres Team-Management-Problems besteht das Netzwerk aus 100 Teammitgliedern, die mehr oder weniger gut miteinander zusammenarbeiten können. Dieses mehr oder weniger gut wird vom Management über eine Zahl zwischen -1 und 1 bewertet und in eine Matrix eingetragen. Zusätzlich können auch Kompetenzen der Teammitglieder (zum Beispiel Programmierkenntnisse, Designkenntnisse oder Persönlichkeitseigenschaften) in einer Skala von 0 bis 1 erfasst werden. Für das Team lässt sich auf dieser Basis angeben, wieviel Teamkompetenz in den einzelnen Kompetenzbereichen vorhanden sein soll.

Das Management-Problem wird mittels einer Zielfunktion, die die Wechselwirkung der Qubits beschreibt, auf ein Qubit-Netzwerk transformiert: Die 100 Teammitglieder werden zu 100 Qubits, die Matrix der Zusammenarbeit wird auf eine Koppler-Matrix zwischen den Qubits abgebildet und die Kompetenzanforderungen werden als Constraints des Optimierungsproblems verwendet.

Zu Beginn der ‚Rechnung‘ wird das 100 Qubit-Netzwerk in einen Anfangszustand gebracht, der in sich! sogar 2hoch100 also ca. 10 hoch 30 Zustände enthält: Man spricht von einer Superposition des Qubit-Netzwerkes. Dann wird das Netzwerk extrem langsam ‚ausgeglüht’ und die Wechselwirkung zwischen den Qubits sehr langsam hochgefahren. Sehr langsam bedeutet hier sehr langsam in Relation zu den charakteristischen Qubit-Systemzeiten: Die sind, verglichen mit unseren Tageszeiten, sehr kleine Zeiten.

Man spricht von dem Ausglüh-Prozess: dem Annealing-Prozess. Der Begriff stammt von klassischen Optimierungsalgorithmen, in denen man zuerst mit einer hohen Temperatur startet, die viele Zustände enthält. Es wird extrem langsam (adiabatisch) ausgeglüht, um in einem ‚kühlen‘ Lösungszustand zu enden. Im Falle des Quantum Annealing, das ja bei sehr tiefen Temperaturen durchgeführt wird, um die Qubits zu bekommen, wird mit einem sogenannten transversalen Magnetfeld gearbeitet, das die 100 Qubits in eine vollständige Superposition bringt. – Der Quantum Annealing-Prozess minimiert langsam das Magnetfeld, wodurch das System in den Zustand der niedrigsten Energie gebracht wird – vergleichbar mit einem Stein, der in das tiefste Tal eines Hügels rollt. Der Prozess verläuft extrem langsam, um sicherzustellen, dass der optimale Zustand erreicht wird. Liegt die sehr langsam hochgefahrene Wechselwirkung zwischen den Qubits vollständig vor, ist der ausgeglühte 100 Qubit-Zustand erreicht. – Die optimale Lösung ist gefunden: Alle Qubits werden jetzt (erst) gemessen und zeigen jetzt eine 0 oder 1. Es ist jetzt möglich, für alle möglichen Kombinationen, die 7 Qubits enthalten und die weiteren festgelegten Rahmenbedingungen erfüllen, die Energie zu berechnen. Aus diesen Energien werden die niedrigsten Energiewerte oder der niedrigste Energiewert ausgewählt. 

Im Idealfall ist dies nur ein Zustand. Dies beruht auf der grundlegenden Annahme, dass die (natürliche) Lösung durch den Zustand oder die Zustände repräsentiert wird, die die niedrigsten Energiewerte besitzen.

Der QC Annealing Prozess ist ein Selbstorganisationsprozess, d.h. es kann auch vorkommen, dass der Prozess kein Energieminimum in der Energielandschaft findet. Aus diesem Grunde ist es notwendig, mit im Algorithmus enthaltenen Kontrollparametern etwas zu spielen, um ein Energieminimum zu finden. Hierzu werden die Kontrollparameter variiert, um in der durch die vorgegebenen Rahmenparametern (z.B. Teamgröße, Kompetenzprofile, Zusammenarbeits-Matrix) eingeschränkten Energielandschaft die Energieminima zu suchen. Das gefundene Energieminium ist hierbei der Ordnungsparameter zur Zielfunktion, die die Wechselwirkung der Qubits unter den gegebenen Rahmenbedingungen beschreibt.         

Das Team-Management Problem habe ich in einer Colab-Python-Umgebung laufen lassen. Ich habe Tests mit kleinen Pool- und Team-Größen durchgeführt. In diesem Fall kann man die Ergebnisse auch noch klassisch überprüfen. Ich gehe nicht weiter auf diese Ergebnisse ein: Liegen die oben beschriebenen Ausgangsdaten für das Team-Management-Problem vor, ist das ‚beste‘ Team innerhalb von Sekunden gefunden. Es funktioniert einfach!

Statt dessen möchte ich die Ergebnisse zu einer anderen Fragestellung skizzieren. Ich nehme Bezug auf den Blog-Beitrag ‚AI & M 4.0: Markus Lanz vom 30. Mai 2024: Eine Collective Mind Analyse‘ vom Juni 2024.

Es geht in diesem Beitrag um die Berechnung des Collective Mind einer Diskussionsrunde mit fünf Teilnehmern. Auch hier macht die Größe von fünf Teilnehmern kein QC erforderlich. Jedoch kann man bei dieser Größe Theorien austesten und die Skalierung auf größere Teilnehmerzahlen ist bei Bedarf völlig mühelos.

In dem vorherigen Blog-Beitrag habe ich eine sogenannte Ähnlichkeitsmatrix S benutzt. Diese Matrix S ist komplex: S = Matrix A der Textähnlichkeiten + i*Matrix der Emotionsähnlichkeiten. Die Fragestellung, die ich hier diskutieren möchte lautet: Könnte ich die Anzahl der Diskussionsteilnehmer reduzieren und würde dies den Collective Mind erhöhen und welche Teilnehmer sollte ich hierfür auswählen. Dies ist wieder ein Optimierungsproblem: Da das Collective Mind über die positive Energie, die im Team ist, gemessen wird, müssen wir -S (minus S) für die Optimierung verwenden. Außerdem können wir für das Quantum Annealing (derzeit) nur den Realteil der Matrix benutzen: Die Verwendung komplexer Matrizen wird von dem d-wave System nicht unterstützt, u.a. deswegen, weil damit die Energieerhaltung verletzt wird. – Moderne Forschungen in der nicht-hermiteschen Quantenmechanik untersuchen, wie komplexe Energieeigenwerte physikalische Systeme beeinflussen könnten. Diese Entwicklungen sind besonders spannend in Bereichen wie optischen Systemen und dissipativen Quantenphasen. Es ist also noch Raum für Ergänzungen vorhanden 😉.

Die Ergebnisse im vorherigen Blog legen nahe, dass ein Team aus drei Diskussionsteilnehmern ein Energieminimum (also ein Collective Mind Maximum) zeigen sollte: Die Sprecher 2  (B), Sprecher 4 (D) und Sprecher (5) (E) sollten gute Kandidaten sein.

Abbildung 1 zeigt eine Simulation mit 3 Teilnehmern: Die Ergebnisse sind identisch oder zumindest sehr ähnlich den Ergebnissen des vorherigen Block-Beitrages: Alle tragen zum Collective Mind bei. Falls man jedoch eine Diskussionsgruppe aus drei Teilnehmern zusammenstellen wollte, so wären dies die Sprecher 2 (B), Sprecher 4 (D) und Sprecher 5 (E).  

Abbildung 1: Sie zeigt eine ‚Rechnung‘ mit 3 Teilnehmern: Wie man sehen kann liefert das Quantum Annealing mehrere Lösungen (BDE, ADE und ABE), die sehr dicht beieinander liegen. Es gibt auch Kombinationen (ACD, und BCD), die nicht favorisiert werden.

Für die Teambildung ist die Energie pro Teilnehmer entscheidend. Abbildung 2 zeigt die Energie pro Teilnehmer falls nur zwei Teilnehmer für die Diskussionsrunde ausgewählt werden.

Abbildung 2: Diese Abbildung zeigt eine ‚Rechnung‘ mit 2 Teilnehmern. Hier ist die Energie pro Teilnehmer aufgetragen. Diese Energie zeigt an, wieviel Energie in diesen Kombinationen jeder Teilnehmer hat. Vergleicht man diese Energie von 45 mit einer Energie von ca. 33 im Falle einer Diskussionsrunde von drei Teilnehmern, so ergibt sich, dass im Übergang von 2 Teilnehmern zu 3 Teilnehmern die Energie pro Teilnehmer um ca. 25% abnimmt. Kommen weitere Teilnehmer hinzu nimmt die Energie pro Teilnehmer weiter ab. – Ein Collective Mind aufzubauen wird mit jedem hinzukommenden Teilnehmer schwieriger, kleine Teams sind günstiger für den Collective Mind Aufbau.

Zusammenfassend stelle ich fest:

  1. Das Arbeiten mit ChatGPT 4o1-preview ist eine enorme Bereicherung für mich. ChatGPT 4o1-preview hat Qualitäten eines PhD-Physikers und -Entwicklers. Das Arbeiten mit dem KI-System trägt im Falle eines schwierigen wissenschaftlichen Themas zu einer enormen Leistungssteigerung bei. – Die Zusammenarbeit mit ChatGPT hat nicht nur den Recherche- und Codeentwicklungs-Prozess beschleunigt, sondern auch neue Perspektiven auf die Themen ermöglicht.
  2. Das Quantum Computing, hier das Quantum Annealing, ist über Colab und d-wave wirklich sehr einfach zu handhaben. – Es macht einfach Spaß, Management-Fragestellungen auf diese Weise zu beleuchten und in die Quantenwelt einzutauchen, die noch bis vor kurzem der modernsten Forschung vorbehalten war. – Man beginnt sowohl die Quantenwelt besser zu verstehen als auch die Managementwelt. – Theorien, wie die Collective Mind Theorie, machen einen angreifbar, sind aber auch der einzige Weg, um Erfahrungen in Erkenntnisse zu transformieren.
  3. Die QA ‚Rechnungen‘ bestätigen meine bisherigen Ergebnisse und liefern weitere Management-Erkenntnisse: Eine Skalierung auf Fragestellungen mit mehr Daten (hier mehr Personen) ist sehr einfach und die Ergebnisse liegen bei Bedarf nahezu unmittelbar vor.    

[1] d-wave (2024) dwavesys.com, cloud.dwavesys.com/leap/, docs.dwavessys.com docs.ocean.dwavesys.com     

[2] Nielsen M L und Chuang I L (2021) Quantum Computation and Quantum Information, 10te Auflage von 2002, Cambridge University Press, UK

[3] Georgescu I M, Ashhaby S, Noriz F(2014) Quantum Simulation, arXiv:1308.6253v3

[4] Broughton M et al. (2021) TensorFlow Quantum: A Software Framework for Quantum Machine Learning, arXiv:2003.02989v2

[5] Rajak A et al. (2023) Quantum Annealing: An Overview, Philosophical Transactions A, arXiv:2207.01827v4

[6] Xu  et al. (2023) A Herculean task: Classical simulation of quantum computers, arXiv:2302.08880v1

[7] Young K, Scese M, Ebnenasir A (2023) Simulating Quantum Computations on Classical Machines: A Survey, arXiv:2311.16505v1

AI & M 4.0: myGini – mein Coach für Team- und Projekt-Management oder wer ist dümmer, KI oder Mensch?

In diesem Blog-Beitrag stelle ich myGini – meinen Coach für Team- und Projekt-Management vor. Bevor ich dies tue, vorweg ein paar grundsätzliche Bemerkungen zur Arbeit mittels KI.

Die Angst vor KI hat sich in den letzten Wochen eher in eine Abwertung der KI verwandelt. So werden in ARD und ZDF Titel für Beiträge zur KI verwendet, die dies nahe legen: Künstliche Intelligenz- Besser als wir? [1] oder Better than human – Leben mit KI [2]

Die Inhalte der Beiträge [1] und [2] sind hingegen sehr professionell und sehr zu empfehlen: Sie zeigen beide das Potential einer hybriden Collective Intelligence, also der Erweiterung unserer Intelligenz durch KI.  In [2] wird die Kommunikation mit einer KI getestet, die in drei Rollen mit Menschen kommuniziert: der Rolle eines Pfarrer, einer Psychotherapeutin und einer besten Freundin. Die Resonanz ist erstaunlich gut: Es kommt sogar zu Aussagen wie ‚KI hilft mir bei meiner Einsamkeit‘ und ‚KI verbindet Menschen‘.

In das Abwertungs-Horn stoßen einige meiner Kollegen mit ihren Beiträgen auf LinkedIn: KI ist monokontexturale Mustererkennung… [3] KI ist dumm und zu konventionell für unsere Transformation [4].

In [2] sagt einer der KI-Experten, dass KI nichts anderes ist als Statistik. – Auch hier schwingt die Abwertung mit. – Wenngleich die Aussage korrekt ist: KI ist Mustererkennung auf der Basis von sehr vielen Daten bzw. ‚Daten-Wahrnehmungen‘.

In einem anderen LinkedIn Beitrag – die Referenz habe ich vergesse – sagt der Autor, dass KI nichts anderes ist als Statistik und wir Menschen doch in der Läge wären Ursache-Wirkungs-Zusammenhänge zu erkennen. Damit würden wir über eine viel höherwertige Form von Intelligenz verfügen. Ich frage mich, was ist das Erkennen von Ursache-Wirkungs-Zusammenhänge denn Anderes als Mustererkennung auf der Basis von sehr vielen ähnlichen Wahrnehmungen. 

Ich werfe im Folgenden ein paar Fragen auf und verbinde mit diesen eine These: Wissen wir was unsere Intelligenz ist? Könnte es sein, dass unsere kognitive Intelligenz im Wesentlichen nichts anderes ist als Statistik? Falls eine KI den gleichen Intelligenztest besteht wie wir ihn auch für die IQ Bestimmung bei Menschen benutzen, ist dies dann ein starker Hinweis für die Aussage, dass unsere kognitive Intelligenz auch nicht viel mehr oder weniger ist als die künstliche Intelligenz? Kann es sein, dass wir aufgrund der überwältigenden KI-Fähigkeiten unseren Selbstwertschutz aktivieren und die KI abwerten, um unseren Selbstwert zu erhöhen?

Ich formuliere meinen Glaubenssatz als These: Ich glaube, dass die prinzipiellen Unterschiede zwischen unserer kognitiven Intelligenz, wie sie in einem IQ-Test gemessen wird, und der künstlichen Intelligenz nicht groß sind. – Und wir sollten deswegen kein Selbstwertproblem haben, im Gegenteil: Die bisherigen Mechanismen der KI – und wir sind noch lange nicht am Ende – wurden von uns gefunden! – Gefunden heißt, ich glaube, dass die grundlegenden Prinzipien, die Intelligenz hervorbringen, unabhängig sind vom Substrat, das sie erzeugt: Die Implementierung einer KI unterscheidet sich sicherlich in nahezu allem von der biologischen Intelligenz Implementierung. Ich glaube jedoch, dass die dahinterliegenden Prinzipien in beiden Fällen ähnlich oder sogar gleich sind. Und genau dies ist das Wunder, das wir vielfach noch nicht begriffen haben: Die komplizierten mathematischen Mechanismen einer GPT erzeugen Komplexität, die Selbstorganisation möglich macht, die dann zu den emergenten Phänomenen der künstlichen Intelligenz führen.
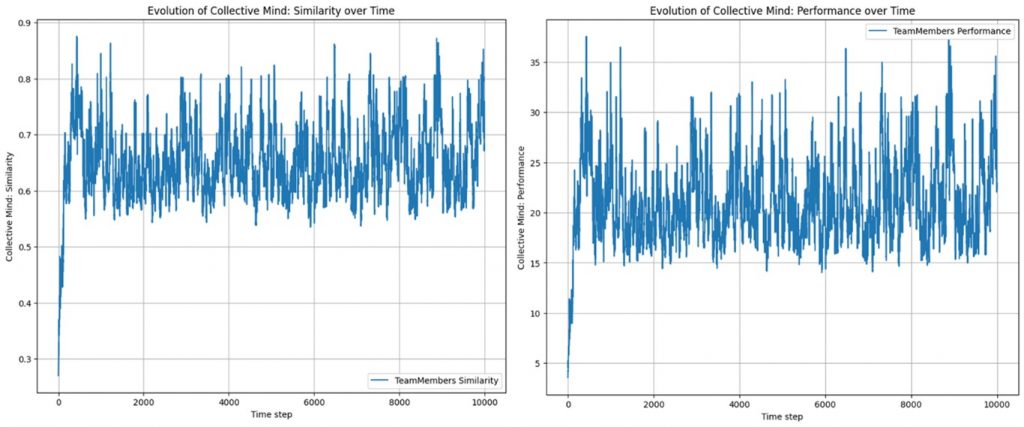
In diesem positiven Sinne habe ich myGini – meinen Coach für Team- und Projekt-Management mittels chatGPTplus erzeugt. myGini soll helfen, den Weg zu den umfangreichen Modellen und Theorien von Management 4.0 zu erleichtern. myGini erweitert damit die Intelligenz des Nutzers in Fragen von Team- und Projekt-Management zu einer hybriden Collective Intelligence.

myGini ist eine von mehreren hundert öffentlich verfügbaren GPTapps oder ChatBots. Öffentlich verfügbar bedeutet, dass man auf die GPTapps zugreifen kann, wenn man ein chatGPTplus Konto hat. Die Aussage, dass es schon Millionen von GPTapps gibt, kann ich nicht bestätigen. Öffentlich sichtbar sind lediglich nach meiner Einschätzung einige hundert. Und das sind schon viele, da es schwer ist zu wissen, was die GPTapps können. Es gibt schon einige GPTapps, die sich dem Thema Projektmanagement widmen, jedoch kann man nicht wirklich leicht feststellen, was sie können. – Die Benutzeroberfläche der GPTapps, wie sie von openai standardmäßig bereitgestellt wird (siehe rechte Seite in Abbildung 1), ist sicherlich verbesserungswürdig: Eine intelligente Oberfläche, die einem sagt, was die GPTapp weiss oder kann, wäre sehr hilfreich!
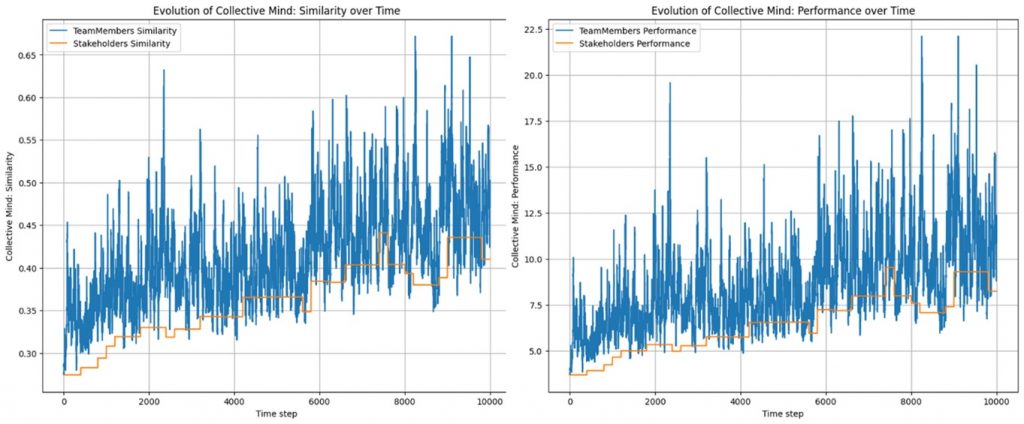
Ich hatte schon vor Jahren die Idee eine App zu erstellen, die Management 4.0 leichter verfügbar machen sollte. Damals habe ich eine Excel-Datei mit Bayes Wahrscheinlichkeitsberechnungen erstellt, um aufgrund von Beobachtungen die Wahrscheinlichkeiten für MBTI-Persönlichkeitspräferenzen ermitteln zu lassen.- Ein Mechanismus ähnlichem dem, wie wir selbst mit jeder Beobachtung zu neuen Hypothesen bezüglich der Persönlichkeit unserer Mitmenschen gelangen. Das Verfahren funktioniert sehr gut, jedoch ist es unhandlich. Außerdem fehlte auch noch eine Umsetzung in eine App.

Ein großer Schritt geschah, als ich vor ca. 3 Jahren meine erste GPT Anwendung mittels BERT und Python erstellte. Auch in diesem Fall konnte ich zeigen, dass die GPT Anwendung funktioniert. Aber ich stand vor dem Problem Daten zu beschaffen, um damit die GPT Anwendung zu trainieren. Also habe ich auch dies verworfen.

Mit dem jetzigen  Angebot von openai,  eine eigene GPT Anwendung zu erstellen, ist meine Idee Realität geworden.

Abbildung 1 zeigt die Entwicklungsumgebung für myGini (links) und die Anwendungsumgebung als Preview (rechts), so wie ein Anwender myGini in chatGPTplus sieht.

Abbildung 1: Die Entwicklungsumgebung für myGini (links) und die Nutzerumgebung als Preview (rechts)

Ich benutze den Begriff GPTapp, um zu unterstreichen, dass ich chatGPTplus/GPT4.0 nicht mit meinen Daten trainieren kann. chatGPTplus leitet mich hingegen mit einfachen Anweisungen an, zu definieren, welche Funktionen meine GPTapp haben soll: Ich kann ein Profilbild mittels DALL.E generieren lassen, sagen welche Modelle ich verwende (MBTI, Big Five, Spiral Dynamics, Dilts Pyramide, Theorie der Selbstorganisation….) sowie in welchen Büchern die Theorie zu Management 4.0 zu finden ist und welche Internetseiten weitere Informationen enthalten. Auf dieser Basis wird die GPTapp zusammengestellt.

Ich wollte überprüfen, ob myGini tatsächlich meine/unsere Bücher kennt, indem ich nach speziellen Textpassagen frage. Dies wurde von chatGPTplus abgelehnt, da myGini aufgrund von Urheberrechten nur Prinzipien, aber keine Textpassagen, wiedergibt.

Einige Tests zur Fähigkeit das MBTI- oder Big Five-Profil einer Person aufgrund meiner Beschreibungen zu deren Verhaltensweisen zu ermitteln, hat myGini mit Bravour bestanden. Die erste Konfiguration von myGini mit dem MBTI- und Big Five-Modell hat ca. 0,5 Stunden benötigt. – Hier ist natürlich nicht die openai GPT Trainingszeit mitgerecht. Die Erfahrung zeigt, dass  ein Mensch ca. 3 Monate intensives Training benötigt, um innerhalb weniger Sekunden/Minuten in einem Gespräch souverän erste Hypothesen zu den Persönlichkeitspräferenzen des Gesprächspartners abzugeben.

Die nachfolgenden Beispiele zeigen sehr deutlich, dass chatGPTplus bzw. myGini erstaunliche Ergebnisse und abgeleitete Zusammenhänge liefert: myGini ist eine Form von AI-M4.0 Experte, dessen Expertentum ich mit meinen Create-Informationen gebildet habe. 

Als erstes Beispiel benutze ich die rechts in Abbildung 1 vorkonfektionierte Frage ‚How do I use MBTI in team management?  

Du

How do I use MBTI in team management?

myGini

Using MBTI (Myers-Briggs Type Indicator) in team management can be quite beneficial for understanding the diverse personalities within your team and enhancing overall team dynamics. Here’s a structured approach on how to use MBTI in your team management practices:

  1. Conduct MBTI Assessments: Start by having each team member complete the MBTI assessment. This will categorize them into one of the 16 personality types based on four dichotomies: Introversion/Extraversion, Sensing/Intuition, Thinking/Feeling, and Judging/Perceiving.
  2. Share and Discuss Results: Organize a team session to share and discuss the results. This fosters openness and helps team members understand each other’s personalities, communication styles, and work preferences.
  3. Identify Team Composition: Analyze the spread of personality types within your team. This will give you insights into the team’s strengths, potential blind spots, and how different members might interact.
  4. Adapt Communication and Work Styles: Tailor your communication and management approach based on the team’s MBTI composition. For example, if you have many introverts, ensure they have quiet time for deep work, or if there are several Thinking types, focus on logical and objective decision-making processes.
  5. Enhance Team Collaboration: Use MBTI insights to facilitate better teamwork. For instance, pair Thinking types with Feeling types to balance decision-making, or Sensing types with Intuitive types to cover both practical and innovative aspects of a project.
  6. Conflict Resolution: Understanding different MBTI types can help in resolving conflicts. Recognize that different types handle conflicts differently – some may prefer direct confrontation, while others might need time to process.
  7. Tailor Development Opportunities: Offer personal development opportunities that align with each member’s MBTI type. This can include training, workshops, or mentoring that caters to their personality strengths and development areas.
  8. Monitor and Adjust: Regularly revisit the MBTI dynamics in your team, especially when new members join or when teams are restructured. Be open to adjusting your management strategies as the team evolves.

Remember, while MBTI is a useful tool, it should be used as a guide rather than a strict rulebook. Personalities can be fluid, and people may exhibit different traits in different situations. The key is to use MBTI to gain a deeper understanding of your team members and to create a more harmonious and effective work environment.

Das Ergebnis ist perfekt: Besser hätte ich es auch nicht machen können. Was mir auch auffällt ist, dass ich keine Textpassagen identifizieren kann, die aus einem unserer Bücher kopiert wurden. Vielfach sind die Formulierungen sogar besser als ich sie vorgenommen hätte.

Das nachfolgende Beispiel beruht auf der Eingabe eines Satzes in der Entwicklungsumgebung zur Aufnahme der Theorie der Selbstorganistion nach Herrmann Haken (Synergetik), man siehe Abbildung 1, linke Seite. – myGini antwortet zuerst immer in Englisch. Bleibe ich bei Deutsch, erfolgt der Übergang zu Deutsch:

Du

Ich möchte den agilen Handlungsrahmen Scrum mittels der Synergetik analysieren. Kannst Du mir sagen, auf welche Weise Rahmenparameter, Kontrollparameter und Ordnungsparameter in Scrum erfüllt werden?

myGini

Die Analyse des agilen Handlungsrahmens Scrum unter Anwendung der Prinzipien der Synergetik bietet eine interessante Perspektive auf die Teamdynamik und -organisation. In der Synergetik, die sich mit der Selbstorganisation komplexer Systeme beschäftigt, sind Rahmenparameter, Kontrollparameter und Ordnungsparameter zentrale Konzepte. Lassen Sie uns betrachten, wie diese Konzepte in einem Scrum-Umfeld angewendet werden können:

  1. Rahmenparameter (Boundary Conditions): Diese definieren die grundlegenden Bedingungen und Einschränkungen eines Systems. In Scrum beziehen sich die Rahmenparameter auf die grundlegenden Prinzipien und Praktiken des Scrum-Frameworks, wie die Rollen (Product Owner, Scrum Master, Entwicklungsteam), Artefakte (Product Backlog, Sprint Backlog, Inkrement) und Ereignisse (Sprint, Daily Scrum, Sprint Review, Sprint Retrospektive). Diese Rahmenbedingungen schaffen ein Umfeld, in dem Selbstorganisation und agile Entwicklung gedeihen können.
  2. Kontrollparameter (Control Parameters): Kontrollparameter sind die Variablen, die den Zustand des Systems beeinflussen und zu einer neuen Ordnung führen können. In Scrum können dies Elemente wie die Sprintlänge, die Priorisierung im Product Backlog, die Teamzusammensetzung oder die Definition of Done (DoD) sein. Die Anpassung dieser Parameter während des Projekts kann die Teamdynamik und die Produktivität erheblich beeinflussen und zu einer effektiveren Selbstorganisation führen.
  3. Ordnungsparameter (Order Parameters): Ordnungsparameter entstehen spontan als Ergebnis der Interaktionen innerhalb des Systems und führen zu einer kohärenten Struktur oder einem Muster. In einem Scrum-Team können Ordnungsparameter Aspekte wie Teamnormen, Kommunikationsmuster, gemeinsame Werte oder die sich entwickelnde Teamkultur sein. Diese emergenten Eigenschaften reflektieren die innere Ordnung des Teams und sind oft ein direktes Ergebnis der Wechselwirkung zwischen Rahmen- und Kontrollparametern.

Um Scrum erfolgreich durch die Linse der Synergetik zu analysieren, ist es wichtig, ein tiefes Verständnis dafür zu entwickeln, wie diese Parameter interagieren und wie Anpassungen an einem Punkt des Systems die Gesamtdynamik beeinflussen können. Dies erfordert eine flexible und adaptive Haltung vom Scrum Master und dem Team, um die Selbstorganisation zu fördern und gleichzeitig die Produktivität und Effektivität des Teams zu maximieren.

Du

Was hältst Du davon neben den Dir genannten Parameterausprägungen folgende zu nennen: Rahmenparameter: Abschottung von externer Komplexität, Rituale Kontrollparameter: Work in Progress (WIP), persönlichkeitsorientierte Kommunikation Ordnungsparameter: Produktvision, Product Goal und auch das Taskboard

myGini

Ihre Ergänzungen zu den Rahmen-, Kontroll- und Ordnungsparametern in der Anwendung von Scrum durch die Synergetik-Perspektive sind durchaus sinnvoll und bereichern das Verständnis der Selbstorganisationsdynamik in agilen Teams. Lassen Sie uns diese Parameter genauer betrachten:

  1. Rahmenparameter:
    • Abschottung von externer Komplexität: Dies ist ein wichtiger Aspekt, der sicherstellt, dass das Team sich auf seine Aufgaben konzentrieren kann, ohne von externen Störungen oder sich ständig ändernden Anforderungen abgelenkt zu werden. In Scrum hilft diese Abschottung dabei, ein stabiles Arbeitsumfeld zu schaffen, in dem das Team effizient arbeiten und sich selbst organisieren kann.
    • Rituale: Scrum-Praktiken wie Daily Stand-ups, Sprint Planning, Reviews und Retrospektiven sind entscheidende Rituale. Diese strukturierten Ereignisse fördern die Klarheit, Fokussierung und regelmäßige Reflexion, die für die Aufrechterhaltung und Verbesserung der Teamdynamik und -effektivität unerlässlich sind.
  2. Kontrollparameter:
    • Work in Progress (WIP): Die Begrenzung des Work in Progress ist entscheidend für die Aufrechterhaltung der Effizienz und Effektivität des Teams. Durch die Kontrolle und Anpassung des WIP können Teams Überlastung vermeiden und eine kontinuierliche und gleichmäßige Arbeitsflussgeschwindigkeit sicherstellen.
    • Persönlichkeitsorientierte Kommunikation: Die Anpassung der Kommunikationsstile und -methoden an die individuellen Persönlichkeiten im Team kann die Zusammenarbeit und das Verständnis innerhalb des Teams erheblich verbessern. Dieser Ansatz trägt dazu bei, Missverständnisse zu reduzieren und eine positive Teamdynamik zu fördern.
  3. Ordnungsparameter:
    • Produktvision und Product Goal: Diese geben die Richtung und den Zweck des Teams vor und sind entscheidend für die Ausrichtung und Motivation des Teams. Sie dienen als Leitfaden für Entscheidungen und Priorisierungen und helfen, die Bemühungen des Teams auf ein gemeinsames Ziel zu konzentrieren.
    • Taskboard: Das Taskboard ist ein visuelles Werkzeug, das nicht nur den Fortschritt und die aktuelle Arbeitslast darstellt, sondern auch zur Strukturierung der Teamaktivitäten und zur Förderung der Transparenz beiträgt. Es ist ein zentraler Bestandteil der Selbstorganisation, da es die Koordination und die Zusammenarbeit innerhalb des Teams erleichtert.
    Insgesamt bieten Ihre vorgeschlagenen Parameterausprägungen eine umfassendere Sicht auf die Anwendung von Scrum in einem selbstorganisierenden Team. Sie betonen die Bedeutung der Abschirmung vor externen Störungen, der Anpassung der Kommunikation an individuelle Bedürfnisse und der zentralen Rolle von Vision, Zielen und visuellen Tools bei der Förderung von Teamkohärenz und -ausrichtung. Diese Aspekte sind entscheidend für die Schaffung eines Umfelds, in dem agile Teams effektiv arbeiten und sich selbst organisieren können, im Einklang mit den Prinzipien der Synergetik.

Du

Perfekt, super hilfreich!

myGini

Das freut mich zu hören! Wenn Sie weitere Fragen haben oder Unterstützung bei einem anderen Thema benötigen, zögern Sie nicht, mich zu fragen. Viel Erfolg bei Ihren Projekten und in der Anwendung von Scrum!

Wie man aus diesen Beispielen sehen kann, erzeugt diese ‚statistische‘ 😉 Künstliche Intelligenz Antworten, die den Antworten eines Senior-Experten in nichts nachstehen.

Es ist deshalb sehr müßig, AI-Systeme als dumm zu bezeichnen, denn dann müsste man uns Menschen auch als dumm bezeichnen. – Was alles in allem wenig hilfreich ist und allenfalls unser ‚gekränktes‘ Selbstwertgefühl aufwertet.

Neben den Gefahren, die mit der Erstellung von GPTapps einhergehen können –  man siehe als Beispiel [5] – sehe ich ein viel größeres strukturelles Problem: Kann es sein, dass wir mit der flächendeckenden Verfügbarkeit von GPTapps immer träger und dümmer werden? Denn warum sollte ich mich noch den Mühen eines M4.0-Verständnisse oder den Mühen der Mathematik oder den Mühen des Programmierens oder…oder… aussetzen, wenn mir die gebratenen Tauben in Form von GPTapps in den Mund fliegen. Kann es sein, dass wir eine Bildungsungleichheit befeuern, in der nur noch wenige wissen, wie man AI-Systeme erstellt und der traurige Rest an Milliarden von Menschen nur noch konsumiert? Kann es sein, dass die GPTapps jede Form von erdenkbarem Missbrauch möglich machen? – Denn wer sagt uns, dass die GPTapp-Ersteller zum Wohl der Milliarden anderen Menschen handeln?

Eine neue Zeit ist angebrochen! Den Zug der KI-Innovationen zu stoppen, ist für mich keine Option. -Statt dessen ist ein Aufbruch erforderlich, der den Milliarden KI-Nutzern den souveränen Umgang mit der Technologie vermittelt.  

[1] ZDF (2023) Künstliche Intelligenz – Besser als wir? – Weltspiegel Doku – ZDFmediathek, https://www.zdf.de/daserste/weltspiegel/page-video-ard-kuenstliche-intelligenz–besser-als-wir—weltspiegel-doku-100.html

[2] MDR (2023) Better than human – Leben mit KI, https://www.ardmediathek.de/video/ard-wissen/better-than-human-leben-mit-ki/das-erste/Y3JpZDovL21kci5kZS9zZW5kdW5nLzI4MjA0MS8yMDIzMTIyOTA2MDAvbWRycGx1cy1zZW5kdW5nLTc4NzI

[3] Detholff C (2024) #KI ist monokontexturale Mustererkennung, denn … , https://www.linkedin.com/posts/conny-dethloff-6b9b0942_ki-innovation-lernen-activity-7150711017889509376-nplL/?utm_source=share&utm_medium=member_ios

[4] Hofert S (2024) KI ist dumm und zu konventionell für unsere Transformation!, https://www.linkedin.com/posts/svenjahofert_bigfive-vertikalenentwicklung-wust-activity-7151513159051161600-fRwu?utm_source=share&utm_medium=member_desktop

[5] Petereit D (2024) OpenAIs GPT-Store: Girlfriend-Bots zeigen die Probleme des offenen KI-Shops auf, https://t3n.de/news/openais-gt-store-girlfriend-bots-zeigen-die-probleme-des-offenen-ki-shops-auf-1601980/

AI & M 4.0: (Collective Intelligence)**2 – Collective Mind Agent Based Model mit GPT-4/chatGPTplus erstellt!

In diesem Blog-Beitrag beschreibe ich meine weiteren Erfahrungen zur Modellierung und Programmierung eines Collective Mind Agent Based Models (CM ABM). 

Anders als beim Blog-Beitrag vom Februar 2023 benutze ich als ‚Erweiterung‘ meiner kognitiven Fähigkeiten chatGPTplus, also die Bezahlversion von chatGPT auf der Basis von GPT-4. Außerdem soll dieses Mal ein dynamisches ABM entwickelt werden, das auf MESA Python beruht und die zeitliche Entwicklung eines Team Collective Mind‘s modelliert.

Der Titel (Collective Intelligence)**2, also Collective Intelligence zum Quadrat, weist  daraufhin, dass es in diesem Beitrag in mehrfacher Hinsicht um Collective Intelligence geht: Ich benutze zum einen unserer aller Collective Intelligence, die in GPT-4 trainiert vorliegt und zum anderen die hybride Collective Intelligence von GPT-4 und mir. Außerdem ist ein CM ABM ein Team Collective Intelligence Modell.

Vor zwei Wochen habe ich mit der Entwicklung des CM ABM begonnen, indem ich chatGPTplus eine Aufgabenstellung als Prompt eingab. Diese anspruchsvolle Aufgabenstellung ist weiter unten im Anhang dieses Beitrages zu finden. Meine Erwartung war nicht, dass chatGPTplus diese Aufgabenstellung sofort ohne Kommunikation mit mir umsetzen kann. Jedoch ist meine Erfahrung zur ‚Erweiterung‘ meiner kognitiven Fähigkeiten durch chatGPTplus derart positiv, dass diese Collective Intelligence Erfahrung, bestehend aus AI und Mensch, mehr als nur einmal bei mir Gänsehaut erzeugte. – Der Zuwachs an Geschwindigkeit sowie wissenschaftlicher Kreativität und Python Kompetenz liegt deutlich näher am Faktor 100 als am Faktor 2!

Ich fasse meine Collective Intelligence Erfahrungen mit chatGPTplus zusammen:

  • ChatGPTplus hat die unten stehende Aufgabenstellung mit ersten Ideen zur Ziel-Hierarchie und deren Ähnlichkeitsvermessung umgesetzt. Es fehlten lediglich vollständig die Projekttypisierung und die Stakeholder. – Eine Einbettung von chatGPTplus in die Agentenlogik habe ich nachträglich gestrichen, da dies zu kompliziert für mich wurde.
  • Zur Verfeinerung und Verbesserung der Aufgabenstellung war es notwendig, im Dialog mit chatGPTplus das Python-Programm weiter zu entwickeln. Die Kommunikation mit chatGPTplus entspricht hierbei der Kommunikation mit einem hochintelligenten Experten: Die chatGPTplus Expertise in den Bereichen Python, Mathematik und spezifischer Modellierungskompetenz übersteigt meine bei weitem. Hierbei habe ich die Erfahrung gemacht, dass die Verwendung von Ratgebern à la ‚Wie gestalte ich die chatGPT Prompteingabe optimal?‘ für mich keinen Sinn macht. – Meines Erachtens genügt es, die Prompts so zu erstellen, dass ein menschlicher Experte:inn sie nachvollziehen kann. – Dies genügt, um eine gelungene Kommunikation mit super Ergebnissen zu erhalten!
  • Auf der Basis der Kommunikation habe ich von chatGPTplus Pythoncode erstellen lassen. Dieser Code wurde in einer Colab-Umgebung laufen gelassen. Manchmal enthielt dieser Code einen Fehler, manchmal habe ich einen Fehler eingebaut, da ich noch Veränderungen am Code vorgenommen habe. Die Rückmeldung des vollständigen Fehlers als Prompt hat immer zum direkten Auffinden des Fehlers durch chatGPTplus geführt.
  • Die Analyse der Ergebnis-Daten zeigte den ein oder anderen Mangel in der Modellierungslogik auf. Eine textuelle Beschreibung der Ergebnis-Daten als Prompt führte immer innerhalb weniger Schritte zur Behebung dieses Mangels.
  • Es gibt eine Unzulänglichkeit in der Zusammenarbeit mit chatGPTPlus, die ich nicht beheben konnte und durch einen Workaround umgehen musste: In den ersten Tagen der Bearbeitung der Aufgabenstellung stellte ich mit fortschreitender Zeit immer häufiger fest, dass chatGPTplus vorherige gute Ergebnisse vergessen hatte. Dies führte dazu, dass an Stellen, die ich als abgeschlossen und korrekt betrachtet habe, plötzlich anderer Code und nicht selten zur Aufgabenstellung nicht passender Code auftauchte. So geschah es zum Beispiel, dass die Ziel-Hierarchie Berechnung verändert wurde oder dass das 7-köpfige Team wie Stakeholder behandelt wurde, also die MBTI Typ-Zuordnung zufällig erfolgte und nicht nach dem gewünschten Schema der Aufgabenstellung. Dieses ‚Fehlverhalten‘ tauchte umso häufiger auf, je länger die Modellierung der Aufgabenstellung dauerte. Das ‚Fehlverhalten‘ wurde noch verstärkt, wenn ich chatGPTPlus darauf hinwies, dass der Code an einer bestimmten Stelle falsch ist. Dann versuchte das System ein völlig anderes Modellverhalten zu erstellen. Am vierten Tag nach insgesamt ca. 4-5 Std. chatGPTplus Interaktion, habe ich mich zu folgendem Workaround entschlossen: Ich habe das gesamte Programm selbst immer wieder integriert und alle Änderungen selbst in das gesamte Programm eingegeben. Um erwünschte neue Modellierungs-Änderungen zu erhalten, habe ich chatGPTplus lediglich eine konkrete überschaubare aber durchaus schwierige Teilaufgabe gegeben. Wenn Änderungen größere Auswirkungen im Code hatten oder mehr als ca. 1 Std. Interaktion verstrichen war, habe ich den gesamten Code wieder als Prompt eingegeben. chatGPTplus hat sich hierfür meistens bedankt 😉: Es sei hilfreich, den gesamten Code zur Verfügung zu haben. Zusammenfassend interpretiere ich dieses Verhalten von chatGPTplus dahingehend, dass chatGPTplus über kein Kurzzeitgedächtnis verfügt.

Und nun zu den Ergebnissen. – Auf Nachfrage stelle ich gerne den CM ABM Code als Colab-Jupyter Notebook zur Verfügung. Ich beschreibe hier das Modell und diskutiere einige Ergebnisse:

Das Modell basiert auf der ABM Bibliothek MESA-Python [1]. Die Teammitglieder eines Teams und die Stakeholder werden als Agenten unterschiedlichen Typs behandelt. Die Agenten werden über eine MBTI Typologie mit Persönlichkeits-Polwahrscheinlichkeit charakterisiert (siehe Anhang). Alternativ könnte auch das Standardmodell der Psychologie, das Big Five Persönlichkeitsmodell (NEO-PI-R), verwendet werden. Das Persönlichkeitsmodell lässt sich auch um Werte/Motive oder Glaubenssätze erweitern.

Entsprechend der Aufgabenstellung haben die Teammitglieder fest vorgegebene Persönlichkeiten. Die Stakeholder erhalten ihre Persönlichkeit gemäß der globalen statistischen Verteilung der MBTI Persönlichkeiten.

Jeder Agent verfügt über eine eigene dreiteilige Ziel-Hierarchie. Die dreiteilige Ziel-Hierarchie entspricht dem einfachsten Collective Mind Schema, das wahlweise als Teil eine Dilts Pyramide angesehen werden kann oder als persönliche Story Map oder als OKR [2, 3]. Die Agenten verändern ihre Ziel-Hierarchie in Abhängigkeit ihrer individuellen MBTI Präferenzen, also der individuellen Persönlichkeits-Polwahrscheinlichkeiten. Zum Beispiel ändert ein extrovertierter NT-Typ durch Kommunikation vornehmlich die oberste Ebene der Ziel-Hierarchie – ein introvertierter NT-Typ tut dies auch, jedoch nicht so oft.

Die dreiteilige Ziel-Hierarchie besteht aus alphanumerischen Zeichenketten einer bestimmten Länge. Diese Zeichenketten werden am Anfang, wenn die Simulation beginnt, per Zufall ermittelt. Der Inhalt der Ziel-Hierarchie sollte keine entscheidende Rolle für das Auftauchen prinzipiell emergenter Systemeigenschaften haben. Dies trägt der langjährigen Erfahrung aus anderen ABM Modellen und deren Systemeigenschaften Rechnung [4]. – Die Mathematik ist vielleicht doch viel entscheidender als der Inhalt!

Die Änderung der Ziel-Hierarchien erfolgt zufällig und paarweise zwischen zufällig ausgewählten Agenten. Das Ändern der Ziel-Hierarchien durch Kommunikation ist eine Form von Lernen und wird über einen Lernparameter alphaT für Teammitglieder und alphaS für Stakeholder eingestellt. Typischerweise ist alphaS kleiner gleich alphaT, da die Interaktion im Team zu einem besseren Lernen führt.

Zusätzlich erhalten die Stakeholder weniger Möglichkeiten ihre Ziel-Hierarchie zu ändern. Dies erfolgt über eine gesondert einzustellende Zeit-Steprate: Die Stakeholder erhalten zum Beispiel eine um den Faktor 200 reduziert Möglichkeit ihre Ziel-Hierarchie zu ändern. Dies trägt der Annahme Rechnung, dass die Stakeholder untereinander weniger oft kommunizieren und auch weniger oft mit den Teammitgliedern.

In der Sprache der Theorie der Selbstorganisation ergeben sich damit folgende Parameter:

Rahmenparameter: Anzahl und Persönlichkeit der Teammitglieder, Anzahl und Persönlichkeit der Stakeholder, reduzierte Steprate für die Stakeholder

Kontrollparameter: alphaT, alphaS

Ordnungsparameter: dreiteilige Ziel-Hierarchie, am Anfang gefüllt mit zufällig ermittelten Zeichenfolgen der Länge k. Die Ziel-Hierarchien werden gemäß MBTI-Profil geändert. Die Ähnlichkeiten der Ziel-Hierarchien wird über die Ratcliff-Obershelp Funktion bestimmt [5].

Die nachfolgenden Abbildungen zeigen jeweils links das resultierende emergente Systemverhalten, gemessen über die mittlere Ähnlichkeit aller Ziel-Hierarchien getrennt nach den Teammitgliedern und den Stakeholdern.

Jeweils rechts ist die Performance des Teams bzw. der Stakeholder zu sehen. Die Performance ist keine emergente Eigenschaft sondern wird über folgende Formel aus der Ähnlichkeit ermittelt: Performance=(Anzahl der Agenten eines Typs* mittlere Ähnlichkeit der Ziel-Hierarchien des Agententyps)**2. Diese Formel basiert auf folgender Betrachtung: Es werden alle bilateralen Verbindungen innerhalb einer Gruppe (Teammitglieder, Stakeholder) aufsummiert – gewichtet mit der mittleren Ähnlichkeit der Ziel-Hierarchien innerhalb der Gruppe. Wie man weiter untern sehen kann, folgt die Performance der Ähnlichkeit, natürlich erhöht um einen Faktor, der die Anzahl der Gruppenmitglieder berücksichtigt. 

Abbildung 1:
Rahmenparameter: 7 Teammitglieder mit definierter MBTI-Persönlichkeit, keine Stakeholder
Kontrollparameter: Lernparameter Teammitglieder alphaT = 0.1
Ordnungsparameter: Ziel-Hierarchie-Ähnlichkeit mit der Ratcliff-Obershelp Funktion berechnet, ermittelt aus den dreiteiligen Ziel-Hierarchien mit jeweils am Anfang zufällig generierter Zeichenfolge von k = 100 Zeichen pro Ebene

Wie man aus Abbildung 1 sehen kann, steigt die Ähnlichkeit recht schnell auf Werte von über 0,7 und die Teamperformance damit auf Werte von 21 und mehr, bei 7 Teammitgliedern. – Der Synergieeffekt beträgt also 3 und mehr!

Selbstverständlich genügt diese Aussage, wie auch die nachfolgend abgeleiteten Aussagen, keinen wissenschaftlichen Ansprüchen. Um wissenschaftlichen Ansprüchen zu genügen, müsste ich u.a. ggf. 10.000 und mehr Durchläufe errechnen lassen, um dann auf dieser Basis eine statistische Auswertung aller errechneten Werte zu erhalten. Hierauf verzichte ich, da dies meine (derzeitigen) Möglichkeiten übersteigt. Abbildung 2 zeigt den Einfluss der Stakeholder auf das Team. Die Anzahl der Stakeholder entspricht der Anzahl der Teammitglieder, ist also 7. Die Fähigkeit der Stakeholder ein Collective Mind auszubilden, bestimmt auch die Fähigkeit des Teams ein Collective Mind auszubilden: Die Stakeholder ziehen die Leistungsfähigkeit des Teams runter, obwohl die Lernrate der Stakeholder genau so groß ist wie diejenige der Teammitglieder. – Die Interaktionsrate der Stakeholder ist jedoch um den Faktor 200 geringer als die Interaktionsrate der Teammitglieder. 

Abbildung 2:
Rahmenparameter: 7 Teammitglieder mit definierter MBTI-Persönlichkeit, 7 Stakeholder mit zufälliger MBTI-Persönlichkeit, Abschottung des Teams und zwischen den Stakeholdern durch 200-fach geringere Steprate als im Team selbst.
Kontrollparameter: Lernparameter Teammitglieder alphaT= 0.1, Lernparameter Stakeholder alphaS= 0.1
Ordnungsparameter: Ziel-Hierarchie-Ähnlichkeit mit der Ratcliff-Obershelp Funktion berechnet, ermittelt aus den dreiteiligen Ziel-Hierarchien mit jeweils am Anfang zufällig generierter Zeichenfolge von k = 100 Zeichen pro Ebene

Abbildung 3 zeigt eine Simulation mit 21 Stakeholdern und einer zehnmal geringeren Lernrate der Stakeholder (diese Simulation benötigt in der Colab Umgebung ohne spezielle Hardware ca. 3-4 Stunden elapsed time). Die Ziel-Hierarchie-Ähnlichkeit der Stakeholder sinkt weiter ab und zieht das Collective Mind des Teams mit sich weiter runter. Die Stakeholder wie das Team zeigen jetzt eine Performance die weiter unterhalb der Anzahl der Teammitglieder bzw. der Stakeholder liegt.

Abbildung 3:
Rahmenparameter: 7 Teammitglieder mit definierter MBTI-Persönlichkeit, 21 Stakeholder mit zufälliger MBTI-Persönlichkeit, Abschottung des Teams und zwischen den Stakeholdern durch 200-fach geringere Steprate als im Team selbst.
Kontrollparameter: Lernparameter Teammitglieder alphaT= 0.1, Lernparameter Stakeholder alphaS = 0.01
Ordnungsparameter: Ziel-Hierarchie-Ähnlichkeit mit der Ratcliff-Obershelp Funktion berechnet, ermittelt aus den dreiteiligen Ziel-Hierarchien mit jeweils am Anfang zufällig generierter Zeichenfolge von k = 100 Zeichen pro Ebene

Was sagt uns dies?

Es sieht so aus, als wenn die hybride Collective Intelligence von chatGPTplus und mir, ein Modell gefunden hätte, das emergentes Collective Mind Verhalten eines Teams in Interaktion mit Stakeholdern recht gut abbildet. – Dies ist ein weiterer Schritt in Richtung von Management 5.0, der Synergie von AI und Management 4.0.

Anhang: Erst-Aufgabenstellung für GPT4/ChatGPTplus

Die Aufgabenstellung zur Digitalen Transformation des Unternehmens KüchenManufaktur verwende ich in meinen Management 4.0 Trainings, um eine Scrum Simulation durchzuführen und eine Ziel-Hierarchie zu erstellen. Die zugrundeliegende Theorie hierzu ist in [2], [3] zu finden.

Erzeuge ein Agent Based Model (ABM) in der Programmiersprache Python, z. B. mittels MESA Python, für ein Team von 7 Teammitgliedern und 100 Stakeholdern. Die 7 Teammitglieder und die 100 Stakeholder sind Agenten im ABM. Die Teammitglieder und die 100 Stakeholder gehören zu dem Unternehmen KüchenManufaktur, das sogenannte Weiße Ware, also u.a. Herde, Kühlschränke und Gefrierschränke herstellt. Bisher hat das Unternehmen KüchenManufaktur diese Weiße Ware ohne große Digitalisierungsfunktionen hergestellt. Jetzt soll die Weiße Ware smart werden und als Life Style Produkt positioniert werden. Der Einsatz von smarter Technologie kann auch den Einsatz von AI oder ML beinhalten. Zum Beispiel könnte eine zukünftige Anforderung für einen Kühlschrank beinhalten, dass ‚er sich von alleine füllt‘. ‚Von alleine füllen‘ bedeutet, dass er über ein intelligentes Füllmanagement verfügt, das u.a. Zugriff auf Lebensmittellieferanten hat.

Es geht also um die Digitale Transformation des Unternehmens KüchenManufaktur. Die Digitale Transformation soll mittels eine Projektes durchgeführt werden. In einem ersten Schritt ist ein Konzept für die Digitale Transformation zu erstellen. Für diesen ersten Schritt ist das ABM mittels Python zu erstellen.

Die Aufgabe der Konzepterstellung typisieren wir als Projekt mittels des Diamantmodells: Das Projekt ist für KüchenManufaktur ein Projekt mit hohem Innovationsgrad. Nicht alle Stakeholder sind vom Sinn der Digitalen Transformation überzeugt und deshalb zeigen auch recht viele Stakeholder innere Widerstände gegen das Projekt. Deshalb sprechen wir von einem hohen Missionsgrad.- Das Team hat also viel Überzeugungsarbeit zu leisten. Der Kompliziertheitsgrad der neuen smarten Weißen Ware ist eher gering bis mittelgroß. Der Managementgrad ist mittel, da KüchenManufaktur innerhalb eines Jahres mit ersten smarten Produkten auf den Markt kommen möchte.

Die Persönlichkeiten der 7 Teammitglieder beschreiben wir mittels des MBTI, wobei die dominante Persönlichkeitsdimension des jeweiligen Teammitgliedes als Wahrscheinlichkeit angegeben wird. Wir nennen vereinfacht die jeweiligen Teammitglieder entsprechend ihrer MBTI Typologie und einer MBTI-Polwahrscheinlichkeit, also:

Teammitglied 1: ENTJ heißt: Extraversion = E = 0.8, Intuition = N = 0.8, Thinking = T = 0.6, Judging = J = 0.6

Teammitglied 2: INTJ heißt: Introversion = I = 0.8, Intuition = N = 0.7, Thinking = T = 0.7, Judging = J = 0.6

Teammitglied 3: ISFP heißt: Introversion = I = 0.6, Sensing = S = 0.7, Feeling = F = 0.7, Perceiving = P = 0.6

Teammitglied 4: ISTJ heißt: Introversion = I = 0.8, Sensing = S = 0.7, Thinking = T = 0.7, Judging = J = 0.9

Teammitglied 5: ESTJ heißt: Extraversion = E = 0.8, Sensing = S = 0.9, Thinking = T = 0.7, Judging = J = 0.6

Teammitglied 6: ISTP heißt: Introversion = I = 0.9, Sensing = S = 0.9, Thinking = T = 0.6, Perceiving = P = 0.6

Teammitglied 7: ISTJ heißt: Introversion = I = 0.7, Sensing = S = 0.6, Thinking = T = 0.6, Judging = J = 0.6

Die Stakeholder erhalten per Zufall eine Persönlichkeit gemäß MBTI.

Die Aufgabe der Konzepterstellung ist erledigt, wenn die 7 Teammitglieder, die das Konzept erstellen, eine gemeinsame Ziel-Hierarchie erstellt haben. Eine Ziel-Hierarchie besteht aus Informationseinheiten, die abstrakt oder detailliert sind. Eine Vision oder ein übergeordnetes Ziel bilden die oberste Ebene, es folgen darunter größere Informationseinheiten, die in weitere Informationseinheiten runtergebrochen werden. Im Agilen Management beginnt die Ziel-Hierarchie zum Beispiel mit einer Vision, gefolgt von Epics, die in Features zerlegt werden, die Features werden in User Stories zerlegt und diese wieder in Tasks und Tasks in Subtasks usw.

Für die Generierung der Informationseinheiten kann pro Teammitglied auf chatGPT zurückgegriffen werden

Um die Ziel-Hierarchie zu erstellen, tauschen die 7 Teammitglieder gemäß ihrer Persönlichkeitspräferenzen Informationseinheiten aus. Diese Informationseinheiten werden gemäß ihrer Präferenzen und der damit verbundenen Wahrscheinlichkeiten in die persönliche Ziel-Hierarchie aufgenommen.

Im ABM Model wird der Informationsaustausch in Zeitschritten durchgeführt. Wir definieren die Performance des Teams über die Ähnlichkeit der persönlichen Ziel-Hierarchien. Wenn alle persönlichen Ziel-Hierarchien identisch sind, sprechen wir von einem Collective Mind. Der Collective Mind kann durch die Kommunikation mit den Stakeholdern stabilisiert oder destabilisiert werden. Die Ähnlichkeit der Ziel-Hierarchien aller Stakeholder und der 7 Teammitglieder ist ein Maß für den Collective Mind im Team bzw. im Stakeholderkreis bzgl. der Digitalen Transformation.

Zeichne den Verlauf des Colletive Mind im Team und den Verlauf des Collective Mind für den Stakeholderkreis über die Zeit.

[1] Complexity Explorer (2023) MESA-Python Lecture, https://www.complexityexplorer.org/courses/172-agent-based-models-with-python-an-introduction-to-mesa/segments/17326, Santa Fe Institute, zugegriffen am 30.04.2023

[2] Oswald A, Köhler J, Schmitt R (2017) Projektmanagement am Rande des Chaos. 2. Auflage, Springer, Heidelberg, auch in englischer Sprache unter ‚Project Management at the Edge of Chaos‘ verfügbar.

[3] Köhler J, Oswald A. (2009) Die Collective Mind Methode, Projekterfolg durch Soft Skills, Springer Verlag

[4] Epstein J M, Axtell R (1996) Growing Artificial Societies – Social Science from the Bottom Up, The Brookings Institution, Washington D.C.

[5] Wikipedia (2023) Ratcliff-Obershelp Funktion, https://de.wikipedia.org/wiki/Gestalt_Pattern_Matching#:~:text=Gestalt%20Pattern%20Matching%2C%20auch%20Ratcliff,im%20Juli%201988%20im%20Dr.

„Einheit in der Vielfalt“ oder von der Selbstorganisation des Marktes

Anlässlich des 30zigsten Jahrestages der Deutschen Einheit wurde der Zukunftsforscher Daniel Dettling vom Zukunftsinstitut zum Stand der deutschen Einheit interviewt [1]. Er kommt zu dem auf den ersten Blick erstaunlichen Schluss „Der Westen wird sich dem Osten angleichen“. Dies basiert auf der weitreichenden Erkenntnis „Wir leben 2050 in einem Deutschland und Europa der Regionen. Landkreise und ihre Kommunen haben ähnliche Kompetenzen wie die Bundesländer und können vor Ort autonomer agieren, angefangen von den Schulen bis hin zu Steuern.“ – Die „Einheit in der Vielfalt“ sei das zukünftige Einende. – Dettling identifiziert nicht Geld, als den entscheidenden Ordnungsparameter, sondern er spricht vom „Glücksfaktor“, bei dem der Osten schon weiter sei als der Westen.

Man braucht nicht sehr „quer“ zu denken, um zu erkennen, dass dies nichts anderes ist als einer der Grundgedanken der Selbstorganisation, der sich auch im gesellschaftlichen Raum seinen Weg bahnt.

Die Grundgedanken der Selbstorganisation „Einheit in der Vielfalt“, die Suche nach Sinn, die Einführung von Nachhaltigkeit, die Ersetzung des Wettbewerbsgedankens durch den Kollaborationsgedanken, alle dies sind Ausdruck eines weiter entwickelten  gesellschaftlichen Bewusstseins, das sich anschickt zu emergieren.

In einem Artikel auf nature communication warnen Nachhaltigkeitsökonomen erst kürzlich vor den Konsequenzen des Überflusses. Sie skizzieren Konzepte, die auf dem Grundgedanken der Selbstorganisation beruhen und hier Abhilfe schaffen sollen [2]. Dies wird flankiert von den datenbasierten Forschungsergebnissen meines Sohnes Yannick, dass der Energie-Fußabdruck ganz wesentlich mit dem Einkommen und damit mit dem Überfluss korrespondiert [3]. Man siehe hierzu und zur korrespondierenden Oxfam-Studie auch den Kommentar in Forbes [4].

Der ein oder andere mag auf die Idee komme, dass dies dem Kapitalismus bzw. dem ungezügelten Kapitalismus zuzuschreiben ist. – Dies ist nicht ganz von der Hand zu weisen, jedoch liegt das Problem meines Erachtens tiefer. Es hat viel mehr mit den aktuell (noch) vorherrschenden Werte-Memen zu tun, die besagen, dass „Wer (mehr) Erfolg hat, hat auch ein Anrecht auf (mehr) Entlohnung, also mehr Überfluss“, dass „Innovationen schon immer unser aller Lebensstandard gehoben haben und deshalb (immer) gut sind“, und dass „wir klare Fakten brauchen, die keinen Zweifel aufkommen lassen, bevor wir die Pferde scheu machen, denn es ist noch immer gut gegangen ist“. Diese Aussagen sind zentrale Werte-Meme des sogenannten orangenen Werte-Mems. Das orangene Werte-Mem ist weitgehend blind für eine Relativierung unserer anthropozentrischen Bedeutung und unserer systemischen Einbettung. – Deshalb sind auch datenbasierte Forschungsergebnisse so wichtig; neben Rahmenbedingungen wie Corona oder ersten großen Klimaschäden, die einen mächtigen Druck zum Umdenken ausüben, ist es sehr wichtig, das orange Mem mit einer seiner eigenen Waffen, der „datenorientierten Innovation“, zu schlagen, um so mitzuhelfen, eine Transformation anzustoßen. – Denn, …der Überfluss entspringt einem Denken und Handeln, das nicht mehr zum 21. Jahrhundert passt.

In [2] wird ein „neuer Lebensstil für das 21. Jahrhundert“ vorgeschlagen. – Die nachfolgende Tabelle zeigt wie stark diese Vorschläge mit den im Management 4.0 vorgeschlagenen Werte-Memen korrespondieren [5]. Dieser Werte-Mem Shift hat schon vor mehr als 25 Jahren eingesetzt, denn man kann ihn an den Entwicklungen festmachen, die zum Agilen Manifest führten:

Nachhaltige Ökonomie/
Gesellschaft [2]

Management 4.0 [5]

Das Bruttoinlandsprodukt ist kein geeignetes Maß für Wohlstand oder gar den „Glücksfaktor“. – Dies entspricht der Aussage: Preise bzw. Geld sind keine Sinngeber!

Der überbordende Work-in-Progress von einzelnen Personen, Teams oder Organisationen ist letztendlich die organisationale Repräsentation des Glaubens „Geld ist der entscheidende Träger von Sinn“.

Der WIP ist vielmehr zu limitieren und als „falscher“ Ordnungsparameter zu entlarven, um den Weg für einen sinngebenden Ordnungsparameter frei zu machen.

Ermächtige Menschen auf allen Ebenen zur Partizipation und Demokratie mit stärkerer Selbst-Governance auf lokaler Ebene.

Führe Selbstorganisation ein, die auf den synergetischen Prinzipien der natürlichen Selbstorganisation beruht. Baue eine entsprechende dynamische Governance-Architektur auf.

Betone Gleichheit und reduziere Ungleichheit durch Umverteilung

Betone individuelle Wertschätzung und reduziere wertvernichtende Komplexität durch einen integralen Ansatz.

Unterstütze die Transformation des ökonomischen Systems durch die Betonung von Forschung und Innovation in einem kollaborativen lokalen Umfeld (bei gleichzeitiger Reduktion von Massenproduktion in einem Wettbewerbsumfeld) 

Richte die Organisation an einer innovativen Ziel-Hierarchie (z.B. Collective Mind, Story Map, OKRs,…) aus, die den Menschen in der Organisation Sinn vermittelt und ermögliche dies durch Kollaboration statt Silo-Denken und Wettbewerb.

Sorge für Kapazitäten in der (digitalen) Bildung sowie im Austausch von Know-How zwischen lokalen gesellschaftlichen Einheiten 

Sorge dafür, dass durch geeigneten Austausch Selbstorganisation und Skalierung von Organisationen Hand in Hand gehen.


In [2] werden zusätzlich unterschiedliche Organisationsformen skizziert, die sich insbesondere in der Ausgestaltung der Governance-Architektur unterscheiden: Nämlich, ist die Governance-Architektur eher dynamisch oder statisch?; gibt es eine übergeordnete Governance, die die Einheit in der Vielfalt sicherstellt?; und gibt es eine Governance, die die Wechselwirkung zwischen lokalen Einheiten im gesellschaftlichen System reguliert?

Auch im Management 4.0 kennen wir genau diese Fragestellungen.- Die meisten Agilen Handlungsrahmen (wie Scrum und Kanban oder SAFe und LeSS) verfügen lediglich über eine statische Governance. Nur der Handlungsrahmen Soziokratie bzw. der hiervon abgeleitete Handlungsrahmen Holacracy verfügt über eine dynamische Governance. Der Handlungsrahmen Scaled Agile Management 4.0 beruht auf einer dynamischen Governance, die zusätzlich auf den Prinzipien der natürlichen Selbstorganisation (Synergetik) beruht.

In dem Deutschlandfunk-Beitrag „Die Wertedebatte, Wie fünf Ökonominnen Wirtschaft und Politik neu verbinden“ [6] werden die volkswirtschaftlichen Konzepte der fünf bedeutenden Ökonominnen Mariana Mazzucato, Kate Raworth, Esther Duflo, Stephanie Kelton und Carlota Pérez skizziert. Ich zitiere beispielhaft hieraus zu einem „neuen Lebensstil für das 21. Jahrhundert“:    

„Voraussetzung wäre jedoch auch in ihren Augen der Abschied von traditionellen Theorien der Volkswirtschaft. Statt sich weiter an den Modellen der industriellen Massenproduktion zu orientieren, bei denen Wachstum, Erwerbsarbeit, Besitz und dergleichen wichtig sind, gelte es, einen neuen Lebensstil für das 21. Jahrhundert zu entwickeln.

Die Zukunft ist nicht immer die Fortführung der jüngsten Vergangenheit. Der Staat muss die Wettbewerbsbedingungen in eine synergistische Richtung lenken. Eine Richtung, in der das, was einer tut, allen anderen zugutekommt, sodass wir diese fantastische gemeinsame Energie für Wachstum und Wohlbefinden bekommen.

Erste Trends in diese Richtung gibt es ja bereits. Wir könnten noch mehr Gebrauchsgüter gemeinsam nutzen, statt einzeln zu besitzen. Eine individuelle maßgeschneiderte Produktion von qualitativ hochwertigen und langlebigen Einzelstücken könnte die heutige Massenproduktion von Billigteilen ersetzen. Wir könnten mehr Zeit für Familie, gegenseitige Fürsorge, Bildung und Kultur aufwenden statt um jeden Preis an überflüssig gewordenen Erwerbsarbeitsplätzen festzuhalten. Klingt utopisch?“

Die Erkenntnisse des Zukunftsinstituts, der modernen (Nachhaltigkeits-) Ökonomie und des Management 4.0 zeigen in die gleiche Richtung. Analog dem Agilen Manifest schlage ich auf dieser Basis ein ökologisch-ökonomisches Manifest vor:

  • Die Selbstorganisation der Gesellschaft ist wichtiger als die Selbstorganisation des Marktes.
  • Der Markt dient der Gesellschaft, und nicht die Gesellschaft dem Markt.
  • Eine geführte Selbstorganisation des Marktes ist wichtiger als eine ungeführte Selbstorganisation des Marktes.
  • Einheit in der Vielfalt ist wichtiger als Einheit.
  • Kollaboration ist wichtiger als Wettbewerb.
  • Lokalität ist wichtiger als Globalisierung.

Die nachfolgende Abbildung 1 fasst einige Aussagen der Blog-Reihe „Selbstorganisation des Marktes“ zusammen:

Abbildung 1: Die Selbstorganisation der Gesellschaft ist wichtiger als die Selbstorganisation des Marktes.

Viele Individuen tragen mit ihrem individuellen Verhalten in verschiedenen Kontexten auf der Mikro-Ebene zur Ausbildung von Mustern bei, die sich auf der Makro-Ebene des Marktes und der Gesellschaft zeigen. Damit tragen die individuellen Makro-Ebenen mit ihren individuellen Werten und Glaubenssätzen, ihren Identitäten und dem Sinn, den jeder seinem Leben gibt, zu den gesellschaftlichen Makro-Strukturen bei. – Es bilden sich mehr oder weniger viele Gesellschaften bzw. Teilgesellschaften sowie ein Markt bzw. Teilmärkte.

Die sozialen Makro-Ebenen (Markt/Märkte bzw. Gesellschaft/Teilgesellschaften) lassen sich wiederum durch unterschiedliche Ordnungsparameter beschreiben. So habe ich im letzten Blog z.B. erwähnt, dass man die unterschiedlichen ökonomischen Theorien u.a. auch durch die Reihenfolge der Markt-Ordnungsparameter charakterisieren kann. Der in allen ökonomischen Theorien oberste Ordnungsparameter ist die Technologie, sie ändert sich am langsamsten. – Die Schnelligkeit oder Langsamkeit, mit der sich die Größen im Verhältnis zueinander ändern, habe ich durch stärkere oder weniger starke Schwingungen angedeutet. So zeigt das Verhalten der Menschen auf Mikro-Ebene die (wahrscheinlich) stärkste Dynamik.

Der Markt ist Teil des gesellschaftlichen Systems. Berücksichtigt man, dass Modelle immer ihre Limitierungen haben, so hat die Ökonomie gezeigt hat, dass man mit mathematischen Modellen den Markt vielfach sehr gut beschreiben kann. – Man kann sogar mit Hilfe der mathematischen Theorien der Komplexitätsforschung und der Selbstorganisation für den Markt wichtige Erkenntnisse gewinnen. – Es ist jedoch wichtig, festzuhalten, dass der Markt bzw. die Märkte zwar emergierende Makro-Strukturen zeigen, jedoch in sich keine soziale Rechtfertigung tragen. – Sie sollten, trotz aller „selbstorganisierter Komplexität“ nur als „formale“ Repräsentationen gesellschaftlicher Makro-Strukturen betrachtet werden und diesen untergeordnet werden, damit sich die integralen Werte-Meme entwickeln können. Genau dies ist für mich die Quintessenz eines „neuen Lebensstils für das 21. Jahrhundert“. – Wenn man sieht, dass Management 4.0 gerade die organisationale Welt verändert, dann kann man die berechtigte Hoffnung haben, dass der Kapitalismus für das Leben im 21. Jahrhundert seine Dominanz verliert, Innovationen mehr integrale gesellschaftliche Relevanz zeigen und der „Glücksfaktor“ wächst.  

[1] Bayer Anna und Künßberg Jann-Luca (2020) Interview mit dem Zukunftsforscher Daniel Dettling über Deutschland 2050, „Der Westen wird sich dem Osten angleichen“, Spiegel,  https://www.spiegel.de/geschichte/deutschland-2050-der-westen-wird-sich-dem-osten-angleichen-a-5d614ef4-1d3a-4022-afde-49d6f1ddd7d4, zugegriffen am 24.10.2020

[2] Wiedmann Thomas, Lenzen Manfred, Keyßer Lorenz T., Steinberger Julia K. (2020) Scientits‘ warning on affluence, nature communications, (2020)11:3107

[3] Oswald, Y., Owen, A. & Steinberger, J.K. (2020) Large inequality in international and intranational energy footprints between income groups and across consumption categories, Nature Energy volume 5, page 349(2020)

[4] Ollie Williams (2020) Rich People Are Bad For The Planet Studies Show, https://www.forbes.com/sites/oliverwilliams1/2020/09/21/rich-people-are-bad-for-the-planet-studies-show/#2e6f07db2b46, zugegriffen am 24.10.2020

[5] Oswald Alfred, Müller Wolfram (editors) (2020) Management 4.0 – Handbook for Agile Practices, BoD, Norderstedt

[6]  Schrupp Antje (2020) Die Wertedebatte, Wie fünf Ökonominnen Wirtschaft und Politik neu verbinden, Deutschlandfunk, https://www.deutschlandfunk.de/die-wertedebatte-wie-fuenf-oekonominnen-wirtschaft-und.1184.de.html?dram:article_id=485902&utm_source=pocket-newtab-global-de-DE, zugegriffen am 24.10.2020

Emergenz oder Selbstorganisation des Marktes?

Die 8te research conference der IPMA (International Project Management Association) beginnt am 09.09.2020 als Online Veranstaltung und steht unter dem Thema „Projects as arena for self-organizing“ [1]. Eine Kollegin fragt in einer Voabdiskussion „Is self-organization a “superpower” or a “mythological creature?”.

Der vierte Teil der Blog-Reihe „Selbstorganisation des Marktes“ versucht diese Frage zu beleuchten und aus meiner Sicht zu beantworten. Gleichzeit möchte ich die Universalität des Konzeptes der Selbstorganisation weiter verdeutlichen.  

In meinem Blog-Beitrag über Evidenz-basiertes Management [2] habe ich am Beispiel des Begriffes Selbstorganisation schon einmal gezeigt, dass dieser Begriff völlig unterschiedlich verwendet wird und meines Erachtens daraus abgeleitete Ergebnisse einer wissenschaftlichen Befragung nicht aussagkräftig sind. In dieser wissenschaftlichen Befragung wurden folgende Begriffe als Substitut für „selbst-organisierte Teams“ verwendet: „self-managing teams, self-directing teams, self-regulating teams, self-organizing teams, self-leading teams, autonomous teams, autonomous task groups, autonomous work groups, and team leadership.”

Fast Jeder, der schon einmal in Gruppen oder Teams gearbeitet hat, hat sicherlich schon die Erfahrung gemacht, dass Teams, die man umgangssprachlich als selbst-organisiert bezeichnet hat, keineswegs eine „superpower“ entwickelt haben. – Viele der sogenannten agilen Teams gehören in diese Kategorie. Dagegen haben einige wenige, die Erfahrung gemacht, dass es auch selbst-organisierte Teams gibt, die „superpower“ haben bzw. entwickeln. – Diese Teams zeigen eine enorme Leistungsfähigkeit, kreieren Etwas völlig Neues und empfinden ihre Arbeit als hoch-motivierend und sinnvoll. Wenn so etwas auftritt spricht man von emergenten Phänomenen oder Emergenz (lateinisch emergere „Auftauchen“, „Herauskommen“, „Emporsteigen“ [3]).

So gesehen trägt der Satz „Is self-organization a “superpower” or a “mythological creature?” kein ausschließendes Oder in sich. Denn die Superpower ist ein wenig beobachtetes Phänomen, und gleichzeitig haben alle schon mal von (selbstorganisierten) Teams mit Superpower gehört. – Und schon ist das Fabelwesen „Selbstorganisation“ geboren, denn man hat davon gehört, keiner weiss was es ist, und gleichzeitig wünscht man es sich herbei.

In den wenigsten Fällen wird man Selbstorganisation auch mit Technologie oder Technik verbinden. So dürfte den wenigsten bekannt sein, dass z.B. Laser, Supraleitung, Künstliche Intelligenz oder smarte autonome Logistiksysteme auf Selbstorganisation beruhen [4].

In [5] werden die Begriffe Emergenz und Selbstorganisation untersucht und voneinander abgegrenzt. Emergenz wird dort wie folgt definiert:

„A system exhibits emergence when there are coherent emergents at the macro-level that dynamically arise from the interation between the parts at the mirco-level. Such emergents are novel with respect to the individual parts of the system.”

Selbstorganisation wird in [5] definiert als:

„Self-organisation is a dynamical and adpative process where systems acquire and maintain structure themselves, without external control.”

Unsere in [6] gegebene Definition integriert Emergenz und Selbstorganisation:

„Self-organization creates, under certain conditions (setting-, control- and order parameters) and through the interaction of system elements on the micro-level, emergent properties on a macro-level. The consequence of a self-organizing process is an ordered pattern, collective behavior or a new structure.”

Wie man unmittelbar sehen kann, integriert unsere Definition Selbstorganisation und Emergenz nicht nur, sondern sie geht sogar noch ein Stück weiter: Sie spricht von bestimmten Konditionen (den Rahmen-, Kontroll- und Ordnungsparametern) unter denen emergente Selbstorganisation sich ausbilden. – Und in diesem Sinne verwenden wir Selbstorganisation im Management 4.0. – Wir sprechen nur dann von emergenter Selbstorganisation, wenn sich ein Ordnungsparameter ausbildet.

Das heißt auch, dass die von uns verwendete Definition von emergenter Selbstorganisation, Emergenz und das übliche Verständnis von Selbstorganisation (wie in [4] verwendet) einschließt. Nicht alle Systeme, die nach üblichem Verständnis als selbstorganisierte Systeme verstanden werden, zeigen Emergenz sondern sind z.B. nur autonom und passen sich mehr oder weniger emergent an die Umgebung an. Um diesen Grad an Emergenz zu verdeutlichen, könnte man eine Skala von z.B. 1 bis 10 einführen und selbstorganisierte Systeme entsprechend einordnen: Hiernach hätten vermutlich die meisten der sogenannten agilen Teams eine Emergenz, die nahe 1 ist (also nur wenig oder keine Emergenz)  und einige wenige eine Emergenz nahe 10 (also eine hohe Emergenz). Wenn wir von einem Collective Mind in Teams sprechen, dann meinen wir eine Emergenz, die Nahe 10 ist. (Anm.: Es gibt in der wissenschaftlichen Literatur einige Versuche Emergenz über Komplexität oder Entropie zu definieren und zu messen. – Diese Versuche waren meines Erachtens bisher nicht sehr erfolgreich, da man eigentlich nicht wirklich genau weiß, was Emergenz ist [7].)

Die Unvorhersehbarkeit und die Stärke des Ordnungsparameters, beim Team der Collective Mind, ist im Management 4.0 ein „Maß“ für den Emergenzgrad. – In Management 4.0 Trainings lernen die Teilnehmer für den Emergenzgrad eine Intuition zu entwickeln. – Dies erlaubt ihnen über Selbstreflexion ihre Team-Emergenz (Teamperformance) zu erhöhen.

Technische Systeme, die auf Emergenz beruhen, hätten hiernach einen recht hohen Grad an Emergenz. – Dies wäre insoweit gerechtfertigt als der Emergenzgrad die mit einem kollektiven Verhalten verbundene qualitative und quantitative Neuartigkeit einer Vernetzung „misst“. Falls das Universum auf emergenter Selbstorganisation beruht, dann läge dessen Emergenzgrad sicherlich sehr viele Größenordnungen über unserer Skala von 1 bis 10. Abbildung 1 zeigt einen sehr vagen Versuch die Emergenzgrade verschiedener Systeme zu „bemessen“.

Abbildung 1: Systeme und deren Emergenzgrad, eine sehr vage Zuordnung

Warum ist dies Alles wichtig für das Verständnis von Selbstorganisation, insbesondere von sozialer Selbstorganisation, hier der Selbstorganisation des Marktes?

Ein Markt ist auch ein selbstorganisiertes System, das Emergenz zeigt. Ein überregulierter Markt kann keine emergente Selbstorganisation mehr ausbilden, denn es gibt ja keine Neuartigkeit bzw. Unvorhersehbarkeit, die der Markt als Ganzes zeigt. – Und damit verliert der Markt das Potential Emergenz zu zeigen. – Man beachte, dass diese Aussage direkt zu dem schon erwähnten Glaubenssatz „Selbstorganisation verträgt keine Eingriffe“ führt. – Man beachte aber auch, dass wir an vielen anderen Stellen im Blog schon gezeigt haben, dass „Eingriffe“ sehr wohl vorkommen können: Diese „Eingriffe“ wirken als Governance, die die Rahmen- und Kontrollparameter gestaltet und indirekt hilft, dass sich der oder die Ordnungsparameter ausbilden können.

Ein unterregulierter Markt, also ein Markt, der keinen Eingriffen unterliegt, zeigt aber auch nicht zwangsläufig eine hohe Emergenz und wenn er Emergenz zeigt, dann ist dies eventuell eine Emergenz, die nicht wünschenswert ist. – Man kann dies mit einem sehr wenig regulierten, also autonomen Team vergleichen, das auch nicht automatisch Emergenz zeigt.

Legt man den Fall Tönnies als symptomatisch für die Fleischindustrie zugrunde, dann zeigt dieser Markt wahrscheinlich eine gewisse Emergenz (auf unserer Skala vielleicht 2-3), die leider aber nicht wünschenswert ist! Diese Emergenz lässt sich zum großen Teil auf die nicht wünschenswerte Kultur in diesem Markt zurückführen. Wenn also Emergenz auftritt, so ist diese keineswegs immer gut. – An anderer Stelle habe ich des Öfteren festgestellt, dass Selbstorganisation keinesfalls immer „gut“ ist. – Es kann durchaus hochemergente Gesellschaften und Märkte oder auch Organisationen und Teams geben, die mit Superpower Böses tun.

Emergente Selbstorganisation, also „superpower“, wenn man sie denn haben will, benötigt die explizite Ausbildung eines wünschenswerten Mindsets oder einer wünschenswerten Kultur, denn sonst entsteht eine „superpower“, die man ggf. nicht mehr kontrollieren kann. – Deswegen ist z.B. die Ausbildung einer Ethik für die Digitale Transformation besonders wichtig. Allgemein kann man sagen, dass es für Transformationen, die emergente Strukturen hervorbringen (hervorbringen sollen) besonders wichtig ist, eine Ethik auszubilden, und zwar umso mehr, als ein höherer Emergenzgrad mit ihnen verbunden ist.


[1] IPMA (2020) 8te IPMA research conference, http://www.ipma-research-conference.world/

[2] Oswald Alfred (2018) Evidenzbasiertes Management: Richtig verstanden… geht kein Weg daran vorbei, https://agilemanagement40.com/evidenzbasiertes-management-richtig-verstanden-geht-kein-weg-daran-vorbei, zugegriffen am 07.09.2020

[3] Emergenz (2020) https://de.wikipedia.org/wiki/Emergenz, zugegriffen am 07.09.2020

[4] Czybik Björn, Ehrlich Marco, Trsek Henning, Oswald Alfred (2020) Eine differenzierte Betrachtung ganzheitlicher Selbstorganisation im Rahmen von Industrie 4.0, veröffentlicht im Rahmen der Automation 2020, https://www.vdi-wissensforum.de/automatisierungskongress/

[5] De Wolf Tom, Holvoet Tom (2004) Emergence and Self-Organisation a statement of similarities and differences, Lecture Notes in Computer Science 3464

[6] Oswald Alfred, Köhler Jens, Schmitt Roland (2018) Project Management at the Edge of Chaos, Springer

[7] Greve Jens, Schnabel Annette (Hrsg.) (2011) Emergenz: Zur Analyse und Erklärung komplexer Strukturen, suhrkamp taschenbuch wissenschaft

Liebesaffären in der Projektarbeit – Hypnosystemisches Arbeiten und Management 4.0

Unlängst habe ich von meiner Kollegin Sonja Armatowski, die als systemischer Coach in Projekten arbeitet, das Buch „Liebesaffären zwischen Problem und Lösung, Hypnosystemisches Arbeiten in schwierigen Kontexten“ von Gunther Schmidt [1] aus dem Jahre 2004 geschenkt bekommen. Dies ist ein Buch, das trotz seines Alters nichts an Aktualität verloren hat, und gerade für Führung und Management viele wertvolle Erkenntnisse bereit hält. Mit diesem Blog Beitrag möchte ich dies verdeutlichen.

Gunther Schmidt [2] ist innerhalb des deutschsprachigen Raumes sicherlich der bekannteste Experte für (systemische) Hypnotherapie. Seine Arbeiten beruhen auf den Hypnosetechniken von Milton Erickson. – Milton Erickson gehört neben Gregory Bateson, Virginia Satir und Fritz Perls zu den genialen Modelgebern des NLP [3]. Schmidt’s Buch enthält deshalb sehr viele implizite und explizite Verbindungen zum NLP.

Schmidt schreibt zum Titel seines Buches: „<der Titel> eben darauf hinweisen soll, wie „Problemmuster“ und „Lösungsmuster“, erfreuliche über ihr ursprüngliches Wesen hinausgehende Entwicklungen (im schönsten Fall „Liebesbeziehungen mit Folgen“) anregen können.“ Dem aufmerksamen Leser dürfte nicht entgangen sein, dass er im Titel von „Liebesaffären“ und im Text von „Liebesbeziehungen“ spricht. Beide Begriffe bezeichnen wohl unterschiedliche Kontextstereotype. – Schmidt wäre wohl kein Experte für Hypnosearbeit, wenn er den Titel nicht mit Bedacht ausgewählt hätte. – Der Titel erzeugt nämlich eine enorme Aufmerksamkeit und fokussiert über die damit verbundenen „romantisierenden“ [1] Gefühle. – Und genau um Aufmerksamkeit und Fokus geht es; sie sind die Schlüsselbegriffe in der Hypnosetherapie. Die Abbildung eines Clowns im Buch Cover trägt zur (weiteren) Irritation und letztendlich zur Fesselung bei. – Eine wichtige Interventionstechnik in der systemischen Hypnotherapie.

Und damit sind wir beim Kern, warum ich das Buch und einige seiner Inhalte für diesen Block ausgewählt habe. Das Buch enthält neben Kapiteln zur Anwendung in der systemischen Psychotherapie auch Kapitel zur Anwendung in Teams und Organisationen. – Schmidt verweist direkt am Anfang seines Buches auf Zusammenhänge zur Theorie der Selbstorganisation, insbesondere auch zur Synergetik, die einer der vier Basisbausteine des Management 4.0 [4] darstellt.- Die anderen drei sind Mindset-Entwicklung, Skalierung und Neuroleadership. Die Fachsprache von Schmidt verwendet nicht selten Begriffe der Synergetik. So schreibt er zum Beispiel im Kontext der Hauptaufgaben von therapeutischen Interventionen „Es soll erreicht werden, dass Klienten und Therapeuten ihre Aufmerksamkeit so intensiv als irgend möglich … auf die kontext-angemessenen Zielpotentiale fokussieren können. So soll eine Art Attraktorkraftfeld für das Lösungserleben geschaffen werden (wie bei der Synergetik), das immer stärker („Schneeballeffekt“) Feedbackschleifen unterstützt, die wieder das Kraftfeld des Lösungserlebens weiter verstärken.“ – Attraktor ist ein Begriff aus der Komplexitätstheorie. Er steht für einen dynamischen Zustand, auf den ein System sich hinbewegt oder hier hinbewegen soll. Die Fokussierung auf kontext-angemessene Zielpotentiale stellt den sogenannten Ordnungsparameter [5] dar, der zum Attraktor führt. – Damit ergibt sich noch eine Verbindung zum Titel des Buches bzw. zur Liebe: Liebe ist ein solcher Ordnungsparameter, der auf die Geliebte (den Geliebten) hinführt.- Entsprechende Neurotransmitter sorgen dafür, dass die Aufmerksamkeit extrem gebündelt wird. Nicht umsonst sagt man „Liebe macht blind“. – Liebe ist also eine Form von Trance bzw. Hypnose. – Schmidt hat genau diese Wirkung des Wortfeldes Liebe-Liebesbeziehung-Liebesaffäre im Titel sprachlich genutzt, um eine Fokussierung auf sein Buch zu erreichen.

Die Verwendung der Gedanken aus der Theorie der Selbstorganisation ist schon recht erstaunlich, zumal Haken und Schiepek die Theorie der Selbstorganisation für psychische und soziale Systeme erst im Jahre 2006/2011 in einem umfangreichen Buch [6] einem breiteren Publikum zugänglich gemacht haben. 

Schmidt führt an verschiedenen Stellen aus, dass „Unter Hypnose …generell der interaktionelle Prozess der systematischen Fokussierung von Aufmerksamkeit verstanden <wird>, welcher auf willkürlicher, besonders aber auf unwillkürlicher Ebene das Erleben gestaltet.“  Oder anders ausgedrückt, Hypnose versucht mittels Interventionstechniken die Aufmerksamkeit so stark zu bündeln (siehe auch obiges Zitat), dass ein neuer Ordnungsparameter entsteht, der neue Lösungsräume eröffnet. Die Interventionstechniken helfen als Rahmen- und vor allem Kontrollparameter von derzeitigen Problem-Ordnungsparametern zu neuen Lösungs-Ordnungsparametern zu wechseln. Das Buch von Schmidt erläutert zum einen diesen Zusammenhang und zum anderen vor allem die vielen möglichen vom Kontext abhängigen Interventionstechniken, um Aufmerksamkeit und Fokus zu erzeugen.

Der Zusammenhang zum Agile Management 4.0 [4] ist jetzt vielleicht schon fast greifbar. Ich wende das obige Zitat zum „Attraktokraftfeld“ auf den agilen Handlungsrahmen Scrum an, in dem ich einige Wortersetzungen mache:

„Es soll erreicht werden, dass Development Team und Produkt Owner mit Hilfe des Scrum Masters ihre Aufmerksamkeit so intensiv als irgend möglich … auf die kontext-angemessene Produktvision fokussieren können. So soll eine Art Attraktorkraftfeld für das Lösungserleben (für alle Stakeholder) geschaffen werden, das immer stärker („Schneeballeffekt“) Feedbackschleifen unterstützt, die wieder das Kraftfeld des Lösungserlebens (für alle Stakeholder) weiter verstärken.“

Ich glaube, dass damit der Zusammenhang von systemischer Hypnotherapie und Agile Management 4.0 greifbar wird. Tatsächlich findet man in Schmidt’s Buch unzählige Beispiele, die im Management 4.0 ihre Entsprechung haben. – Er selbst wendet seine Erfahrungen und Erkenntnisse auf Teams und Organisationen an; sehr ähnlich zu den im Management 4.0 praktizierten.

Auf dieser Basis wird auch sehr schnell verständlich, warum viele agile Handlungsrahmen in Theorie und Praxis nur wenig mit Selbstorganisation, die Hochleistung ermöglicht, zu tun haben: Den agilen Führungskräften wie z.B. Product Owner und Scrum Master fehlt meistens die Kompetenz, für Aufmerksamkeit und Fokus zu sorgen; also ihre Interventionen so zu gestalten, dass sich eine Produktvision, also der Ordnungsparameter, aus dem Team für alle Stakeholder selbstorganisiert entwickelt. – Management 4.0 und damit Agilität, haben also viel mehr mit hypnosystemischer Arbeit zu tun, als mit dem vorgegebenen „korrekten“ Ausführen von Agilen Handlungsrahmen.  – Aus diesem Grunde sind die agilen Techniken der unwichtigste Faktor unter den wichtigen Faktoren: Das Verständnis für die Wirkzusammenhänge der Selbstorganisation ist hundertmal wichtiger, das Mindset ist sogar tausendmal wichtiger!   

[1] Schmidt G (2017) Liebesaffären zwischen Problem und Lösung, Hypnosystemisches Arbeiten in schwierigen Kontexten, Hypnotherapie, systemische Therapie, Beratung, 7. Auflage (1. Auflage von 2004), Carl-Auer-Systeme Verlag, Heidelberg

[2] Wikipedia (2019a) https://de.wikipedia.org/wiki/Gunther_Schmidt_(Mediziner), zugegriffen am 30.04.2019

[3] Mohl A (2010) Der große Zauberlehrling. Das NLP-Arbeitsbuch für Lernende und Anwender. Teil 1 und Teil 2. Junfermann Verlag

[4] Oswald A, Müller W (Hrsg.) (2019) Management 4.0 – Handbook for Agile Practices, Release 3.0“, BoD, Norderstedt

[5] Oswald A, Köhler J, Schmitt R. (2017) Projektmanagement am Rande des Chaos, 2. Auflage, Springer, Heidelberg, auch in Englisch verfügbar: Project Management at the Edge of Chaos (2018), Springer, Heidelberg

[6] Haken H, Schiepek G (2010) Synergetik in der Psychologie: Selbstorganisation verstehen und gestalten. Hogrefe-Verlag, Göttingen